Adrianistán (5), Adrián Perales (10), La Página Definitiva (10), otro blog más (10), Página de inicio on Un sitio solicitado por la comunidad, para la comunidad (11)

2026-10-01

Mi iPhone SE sigue aguantando (Adrián Perales)

Me alegra decir que mi iPhone SE 3 de 2022 seguirá dando guerra una temporada más.

En primer lugar, la batería (que he dos veces por una no oficial) vuelve a cargar al 100% y aguanta todo el día sin despeinarse. Por algún motivo solo se cargaba hasta el 90% y se descargaba con respirar cerca. Este cambio llegó solito con la actualización a iOS 27, así que la mejora de rendimiento es real y perceptible en este teléfono.

Por otro lado, la interfaz de muchas aplicaciones y de Liquid Glass en particular no están preparadas para una pantalla tan pequeña. Recordemos que los teléfonos ahora mismo son zapatófonos y que este tiene una pantalla de 4 pulgadas y pico. Incluso los avisos de cookies de algunas webs no entran en tan poco espacio.

La pantalla no la puedo hacer más grande, pero recordé la opción para que todo se viera más grande. Fui a «Ajustes, Aspecto, Zoom de pantalla». Lo tenía puesto en «Texto más grande». En «Por omisión» los elementos de la interfaz son más pequeños, con lo que se gana bastante espacio. El texto también, claro, pero yo sigo viendo igual de poco. Por suerte, iOS permite configurar el tamaño de texto por aplicación y he podido aumentarlo en aquellas que necesito ver bien en la calle sin ayudas visuales (mensajería, sobre todo).

Me estaba planteando muy fuerte renovar el iPhone porque la batería duraba muy poco y porque la pantalla se había quedado claramente pequeña para el espacio que ocupaba la interfaz. Por suerte, con estos cambios y ajustes la situación ha mejorado bastante y ahora mismo no me planteo ese cambio.

En este momento, en el que los iPhone están a un precio exagerado y no tienen TouchID, y en el que no me apetece nada cambiar a Android, me alegra decir que le sacaré a mi pequeñajo no solo un quinto año (hasta marzo del 27), sino alguno más.

Es más, no sé cuánto le quedará a mi Apple Watch Series 6 (tiene seis años encima, la pantalla cascada desde hace cuatro, un 76% de capacidad de batería y ya no recibe nuevas del SO), pero procuraré aguantarlo también un tiempecito más.

Con la renovación del iPad, Apple se ha llevado bastante pasta por mi parte para una temporada.

2026-09-29

He renovado el iPad y me da igual (Adrián Perales)

Creo que el título es bastante descriptivo. Si no te interesan las batallitas tecnológicas puedes saltarte esta entrada, porque la dedico a dar muchos detalles totalmente innecesarios sobre un cambio de aparato que, al final, no me ha producido ningún tipo de satisfacción particular.

Las tablets y yo

Cuando empecé a trabajar compré un cuaderno para docentes en papel. Por mi problema de vista me era muy incómodo, así que pensé en un sistema de gestión docente en digital. En ese momento descubrí que las tabletas podían ser más que un juguete, un aparato para el ocio. Por entonces tenía una tableta Android (una BQ) y usé Additio App.

Cuando me dio el apretón burgués por pasarme a Apple, compré el iPad Pro de 10,5 pulgadas y pronto me pasé a iDoceo, una aplicación que me pareció claramente superior en todos los aspectos. De compra única, sin sincronización (creo que Additio App no funciona sin ella) y mucho más completa por entonces.

iDoceo se convirtió en una poderosa razón para que no me planteara salir de iPad cuando mi Pro se quedara viejito. Podría pasarme al cuaderno Séneca, la herramienta oficial que nos ofrece la Junta, pero su uso me parece tan ortopédico en comparación que no me merece la pena la investión de tiempo a menos que me obliguen.

El iPad viejito

El cacharro me ha durado sus buenos diez años. La pantalla ya amarillea por los bordes y tiene hundidas las partes donde más toco, pero la razón para cambiarlo no es esa.

Es mi principal herramienta de trabajo y el cacharro deja de recibir soporte oficial. No quiero ir con los datos de mi alumnado en un aparato no soportado, por más que funcione perfectamente con su iPadOS 17.

Incluso la batería, que en momentos pensé que me duraba demasiado poco, aguanta bien las sesiones de trabajo tan duras: si se drenaba más rápido es porque la conectaba mucho rato a una pizarra digital.

El iPad nuevo

Ahora mismo me duele donde la cartera porque he comprado un iPad Air M4.

Almacenamiento base de 128 GB. El anterior tenía 64 y ya me sobraba espacio porque no sincronizo prácticamente nada. El principal uso del tiesto es el trabajo, basta ir con lo mínimo. Ahora mismo, con lo necesario para mi día a día, me sobran 70 GB. Pero incluso aunque me descargara todos los vídeos que uso apra las clases me sobrarían más de 40.

Todo lo demás sigue exactamente igual. El cacharro llegó y lo configuré desde cero para no arrastrar posibles residuos de una copia de seguridad. Tardé mi buen rato por la manía de usar servicios descentralizados en vez de dejarlo todo en manos de iCloud, pero tras una tarde ya tenía el Air igualito al Pro.

Todo sigue igual

Y solté el cacharro. Y volví a cogerlo cuando quise leer algún artículo online o ver algún capítulo. Nada de trastear con Apple Inteligence, nada de probar juegos potentes, nada de mirar qué opciones trae iPadOS 26 con respecto a la versión 17. En el momento de escribir estas líneas ni siquiera lo he actualizado a la nueva versión del SO hasta que saquen la 27.1.

Lo único que me interesa es usar las apps que ya usaba, pero ahora en un cacharro soportado.

Y esto es una novedad para mí. No tener ilusión por un cacharro nuevo me demuestra que la tecnología se ha convertido en un medio, no en un fin.

Esta es la conclusión del artículo. Puedes saltarte el siguiente apartado si no te interesan aún más detalles estúpidos.

Accesorios

Cuando compré el Pro el bolsillo me dolió bastante más, porque me vine con unos Beats Solo (creo que eran regalados, ya los he tirado porque dejaron de escucahrse por un lado), un Apple Pencil de primera generación y una funda Smart Keyboard.

El Apple Pencil se me perdió. Compré otro, de segunda mano. Volvió a perderse. Por circunstancias tengo un Apple Pencil de segunda generación (en este no gasté), que no era compatible ni con mi iPad anterior ni lo es con el nuevo.

Y como el lápiz es útil en según qué momentos, he comprado un Apple Pencil Pro aprovechando una tarjeta regalo que me han dado por usar una oferta educativa. Sé perfectamente que es un gancho para gastar más y es precisamente lo que he hecho, pero mira, qué le vamos a hacer.

Donde sí que no vuelvo a picar más es con la funda-teclado. El Smart Keyboard me encantaba, y lo renové varias veces. Luego me di cuenta de que, muy seguramente, lo que fallaba no era la funda en sí sino el conector de la tableta, y quizá me hubiera ahorrado un buen dinero si lo hubiera pensado antes.

El caso es que las nuevas fundas-teclado de Apple, además de ser obscenamente caras, integran touchpad. Y yo no quiero touchpad en mi tableta porque me alejan de la pantalla, una de las principales razones de que no ordenador porátil muy a menudo. Por mi problema de vista yo necesito (y quiero) estar cerca de la pantalla.

La solución ha sido comprar una funda cualquiera para proteger el tiesto de golpes y un teclado aparte.

He estado un tiempo con un teclado eSynic plegable que ya usaba por último con mi iPad Pro. Un teclado que compré también por capricho para usarlo con el teléfono en ciertos momentos, unos momentos que nunca llegaron. Lo tenía en el cajón y encontró su uso con el iPad cuando llegué a esta increíble revelación. Lo he usado hasta que varias teclas de la parte izquierda han dejado de funcionar. Ahora he comprado un Logitech K380s que espero que dure bastante más, un teclado con muy buena fama.

No quiero ni pensar el dineral que me dejé entre fundas-teclado y lápices. Este soy yo fustigándome, algo que me encanta (nótese la ironía), pero ya está hecho y ya no más. El lápiz nuevo se queda en casa para que no se pierda, que al final es donde más lo aprovecho, y jamás compraré de nuevo un teclado específico de Apple. Ya me han timado suficiente.

En fin

Vuelvo al principio. He cambiado el iPad por (lo que yo considero) necesidad, porque podría haber seguido con el antiguo sin mayor drama. Y ya me el afán consumista de renovar accesorios se pasó. He llegado a ese punto en el que la tecnología se ha convertido en un medio para mi ocio o mi trabajo, y mi cuasi indiferencia ante esta renovación es claro indicativo de ello.

Ahora mismo quiero aprovechar los aparatos que tengo en la medida de lo posible, y espero que este iPad, el teclado y el lápiz me duern todo lo posible, para no plantearme el cambio, al menos del cacharro principal, hasta dentro de otros diez años. Espero que Apple le dé soporte durante mucho tiempo.

2026-09-28

La información pública de la Gene (y Twitter) (otro blog más)

#pataleta

(Espero que otras administraciones públicas lo hagan mejor y que esto solo sea de interés en el área de Cataluña. Aunque no me jugaría dinero.)

La historia: veo algún titular sobre precipitaciones intensas mañana y que la Generalitat ha publicado alguna alerta, o sea que me voy a mi recurso sobre el tema: beteve.cat/temps-barcelona (barceloneses y allegados, esta es vuestra página del tiempo, creedme), y allí me encuentro un titular que me lleva a una noticia…

betevé ha decidido incrustar el tuit de @meteocat. Como podéis ver (como no podéis ver, de hecho, al menos si tenéis mi vista y no hacéis zoom), el texto de las imágenes incrustadas en el tuit es demasiado pequeño como para leerse en el incrustado, o sea que… clic, y

Algo hemos ganado, que ya podemos leer (aguzando la vista) los textos de las imágenes, pero casi mejor hacer clic en ellas para leer con comodidad, convendréis. Y entonces…

Que si quieres arroz, Catalina, y que si quieres ver las imágenes a la resolución original, que te des de alta en un servicio privado con ánimo de lucro. El servicio podría ser propiedad de mi mejor amigo y no me parecería de ley. El servicio pertenece a Elon Musk.

(Esto no lo he comprobado porque no me da la gana hacer log in en Twitter, pero me parece que las imágenes incrustadas por la cuenta de Twitter no tienen texto alternativo y, por tanto, no son accesibles para una persona con discapacidad visual. Espero de todo corazón equivocarme y que el Meteocat no se esté saltando la ley.)

Pero claro, César, no me seas bruto: no te están obligando a hacer log in en el servicio de Meloncete, seguro que el Meteocat publica su información de servicio público en su web meteo.cat, que para eso está. Y es así, PERO.

¿Veis el gráfico (bastante currado, debe decirse) que había en Twitter? ¿Veis el texto destacado hablando de una situación meteorológica de peligro en las próximas horas? No, eso es para quienes tengan una cuenta de Twitter. (En la captura os he hecho ya clic en mañana en el mapa de avisos, porque si no, el naranja de media Cataluña mañana no se vería.)

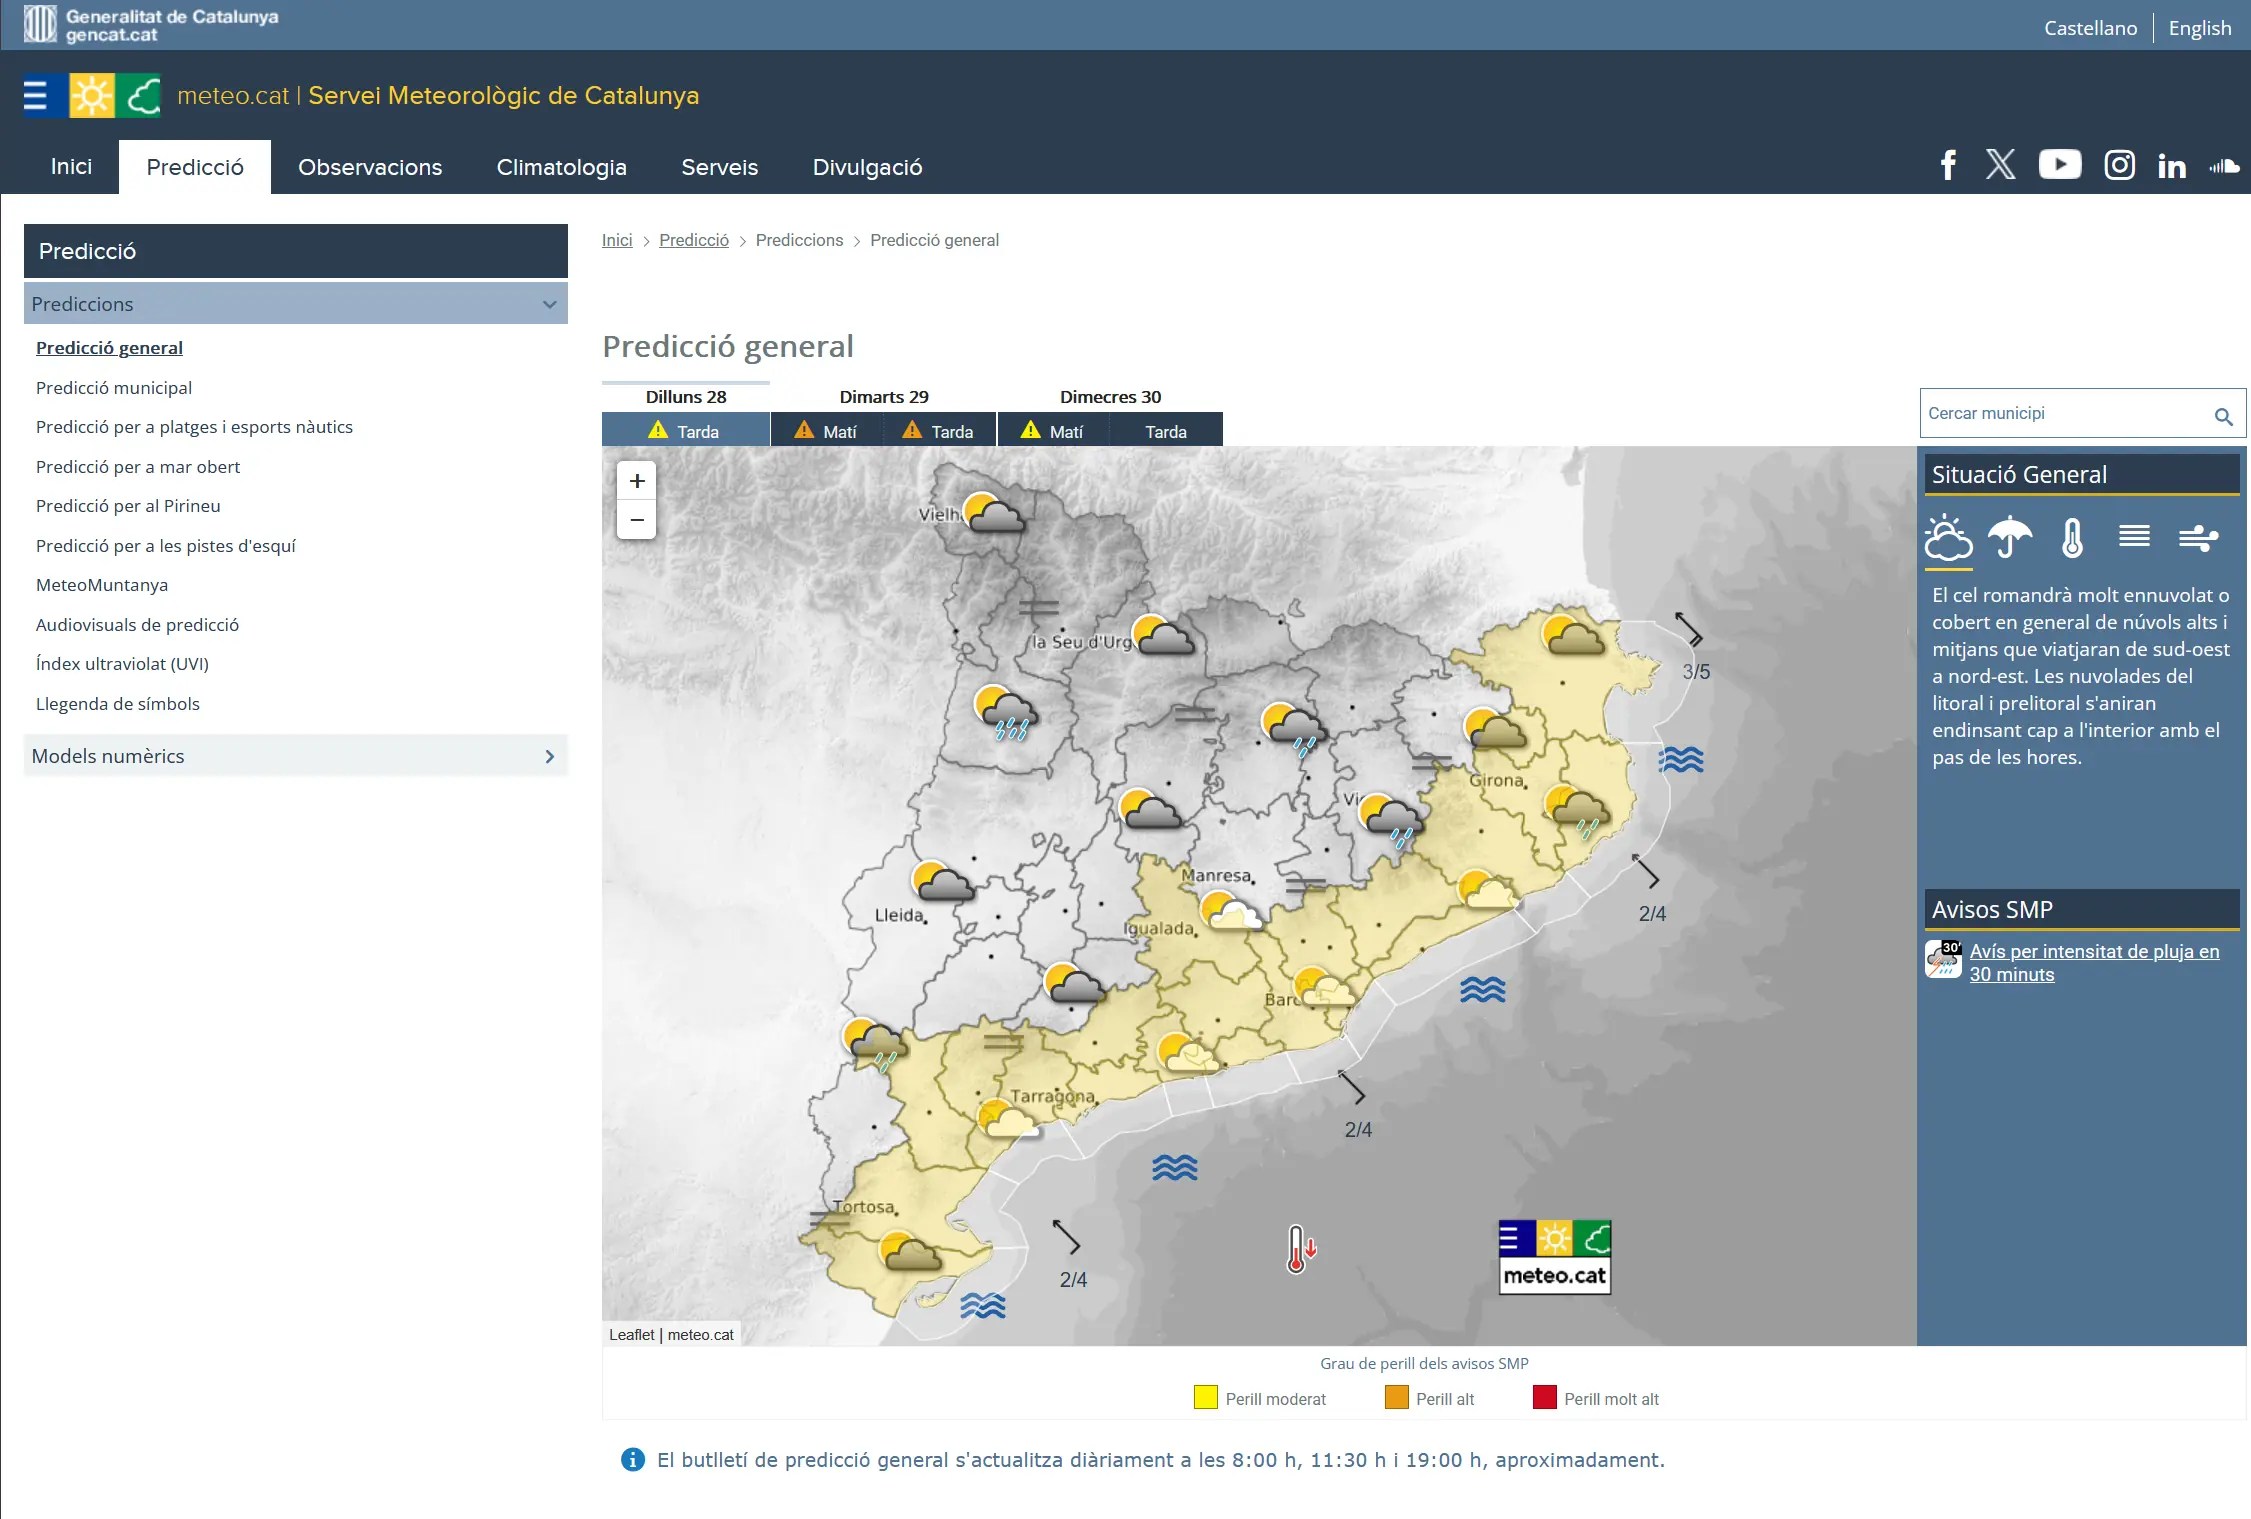
Pero no me seas tonto, y haz clic en el mapa, que nos lleva a meteo.cat/prediccio/general:

La página contiene la información, sí, y hay unos triangulitos naranja para que veamos que hay avisos. Y si hacéis clic en los triangulitos naranja, llegaréis a la página con la previsión de mañana, y allí podréis hacer clic en el aviso, y llegar, finalmente, a

Las imágenes de resumen publicadas en Twitter, eso sí, no las he sabido encontrar :-S.

Por aquello de ir cerrando:

  1. A mí me parece bien razonable que el meteocat tenga cuenta en Twitter (y en Facebook y en Instagram). Hay muchísima gente en esas plataformas, y acudir a la gente es lo que creo que deberían hacer los servicios públicos. Aunque quizás estaría bien que hubiese un mastodon.gencat.cat y que tuviésemos un canal de microblogging para cada servicio de la Generalitat, comenzando por @meteocat (y lo mismo aplica a todas las administraciones públicas de un cierto tamaño). Pero lo que no puede ser es que el esfuerzo que se dedica a comunicar en esas plataformas privadas no se lleve a todos los lugares posibles. Especialmente si Twitter no me permite acceder cómodamente a la información sin registrame ni hacer log in.
  2. La página de meteo.cat contiene muchísima información muy útil, pero igual estaría bien darle un lavado de cara y aprovechar para reservar un lugar destacado en portada para los avisos de situaciones meteorológicas potencialmente peligrosas. Digo yo.

En fin, disculpen el rant de señor mayor 🙏.

2026-09-27

#breBytes Educación en línea, 1986 (otro blog más)

No puedo cerrar los #breBytes de septiembre de 1986 sin pararme aunque sea un minuto en la editorial de la revista…

Ya habíamos hablado brevemente de educación en línea en 1986 en el último post dedicado a las Computer Chronicles, de este mismo mes, pero es maravilloso leer cómo, desde la revista, se animaba a las universidades al mundo del online, hablando de ruralidad, formación continua y lifelong learning, entre otros aspectos :-)

2026-09-24

Superado por las noticias sobre IA (Adrián Perales)

A primeros de mes me tomé uno de mis descansos periódicos del fediverso, y una razón para ello fueron las constantes noticias sobre inteligencia artificial generativa. Como usuario me veo muy impotente e incluso perdido ante ellas porque no tengo el tiempo ni las ganas de valorar todo lo que implican.

Aclaraciones previas

Para que todo estemos en la misma página, unos párrafos introductorios como si esto fuera el antiguo Twitter.

Primero. En este texto hablaré de «IA» por pura comodidad. Podría usar IAgen (por IA generativa) o LLM (aunque no sé si modelos de generación de imágenes lo son). Dado que el texto se refiere únicamente a este tipo de modelos, se me permitirá la imprecisión.

Segundo. Este texto está escrito por un aficionado a la tecnología y partidario del software libre, pero también por alguien que lidia con muchas contradicciones. Hace tiempo que renuncié a ser consecuente con mi uso de la tecnología, si alguna vez lo busqué.

Tercero. No tengo una opinión fuerte sobre muchos asuntos porque no entiendo ni tengo las ganas de entender todas sus implicaciones. Este texto es, precisamente, una manera de expresar mis dudas y pensamientos al respecto.

La IA y yo

La única vez que he hablado de manera extensa sobre el tema en mis espacios fue en enero de 2024. Una eternidad a efectos tecnológicos, pero aún dura el empuje y no tiene visos de detenerse. Las noticias o las críticas sobre la implantación de IA son constantes.

Por entonces no había probado ninguno de los modelos más populares. Más de dos años y medio después, he usado varios y la IA forma parte de mi repertorio de herramientas comunes. Las que usé y uso con más frecuencia son las siguientes:

  • Perplexity para hacer búsquedas ya que proporciona enlaces de donde saca la información. Dejé de usarlo porque lo limitaron muchísimo sin cuenta, y no tengo interés en registrarme.
  • Duck.ai la uso bastante porque no requiere cuenta. Lo uso para hacer preguntas o búsquedas. Recientemente han limitado también su uso (no sé si por exigencias de los modelos originales) así que no sé cuánto tiempo duraré.
  • Bevel Intelligence, integrada en la app Bevel que uso para todo lo relativo a nutrición, ejercicio y salud. Jamás gasto los créditos pero sí diría que la uso bastante para interactuar con mis métricas. No sé cómo se guardan los datos pero como haya una brecha de seguridad será una fiesta.
  • Gemini para el trabajo. Las cuentas Google de la Junta de Andalucía tienen acceso a Gemini Pro. Lo he usado para generar textos con ciertas características cuando no soy capaz de encontrar uno que me sirva, para pedir ideas ante ciertas situaciones y para adaptar ejercicios para cierto alumnado con necesidades educativas.

Diría que mi uso es anecdótico en comparación con ciertos perfiles que me cruzo en las redes y fuera de ellas. Por ejemplo, de momento no la he usado para generar imágenes, y me molesta cuando sé que alguien hace imágenes con IA para enviármelas expresamente a mí.

¿Me molesta ver y que me pasen imágenes claramente generadas con IA cuando yo uso dicha tecnología en ocasiones? Sí. Sumemos contradicciones.

Sé que la IA tiene muchos problemas pero, como tantos aspectos en mi vida, soy pragmático. Por ejemplo, hacer una búsqueda hoy supone dedicar un tiempo que a veces no quiero emplear en eso, o es demasiado específica para encontrar respuestas en una búsqueda habitual. Igual que sigo con productos Apple por conveniencia, aunque me parezca una empresa horrible en muchos aspectos, no renegaré de la IA cuando sienta que me ayudará en mi día a día.

Es curioso que el SEO que salvaría muchas webs ha sido la herramienta para fastidiar los buscadores normales y hoy en día se habla de GEO o AIO, puesto que el objetivo es que los resúmenes por IA que aparecen en buscadores como Google use la información de una web en lugar de otra.

Mientras escribía estas líneas me he dado cuenta de que mi uso de la IA es como herramienta auxiliar. Diría que, salvo ciertos textos para alguna actividad específica en clase, nunca he compartido nada generado directamente por una IA. ¿Es este uso más válido que otros? De verdad que no lo sé.

No me gusta la IA

Una vez establecido que no soy un ser de luz que reniega de la IA con la fuerza de mil soles, dejemos algo claro.

Los problemas de la IA son evidentes. El consumo energético, la necesidad de infraestructura y el total desprecio a los derechos de autor son problemas imposibles de aceptar como inevitables o necesarios, y son problemas que la gente lista debe poner sobre la mesa. Pero no son los únicos.

La IA se usa en procesos creativos no solo como una herramienta auxiliar, para tener ideas o revisar un texto. Muchas personas, empresas e instituciones la usan para reemplazar algo tan humano como es la creatividad, una tarea que la IA, por lo general, no hace bien. Muchas (muchísimas) imágenes generadas con estos modelos tienen ese «tufillo a IA» tan característico, un «tufillo a IA» que en realidad es un estilo robado a otros tantos autores.

Vemos continuamente carteles generados con IA, miniaturas en YouTube generadas por IA (todas iguales), los estudios de videojuegos usan recursos generados por IA que llegan a la versión final, ya hay series y películas que usan planos generados por IA, incluso se ha estrenado una película de animación (horrible, al parecer) generada entera con IA. Incluso Amazon tuvo que limitar el número de libros publicados por la cantidad de títulos generados con IA que les llegaba.

¿Y a quién corresponde el copyright de esa obra generada mediante un modelo que ha sido entrenado con millones de obras? «Una IA crea igual que un humano», pero un humano no se entrena con millones de obras culturales metidas con embudo para enriquecer a una gran empresa que ignora el copyright. Muchos autores hablan de sus influencias en sus entrevistas: ¿cuál es la influencia de una obra generada con IA?

Pero vamos más allá.

La IA de Elon Musk, Grok, fue usada para generar imágenes sexuales de mujeres y niñas. Cuando el asunto saltó a la palestra, su solución fue poner la generación de imágenes tras un muro de pago.

Muchas personas usan una IA en lugar de ir a psicólogo. En lugares como España, los de la seguridad social son inaccesibles; los privados, caros. Una máquina complaciente que se inventa datos se ha convertido ya en el soporte emocional de muchas personas.

Ya ocurre que muchas personas comprueban las indicaciones de un farmacéutico en uno de estos motores. Verás las risas cuando la IA recomiende antidepresivos o cualquier producto que patrocine el motor.

Intereses espurios

El mayor problema es el que la tecnología arrastra en las últimas décadas. Este gran avance tecnológico nace con el único objetivo de monetizar. De crear dependencia. De ser una herramienta imprescindible más para captar datos de sus usuarios y seguir con su mercantilización.

Nótese que OpenIA tiene «Open» en su nombre porque en un principio quería hacer modelos «abiertos». Hoy forman parte de Microsoft. Los del software libre tenían razón cuando criticaban el concepto «open source». Tenían razón, como siempre, como en todo.

Cuando mucha gente ya depende de la IA para hacer su trabajo (porque aumenta la productividad pero jamás el tiempo libre que ese aumento facilita), las tecnológicas reducen el tiempo que puedes usar sus modelos y aumentan los precios. Un plan perfecto ya clásico: la primera dosis es gratis, luego toca pasar por caja.

Alán Barroso, en su ensayo ‘Civilización o barbarie’, hace un análisis de la tecnología actual y se detiene en la IA durante varias páginas. Una de las ideas que lanza y que no me he cruzado en otros lugares es que esta tecnología podría usarse para el bien. Para gestionar los recursos de tal modo que cada persona reciba lo que necesita, en base a la ingente cantidad de datos que ya poseen las tecnoógicas. Pero para eso haría falta una IA gestionada por personas que mirasen más allá de su propio bolsillo y el de sus accionistas. No es el caso.

Los modelos en local con mayor respeto a la privacidad parecen una utopía, y aún entonces habría que ver con qué material son entrenados. Porque, por lo visto, si una IA no se entrena con una ingente cantidad de datos parece virtualmente inútil. Ya te guardarías tú de piratear una película o una serie (LaLiga corta medio internet porque hay alguien que piratea partidos de fútbol), pero si eres una gran tecnológica que usa cualquier material protegido para entrenar su IA, no pasa nada. A ver quién se mete con una gran tecnológica. Una multita de unos milloncejos y a seguir con el negocio, como llevan décadas haciendo.

Últimamente todo tiene que llevar IA. Un caso que ha llegado a mi correo, muy simpático, es el de The Noun Project, un lugar donde descargar iconos en blanco y negro. Añaden un generador de iconos mediante IA pero eh, en los términos dice que solo podrás subir iconos creador por un ser humano. Pero el generador te lo venden igual.

Impotencia

Aun siendo consciente de todos estos problemas y aun lidiando con la contradicción de que yo mismo la uso (inserte aquí discurso sobre el sistema obligándonos a elegir lo «menos malo»), ver que más y más proyectos introducen IA en su producto o en su proceso de trabajo genera mucha impotencia como usuario.

La IA aparece en cada vez más realidades de nuestro día a día, y la estrategia de meter la cabeza en la arena no parece factible. A nivel individual podemos tomar la decisión de no usar estos modelos, o de usarlos poco. Pero, ¿y todo lo demás? ¿Cuando veas una película que meta una escena generada con IA sin previo aviso? ¿Ese cartel de tu pueblo generado por IA? ¿Esa canción que Spotify te pone en una playlist para no pagar a aritstas?

¿Hasta cuándo podemos huir? ¿De verdad reventará de la burbuja de IA y se dejará de usar en cuestiones creativas?

Pero lo que más me supera es cuando la IA llega a la programación de software libre. Si yo, simple usuario y persona cada vez más cansada, soy capaz de vez sus problemas, ¿cómo puede ser que un programador de software libre introduzca la IA en su flujo de trabajo? Y los usuarios, ¿qué hacemos ante esto?

Un caso con un tiempo es el de KeePassXC admitiendo que usará la IA. Linus Torvalds tampoco es tajante con el tema, y Debian ha decidido actuar en los mismos términos. Incluso GrapheneOS, la distribución de Andorid más conocida por su privacidad y seguridad, admite que usa IA para detectar y corregir vulnerabilidades. En todos los casos, entiendo, el código generado mediante IA pasa por un estricto proceso de revisión.

¿Es lícito este uso de la IA como herramienta auxiliar, a pesar de los problemas tan graves que traen consigo los modelos comerciales? Si el código generado pasa por una exhaustiva revisión humana, ¿es censurable su uso?

No me parece realista escapar de uno de los mejores gestores de contraseñas en local, ni de una de las distribuciones más importantes del software libre (en la que se basa la que uso actualmente), del sistema móvil más seguro, y menos aún del kernel.

¿Qué podemos hacer los usuarios informados? Yo solo veo una respuesta. Resignarnos. Buscar alternativa a cada una de las herramietnas que incluyen o son permisivos con la IA me parece inviable por el tiempo y el esfuerzo que implica. Tan solo me queda la idea de «algo es mejor que nada»: es algo evitar alguna de esas herramientas. Pero son muy poquitas.

Mira el listado Open slopware. Mira qué cantidad de proyectos. Ni siquiera quienes mantienen la lista son capaces de nombrar alternativas a todo.

Estoy cansado, jefe

Entiendo que esta IA, aunque muchas personas digan que no es realmente inteligencia, es revolucionaria y que ofrece una cantidad de posibilidades que yo, en mi cansancio y mi cerrazón, ni siquiera soy capaz de ver. Tampoco necesito verlas para mejorar mi día a día. Pero sí veo sus problemas.

Me decepciona que tantos proyectos de software libre acojan la IA, pero pienso que tendrán sus buenas razones. Supongo que todo se limita a «los desarrolladores ya la usan y no podemos negar esa realidad». No sé qué pensar, no sé cómo reaccionar, y no creo que haya respuestas sencillas en este punto.

Lo que tengo claro es que no buscaré alternativas a cada proyecto que anuncia el uso de IA. No tengo el tiempo ni las energías.

Es una batalla más entre gigantes en la que los usuarios somo podemos mirar desde la barrera esperando que los golpes que nos llegan no sean demasiado fuertes. Mientras, algunos gritan que nos metamos en la pelea.

Esto ni siquiera es la titánica tarea de decirles a tus contactos que te agreguen a DeltaChat (¿usará IA DeltaChat?). Es renegar del kernel de tu sistema operativo libre y de un montón de programas por usar una tecnología tan problemática. Es descorazonador, es agotador y crea mucha impotencia.

2026-09-20

Computer Chronicles, septiembre del 86 (otro blog más)

Llevábamos tiempo sin tocar las narices con las Computer Chronicles de Stewart Cheifet y llega el momento de viajar cuarenta años hacia atrás en el tiempo para repasar la historia no tan lejana de la informática…

Comenzamos con los dos primeros episodios de septiembre de 1986, que se centran en el uso de la informática en educación. Arrancamos en un cole (curiosamente, de Cupertino) al que Apple había dotado de unos cuantos Apple II para que cada estudiante tuviese uno (sin entrar en muchos detalles), para luego tener una demo del estado del arte de la época del software educativo de la época. Curioso que ya por entonces, cuando el periodista pregunta si se ha hecho algún tipo de diseño experimental para medir la efectividad del uso de la informática en las escuelas, no hay mucha respuesta, precisamente… Afortunadamente, en la siguiente entrevista hay algo más de reflexión antes del uso ciego de la tecnología. Como solemos decir por aquí, hace cuarenta años estábamos mucho más cerca de cómo estamos hoy de lo que creemos… (En los breves del final del programa, y en esa misma línea, Apple estaba intentando detectar por dónde se les filtraban los nuevos desarrollos a la prensa 😬.)

En el segundo episodio temático, nos pasamos del uso educativo del ordenador en las escuelas a su uso en casa, entre otras cosas para matricularse en educación universitaria en línea 🙀, o el uso de un Amiga (claro) para consultar recursos multimedia almacenados en LaserDisc. Y en los breves del final, noticias sobre interfaces cerebro-ordenador (sí, hace cuarenta años), y el uso de la red francesa de Minitel para usos ilícitos no anticipados, entre otras…

Y en el tercer y último episodio del mes nos encontramos con el que tiene que ser el estándar más longevo de la informática: MIDI, que básicamente sigue siendo el mismo hoy que ya era en 1986 (y una de las pocas cosas en las que el Atari ST era superior al Amiga). Y de regalo podréis ver cómo eran las DAWs de la época, para el ST, el Amiga… e incluso el Apple IIGS1, y unas cuantas más de las aplicaciones musicales de la época. En los breves, el primer piloto para hacer la declaración de la renta digitalmente en los Estados Unidos.

Y eso es todo por septiembre. Amenazamos con volver el mes que viene. Si queréis avanzaros con los deberes, podéis acudir tanto a la lista de episodios de la Wikipedia como a la playlist a la que pertenecen los vídeos de YouTube que tenéis aquí arriba.


  1. Hace un par de meses nos quejábamos por aquí de lo perdida que iba Commodore cuando lanzó su 128 en vez de dedicar todos sus recursos al Amiga. El IIGS sería el equivalente de Apple… pero no tuvo los mismos efectos devastadores en Cupertino. ↩︎

2026-09-17

Una mirada al curso que empieza (Adrián Perales)

Al contrario que la gran mayoría de entradas de este blog, este texto se publica justo después de su escritura. Y es que hoy, tras dos días de clase habitual, es buen momento para alzar la mirada al curso que empieza.

Lo cierto es que casi todo parecen buenas noticias. Instituto a diez minutos de casa y el primer contacto con el alumnado ha sido muy positivo.

Ese «casi» viene por varios motivos. Primero: me encargo de mucho alumnado, lo cual alarga las horas de revisión de trabajos y exámenes. Segundo: me estreno con un nivel que no he impartido nunca, lo cual supondrá mucho trabajo de preparación. Tercero: mi horario es horrible (al menos de momento, no sé si lo cambiarán). Todos los días entro a primera, cuatro salgo a última y tengo mucho hueco entre medias. El mal horario le tiene que tocar a alguien y me ha tocado a mí, qué le vamos a hacer.

Por otro lado, sigo en la academia de inglés en otro municipio, que además me cuadra con días en los que salgo tarde (normal, ¡son cuatro de cinco!). Trabajo, salir tarde, tren, academia y vuelta supone un desgaste físico y mental importante, pero ya he pagado el examen por lo que la fecha tope está lejos y cerca a la vez. Serán semanas muy intensas, pero después volveré al ritmo habitual. Es un sacrificio acotado en el tiempo y puede significar una mejora laboral importante en el futuro.

Por último, diría que este curso ya tengo mis herramientas bien engrasadas para afrontar los bajones de ánimos, que vendrán. El balance del curso pasado fue bastante positivo, y este espero gestionarlo aún mejor. No se trata de estar bien siempre pero sí de que el malestar no me incapacite para todo lo demás.

En definitiva, se plantea un curso tranquilo, en el que espero gestionar mis ánimos aún mejor, pero con nuevos retos por ese nivel en el que me estreno y por un primer mes bastante estresante entre el horario y la academia de inglés.

Veremos qué tal lo gestiono todo. Seguramente en navidad volveré a escribir sobre el tema.

2026-09-10

Una visita al verano que termina (Adrián Perales)

Este es un momento tan bueno como cualquier otro para echar la vista atrás y contar qué tal me ha ido el verano.

Un julio muy atareado

Aunque en julio estamos a disposición de la administración, este mes no me han llamado del trabajo y he podido dedicarlo a mí. Aunque el curso estuvo bien cargado de trabajo, lo terminé muy bien de ánimos, lo cual me permitió afrontar el mes con ganas. Y vaya si lo hice.

Con vistas a mejorar en mi trabajo, una de las primeras decisiones que tomé fue sacarme el B2 de inglés. Tiene su explicación pero no la contaré aquí. Llamé a varias academias de mi municipio, ninguna me dio opciones y acabé en una de otra localidad, un lugar donde viví en cursos anteriores y una academia donde ya me prepararon para el B1 que saqué por puro gusto personal. Así que estuve todo el mes de julio yendo dos días en semana a otro municipio para practicar inglés.

Como debo tener algún punto masoquista, me preparo para Cambridge, que tiene fama de ser más dura que otras instituciones oficiales. Lo que tenía y tengo claro es que no quiero dedicar mucho tiempo a este tema, y ya tengo pagado el examen para octubre.

Interludio. A ese otro municipio debo ir en Cercanías. Absolutamente todos los días del mes el tren llegaba tarde porque a la misma hora había programado un Media Distancia. ¿Por qué había anunciada una hora de salida que coincidía con otro tren? A saber. El caso es que siempre debía acelerar el paso para no llegar a la academia mucho más tarde de la hora, porque tarde llegaba sí o sí.

Dado que este verano no había programado ningún viaje con amigos, decidí dedicarlo a ciertas tareas personales que llevaba tiempo posponiendo. El curso escolar prácticamente me inhabilita para vivir (es una exageración, pero entre bajones de ánimo y las exigencias diarias no doy para mucho más), por lo que ciertas tareas llevaban apuntadas varios años. Este fue el mes de darles su lugar.

Además, me propuse ir a la playa sí o sí una vez por semana. Para cualquiera que viva lejos de la costa será sacrilegio porque yo la tengo muy cerca, pero es un objetivo que debo marcarme. Y aunque finalmente no he ido tanto como me hubiera gustado porque en julio hacía demasiado calor y en agosto me puse malito (más sobre eso a continuación), sí diría que he ido más veces que otros años.

Y para rematar, ejercicio. Además del entrenador personal una vez por semana, caminatas (alguna de hasta catorce kilómetros), bici estática (algunos entrenamientos hasta de cuarenta y cinco minutos) y fuerza (calentamiento y dos sesiones completas por semana como mínimo). Un contraste brutal con respecto a junio, donde estuve inactivo por la carga de trabajo. No me pararon ni las olas de calor: salía a caminar como muy tarde a las ocho de la mañana porque a las diez ya no se podía estar en la calle.

Un agosto más tranquilo

Después del frenetismo del mes de julio, era inevitable bajar el ritmo. La academia de inglés cerraba todo el mes, el entrenador cerraba dos semanas, no podía avanzar con ciertas tareas porque en agosto se para el mundo, y las caminatas bajaron bastante de frecuencia. Agosto fue el mes de preparar inglés por mi cuenta, de seguir con algunas series (terminé ‘My hero academia’ por fin), de grabar episodios para pódcast y de entrenamientos de fuerza. Todo esto, claro, sin renunciar a otros planes cuando salían, como también ocurrió en julio.

Sin embargo, el mes ha tenido dos momentos reseñables, uno para bien y otro para mal. Empecemos con el malo.

El sábado 15 me levanté fatal. Malestar, dolor de cabeza y fiebre. Infección de orina. Fueron unos días metido en cama sin ganas de nada. Fui al médico el domingo (cabezota que es uno) y tuve que volver el martes porque el lunes lo pasé entero en la cama, como los días anteriores. El martes por fin dieron con el tratamiento, un tratamiento que he terminado recientemente.

El momento positivo vino a final de mes. Fui con mi familia a un hotel todo incluido. Uno de esos que yo mismo había criticado cuando era más joven por decadentes. Lo pasé realmente bien, estuve muy tranquilo y pasé muy buenos ratos que volverán a mi memoria con una sonrisa. Otra contradicción más con la que lidiar: ¡viva la decadencia!

También a final de mes decidí que debía retomar la lectura, aunque fueran diez páginas por día, y estoy decidido a mantener ese hábito durante el curso (una vez que lea, si es necesario, las obras obligatorias). Me hace muy feliz avanzar con la lectura, aunque sea un poco. Durante 2025 solo leí cinco obras y antes de verano, solo una. Desde que he tomado esta decisión ya he leído dos ensayos y un poemario.

Un bajoncillo final

Desde el domingo 30 el trabajo empezó a ocupar mi mente, y esto me llevó a un pequeño bajón de ánimos. Ya metidos en septiembre me alejé del fediverso durante una semana, en uno de mis descansos periódicos. Ver noticias negativas sobre tantos temas no me hacía bien y, como soy consciente de que es problema mío, decidí apartarme.

Una idea muy simple pero muy fastidiada de asimilar es que estos bajones de ánimo tan pronunciados ya forman parte de mi vida. Debo lidiar con ellos, aceptarlos y gestionarlos como mejor se pueda. No se puede estar bien siempre, pero siempre tienen que ver con el trabajo, mire usted qué casualidad. El capitalismo haciendo de las suyas.

Y poco más

Yo creo que está bastante bien. Me alegra que el curso no me comiera el ánimo tanto como otras veces, en las que necesité mucho más tiempo de descanso, y me alegra que haya dedicado tanto tiempo a temas personales que necesitaba atender.

Ahora solo queda esperar lo que nos trae el curso escolar, pero de eso hablaré en otra ocasión.

2026-09-09

Sobre Colemak (Adrianistán)

Si el hace unos meses di por finalizado el experimento de los tiling window managers, hoy voy a finalizar el experimento de Colemak

Y puede que te preguntes. ¿Qué diantres es Colemak? Pues Colemak es una distribución de teclado. Una manera de organizar las teclas del teclado. La distribución más popular es QWERTY, aunque no es una distribución única. Cada país suele tener una versión local. Así el QWERTY de EEUU (el de referencia en muchos aspectos técnicos) no es igual al QWERTY de España, ni estos dos son iguales al de Alemania. Aunque obviamente tienen muchas similitudes.

Colemak es otra forma de organizar estas teclas. ¿Por qué surge Colemak? Porque QWERTY tiene una historia muy curiosa. Aunque se use hoy en día en multitud de dispositivos digitales, su uso primigenio viene de las máquinas de escribir. Se comenta que para que las teclas no se trabasen, se diseñó un esquema donde las teclas que se usaban juntas se encontraban en sitio opuestos. Esto no sé hasta que punto es verdad o es un mito. Pero la realidad es que un estándar que se ha impuesto (junto con la disposición de las teclas row-staggered, que daría para otro post).

Frente a esta disposición ya en tiempos previos a los ordenadores surgió Dvorak, la única alternativa a QWERTY que tiene respaldo como estándar ANSI en EEUU. Este sistema ya plantea un diseño pensando en como lo usará el usuario en vez de qué le viene bien a la máquina. Sin embargo, Dvorak es muy diferente a QWERTY. Requiere un reaprendizaje total y muchos atajos de teclado se vuelven imprácticos.

Colemak surge con la idea de que sea algo cómodo, realizando análisis de las teclas más usadas, reduciendo el movimiento de los dedos. Además preserva en muchas zonas las mismas teclas que QWERTY, sobre todo en las referentes a atajos de teclado.

Con esto, y con un teclado programable, el Keychron K11 Max, he estado usando Colemak.

Conclusiones

La realidad es que si no sabes mecanografiar, Colemak puede resultar más sencillo de aprender, sobre todo porque no puedes llevar malos hábitos de usar QWERTY sin saber mecanografiar. Pero por lo demás, no sé si justifica la diferencia.

Un tema importante es que la mayoría de sistemas del mundo no usan Colemak. Se pueden configurar como Colemak (Colemak está presente en versiones actuales de Windows, macOS, escritorios Linux, ...) pero salvo que sean equipos 100% tuyos, lo más normal es que tengas que usarlos con QWERTY.

Por otro lado no esperes mejorar tu velocidad. Realmente estas distribuciones alternativas no consiguen mejorar la velocidad de la mayoría de gente y la gente que hace mecanografía competitiva (sí, existe), suelen usas QWERTY.

Uno de los argumentos más interesantes tiene que ver con la comodidad, evitar desplazamientos haría que fuese más ergonómico pero... no hay demasiada evidencia. Sí que hay experiencias personales pero claro no podemos extrapolar esas vivencias como la norma. Existen probablemente otros factores que mejoren la ergonomía mucho más que la distribución, como por ejemplo la ubicación de los modificadores (Ctrl en general suele estar en un mal sitio, pero hay teclados y software que permiten cambiarlo), si es row-staggered, column-staggered u ortolinear, si es split o tiene algo de separación entre mitades (teclados tipo Alice), o incluso el hecho de ser mecánico o no y el tipo de switches. Todo eso seguramente impacte más que Colemak vs QWERTY

La decisión

He decidido que ya no voy a usar más el teclado Colemak, volveré a QWERTY. Pero ojo, no voy a volver al QWERTY Español. Voy a ir al QWERTY US Internacional con Alt Gr. ¿Y esto, te preguntarás? Pues el teclado QWERTY Español no se distingue mucho del americano, sobre todo respecto a otros teclados europeos. Pero donde sí que cambia bastante es los símbolos. Y para prosa no hay tanta diferencia, pero para programar el acceso a símbolos debe ser sencillo.

El teclado QWERTY americano normal tiene un problema. No se puedene escribir tildes y eñes de forma cómoda. La variante internacional, aunque menos conocida, sí que deja. Existen varios métodos de introducir las tildes. En el teclado QWERTY español se usan sticky keys. Es decir, hay ciertas teclas que al pulsarse no hacen nada pero se queda escuchando a la siguiente a ver cuál es y ya generar la letra. Las tildes se introducen así, primero la tecla de tilde y después la vocal. Pero esto puede ser un poco confuso y tampoco se lleva bien con los símbolos. La variante Alt Gr del teclado US Internacional lo que hace es que mientras mantengas pulsado la tecla Alt Gr (Alt del lado derecho) la letra que pulsemos será su versión modificada: si pulso Alt Gr + a, sale á. Es como la tecla Shift/Mayúsculas. El problema es que tener Alt Gr rompe la simetría de algunos teclados que tienen Ctrl y Alt a ambos lados, con idéntica funcionalidad. Pero considero que es aceptable.

Veamos si dentro de unos meses acabo pensando lo mismo

Inmigración y elecciones (La Página Definitiva)

Mal momento para ser perro sin amo

2026-09-06

Lecturas (2026.III) (otro blog más)

Seguimos a un ritmo bien relajado de lectura (el anterior Lecturas fue justo después de Sant Jordi), pero menos es nada…

Comienzo por el libro que no me he acabado. Annie Duke es una exjugadora de póker de éxito considerable que ahora escribe sobre la toma de decisiones en situaciones de incertidumbre. El libro está bien, pero no es lo que yo buscaba: ideas sobre cómo lidiar con la incertidumbre en la vida real. El póker, efectivamente, es un juego de habilidad y azar marcado por la incertidumbre, pero no se traslada a la vida real: en el póker se juegan centenares de partidas siguiendo las mismas normas y cada decisión tiene un alcance limitado, mientras que en la vida real cada decisión es diferente y su alcance, potencialmente vital. Me quedé algo más allá del primer tercio del libro sin demasiadas expectativas (ni indicaciones en el índice) de que fuese a dar algún salto de un entorno a otro. Una vez sabido esto, puede ser una lectura interesante.

Segundo chapuzón en Borges, y segunda vez que salgo encantado (en todos los sentidos), con la sensación de haberme perdido la mitad pero con ganas de más. Tremendo.

Más divulgación sobre lingüística desde un punto de vista descriptivista y tolerante con el cambio. Muy bien escrito (no podía ser de otra forma) e interesante. Me ha gustado especialmente la atención al género: al menos en inglés, deja claro que si quieres saber cómo se hablará dentro de unos años, deberías prestar especial atención a cómo hablan las niñas (al menos en inglés, que es de lo que habla el libro, pero me imagino que en el resto de idiomas también será válido) y otras comunidades poco privilegiadas.

Novelita (apenas 136 páginas) de ciencia ficción que viene a ser «El Marciano pero al revés». La autora tiene un premio Hugo, y es fácil ver por qué. Extremadamente recomendable (ya he pasado por caja a comprarme otro de sus libros), aunque no desvelaré nada más del argumento.

Y cierro con un libro importante. No creo en las lecturas obligatorias… pero nadie debería salir de una carrera de informática sin haberse leído este libro. Además de ser la historia de Fran Bilas, Jean Jennings, Kay McNulty, Marlyn Wescoff, Betty Snyder y Ruth Lichterman (pongo los «nombres de soltera», que a mí las manías anglosajonas del cambio de nombre en el matrimonio se me hacen muy raras), las seis primeras programadoras, y el ninguneo que sufrieron duarnte décadas (y que aún dura), es un pedazo imprescindible de la historia de la informática y del siglo XX en general.

En lo negativo, dice el «blurb» de la portada que la prosa de Kleiman es detallada… porque, como narración de la historia oral que es, no es la más apasionante… excepto cuando habla de su propia historia descubriendo la historia de «las seis del ENIAC». Aun así, el libro está pidiendo a gritos ser convertido en miniserie de prestigio. Si obtiene los derechos un equipo como el de los creadores de Halt and Catch Fire, podría salir algo maravilloso.

Y lo dejamos aquí. A ver si me da tiempo a leer algo más antes de que acabe el año…

2026-09-05

#breBytes La familia Motorola 68000 (otro blog más)

La vida de la familia 68000 de Motorola fue breve (dejó de fabricarse en 1996), pero intensa, siendo el procesador de nuestro adorado Amiga y del Atari ST, pero sobre todo la primera arquitectura sobre la que se construyeron los Macs (y el Lisa antes de eso). Apple se pasó a los PowerPC en 1994, y eso acabó con los 68k. Pero hace 40 años, en septiembre de 1986, la familia 68000 prometía muchísimo: lo suficiente como para ser portada de Byte.

La revista le dedica un buen espacio a las diferentes máquinas 68000 (incluyendo un apartado dedicado a Unix), pero nosotros ya sabemos cuál era la mejor. Y es que, ¿qué otra máquina podía producir gráficos así?

Y claro, lo que más nos interesa de la sección es esta comparación entre el Amiga y el Mac, aunque está hecha desde el punto de vista del programador:

Nótese, por cierto, que el artículo está escrito por un graduado del Dartmouth College, el lugar de nacimiento de BASIC. La comparación, por cierto, es favorable al Amiga en cuanto a la programación de la interfaz, gestión de dispositivos, multitarea (no es una sorpresa enorme, teniendo en cuenta que el Mac no era multitarea en 1986) y gestión de memoria, y al Mac en lo que se refiere a primitivas gráficas. Pero esto no le salvaría la vida al Amiga, lamentablemente.

Un poco más adelante, en su Chaos Manor Jerry Pournelle seguía enamorado del Amiga y nos hablaba de ese clásico que fue Deluxe Paint (con el que se hizo el Tutankamón de aquí arriba, si no me equivoco, y que ocuparía el lugar en el imaginario que le dedicamos a Photoshop si viviésemos en la línea temporal correcta), pero ya veía los primeros pasos de la muerte de Commodore…

Y no me voy sin rescatar este anuncio, con el que se lanzaba lo que sería el estándar oro de los monitores durante muchísimos años: los NEC Multisync, capaces de trabajar con básicamente cualquier ordenador de la época, y que en esta, su primera encarnación, era capaz de alcanzar los 800 por 560 de resolución en sus 13 pulgadas :-).

Un día de estos, más :-).

2026-09-03

Verano de Emacs: antes muerto que sencillo (Adrianistán)

Aunque ya estamos en septiembre, el verano no ha acabado. Lo hará el 21 de septiembre. Hoy vamos a ver algo que puede ser superficial, incluso algunos dirían que vanidoso. Hoy vamos a ajustar la estética de Emacs.

¿Por qué poner guapo a Emacs?

La estética no es una vanidad. Nuestro entorno de escritura debe ser cómodo y atractivo. Y si eso implica cambiar los ajustes por defecto que así sea. Por otro lado es cierto que esto puede convertirse en una tarea sin final, hay que saber poner límites al tiempo dedicado a esto.

Por último, todo el mundo tiene gustos diferentes. En lo personal quiero una interfaz no demasiado sobrecargada aunque tampoco minimalista estrictamente hablando. Para los usuarios que prefieren más información en pantalla existen multitud de paquetes como treemacs, breadcumb, ... que añaden iconos, más interfaz, etc

Simplificando la interfaz

Emacs, en su modo GUI por defecto, tiene varios elementos visuales. La Menu Bar y la Tool Bar. Son redundantes y la tool bar tiene menos opciones y ocupa más, por lo que recomiendo desactivarla. Por otro lado, la barra de scroll es bastante innecesaria, porque siempre me desplazo por los buffers con teclado.

(menu-bar-mode 1) (tool-bar-mode -1) (scroll-bar-mode -1)

Podría hablar de las pestañas y es que Emacs soporta tener pestañas en cada frame (ventana de nuestro escritorio). Estuve un tiempo tratando de usar pestañas y realmente no me aportaban mucho. En otros editores donde se usa más el ratón pueden tener sentido pero en Emacs normalmente con el cambio entre buffers es suficiente.

Números de línea

Un detalle que me parece importante es ver los números de línea en los laterales. En Emacs esto se puede activar en modos específicos o de forma global. Personalmente yo prefiero modo global ya que no se me ocurren muchos modos donde quisiera tenerlo desactivado. Además al haber quitado la barra de scroll, esto recupera algún elemento para ubicarnos dentro del buffer

Existen dos modos de contar líneas: absoluto y relativo. En el modo absoluto aparece con cada línea su número de línea dentro del buffer. Fácil y sencillo. Pero en Emacs tenemos comandos que aceptan argumentos numéricos, por ejemplo, borrar línea (C-k por defecto). Con los números absolutos tendremos que hacer restas. Con el modo relativo solo la línea actual muestra su posición de forma absoluta, el resto muestran su diferencia respecto a esta línea. Yo lo tengo en modo relativo.

(setq display-line-numbers-type 'relative) (global-display-line-numbers-mode 1)

Tipografía, colores y espaciado

Por último vamos a la sección más puramente estética. Para la tipografía, configuro una tipografía como Monaspace Neon. Hablé de ella en mi lista de tipografías. Le configuro un tamaño algo más grande de lo habitual para que sea cómoda de leer en mi monitor.

Un detalle que me no me gusta de Emacs es que por defecto no deja suficentes márgenes. Existe un paquete hecho por Protesilaos que permite configurar márgenes llamado spacious-padding.

De Protesilaos también es el tema que configuro. Prot tiene varios paquetes de temas como modus-themes, ef-themes (εὖ) y doric-themes. ef-themes es donde tendremos más variedad. Recomiendo que uses M-x ef-themes-select para ir probando los diferentes temas y decidas cual de gusta más. En el ejemplo voy a poner ef-cyprus que tiene tonos verdes.

(set-face-attribute 'default nil :font "Monaspace Neon Var" :height 130) (use-package ef-themes :ensure t :config (modus-themes-load-theme 'ef-cyprus)) (use-package spacious-padding :ensure t :config (setq spacious-padding-widths '( :internal-border-width 0 :right-divider-width 0 :mode-line-width 2 :fringe-width 20)) (spacious-padding-mode 1))

2026-08-31

TROM (Kringvarp Føroya, 2022) (La Página Definitiva)

Como está el mundo

2026-08-25

Tengo un pódcast nuevo (Adrián Perales)

Ya lo avisé hace unos días en Divagaciones, pero lo dejo también por aquí para quienes gustan del formato texto.

Ahora que hemos publicado el programa número 60 de Radio Al compás, que será el último en una temporada para descansar de unos niveles de guion y edición muy exigentes, me embarco con mis amigos en un nuevo pódcast.

Se llama ‘Los maestros liendre’.

En el momento de escribir estas líneas ya se ha publicado el primer episodio y está disponible en los directorios de pódcast más habituales, además del feed.

Tres amigos nos sentamos en una mesa en torno a un micrófono para recomendar cultura. Cine, series, videojuegos, música, literatura, algún destino, lo que se nos antoje. Hay una recomendación individual y luego una grupal, y todas pueden ser en positivo o en negativo.

¿Y por qué ese nombre? Porque como el maestro liendre, que de todo sabe pero de nada entiende, nosotros hablamos de un montón de temas sin tener mucha idea.

Es un pódcast muy parecido a tantos otros, pero este es el nuestro. La periodicidad es quincenal y los audios duran poco más de una hora. Y no lo edito yo.

Nos escuchamos por allí, si es que te interesa.

2026-08-24

El directorio ¡Blog!¡Blog! (Adrián Perales)

En 2023 pedía un movimiento de pequeña web hispanohablante, y ha llovido mucho desde entonces. Poco tiempo después nacía la denominación «web sencilla», que se trata en resumidas cuentas del mismo concepto, junto con la recopilación de recursos de Editora con carrito. Y en 2025 llegó el directorio.

¡Blog!Blog! es un lugar donde encontrar blogs hispanoparlantes. Nada mejor como su propia definición para darlo a conocer:

Un directorio para buscar y encontrar blogs personales en español Libres de SEO, Inteligencia Artificial, algoritmos y sin fines comerciales.

Fue creado y es mantenido por matizeta; y a día de hoy ofrece más que un simple listado:

En el momento de escribir estas líneas van 164 blogs que se han apuntado al directorio. Las ganas de compartir lejos de las redes sociales aún sobreviven, y ¡Blog!¡Blog! se ha convertido en el lugar donde encontrar nuevas lecturas en español.

Gracias a matizeta por su trabajo en el directorio, ¡y larga vida a los blogs!

2026-08-22

#breBytes C++ (otro blog más)

Aprovechando la canícula, seguimos con nuestra versión light del repaso a la revista Byte de hace cuarenta años. Y suerte que nos hemos pasado al modelo light, porque el número de agosto del 86 no venía especialmente fuerte. Pero no puedo saltarme la sección de crítica de libros, porque ahí tenemos uno de los clásicos de la informática, la presentación de C++ por parte del creador del lenguaje, Bjarne Stroustrup. (Si no he buscado mal, la cuarta y última (de momento) edición se publicó en 2011.)

Y me tenéis que reconocer que es divertido leer la crítica de un libro en la que el revisor te dice cosas como que C++ suma considerablemente a la complejidad de un léxico ya obtuso (no seré yo el que le lleve la contraria, pero pegarle así a C…), para a continuación explicarte que evaluar el libro es complicado en ausencia de implementaciones de C++ (vamos, sin haber probado el lenguaje), y después explicar qué es eso de los objetos en programación (la orientación a objetos, como paradigma, data de finales de los cincuenta (del siglo pasado), pero no se había prodigado mucho hasta la llegada de C++ y sus diferentes «primos» (por mucho que Smalltalk ya llevase unos cuantos años corriendo por el mundo)). No está mal, por cierto, permitirse darse el lujo de darle una collejita a nada más y nada menos que Stroustrup (en aquel momento no era la leyenda que es hoy, claro) por permitirse el lujo de usar palabras como «clase» antes de definirlas. Ni dudar (razonablemente, dada la juventud y novedad de la cosa) del éxito de un lenguaje que, cuarenta años más tarde, se disputa la segunda posición del ranking de lenguajes de TIOBE con «papá C».

Se publica la crítica, por cierto, dentro de un número dedicado a la programación orientada a objetos (ya os decía que el tema comenzaba a popularizarse en aquella época) en el que escribe, entre otros, el creador de Objective C, el lenguaje de desarrollo para Apple hasta nada más y nada menos que 2014.

Si queréis seguir hojeando el número, en la misma sección de libros se critica también el Mind Over Machine del filósofo Hubert Dreyfus y su hermano Stuart, algo menos famoso pero aún así profesor emérito en Berkeley, que se dice pronto. El libro argumenta (siempre según la crítica) que nunca tendremos una verdadera inteligencia artificial porque los ordenadores carecen de intuición. La historia no se repite, pero rima, dicen. El crítico también se fija en un capítulo dedicado a los temores sobre la implantación de la IA en la educación. 1986.

Y también se puede recomendar, creo, pero para valientes, el discurso del recientemente fallecido Tony Hoare (ya premio Turing por aquel entonces), Mathematics of programming. Por aquello de incidir en que lo que se publicaba en los ochenta en revistas generalistas de informática tenía en muchas ocasiones un nivel estratosférico, entre otras cosas.

En fin. Algún otro día, más, pero como muy pronto, en septiembre.

2026-08-18

Verano de Emacs: modal o no modal (Adrianistán)

Modal o no modal, esa es la cuestión. Aunque Emacs dispone de "modos", lo cierto es que cae dentro de los editores de texto no modales. ¿Cuál es la diferencia y por qué es importante? Un editor modal es aquel en el que lo que puedes hacer queda restringido al modo en concreto donde estés. El editor modal más famoso es Vi, donde tenemos un modo para movernos y hacer ciertas ediciones, un modo de inserción donde escribimos, un modo visual para seleccionar regiones de texto,... Es habitual mientras se usa dentro de un mismo fichero ir cambiando el modo

Por resumir, para editar un fichero, lo abres, vas hasta el sitio que quieras ir, cambias de modo, escribes, cambias de modo, buscas la siguiente zona a modificar, aplicas ediciones con una sola letra, cambias de modo, escribes, ...

En Emacs sin embargo los atajos de teclado principales están disponibles siempre, y casi siempre son combinaciones de varias teclas usando al menos un modificador. Los modos, tanto mayores como menores, solamente añaden funcionalidad concreta y son mayormente fijos para cada fichero, sin que los vayamos cambiando.

Si se mira el mundo del software interactivo se podría pensar que el software no modal es bastante popular. Los navegadores webs o las suites ofimáticas entran dentro de la definición de no modal. Pero con el software más creativo tipo Photoshop o AutoCAD, la cosa ya no es tan clara y podríamos pensar que estos programas tienen diversos modos, a los que se accede a través de las herramientas.

El caso es que Emacs no es modal pero esto tampoco convence a mucha gente, así que hay paquetes que convierten a Emacs en un editor modal. Puede haber varios motivos para así quererlo, desde compatiblidad con editores modales, comodidad o motivos de salud. Ciertas personas reportan que el uso excesivo de modificadores en Emacs (Ctrl y Alt principalmente), presentes en todos los atajos, generan problemas en las articulaciones. Y es que estas teclas ciertamente están en posiciones alejadas y de acceso no tan cómodo como las letras.

Para los primeros existen paquetes como Evil o como Hel, que emulan Vim y Helix respectivamente. Existen otros paquetes que agregan modalidad a Emacs sin inspirarse fuera, como Meow o Boon. En su momento probé Meow y no estaba tan mal, pero tampoco le vi demasiado la gracia.

God Mode

Dentro de las opciones de añadir modalidad, God Mode para mí destaca por su simpleza. Es un modo al que se accede con una tecla, normalmente Escape y mientras estamos en él, todas las teclas comienzan prefijadas con Ctrl. Es decir para hacer C-x C-s (save-file), solo debemos escribir "xs".

Las combinaciones de teclas que no necesitan modificador pulsado se deben prefijar con un espacio. Así, C-x b, sería "x b". El tema es que si vamos a usar mucho una combinación que requiera espacio según las reglas de God Mode, puede sernos conveniente crear un nuevo atajo que llame por debajo a la misma función de Emacs pero que sí use Ctrl para que God Mode lo inserte por nosotros. Para usar Alt, se usa la letra g. Efectivamente, C-g no puede marcarse con God Mode, pero esto es intencional. C-g se tiene que seguir haciento con Ctrl y la letra g.

Esto resalta una de las características de God Mode y es que apenas modifica el comportamiento de Emacs. Todos los atajos que funcionan en Emacs, funcionan con God Mode, solo que podrían hacerse con menos pulsaciones. Y también toda la memoria de atajos de Emacs sigue sirviendo.

Cuando he usado God Mode he usado esta configuración:

;; God mode (defun my-god-mode-update-cursor-type () (setq cursor-type (if (or god-local-mode buffer-read-only) 'box 'bar))) (use-package god-mode :ensure t :config (global-set-key (kbd "") #'god-local-mode) (setq god-exempt-major-modes nil) (setq god-exempt-predicates nil) (add-hook 'post-command-hook #'my-god-mode-update-cursor-type) (define-key god-local-mode-map (kbd "[") #'backward-paragraph) (define-key god-local-mode-map (kbd "]") #'forward-paragraph) (define-key god-local-mode-map (kbd ".") #'repeat)) (global-set-key (kbd "C-x C-1") #'delete-other-windows) (global-set-key (kbd "C-x C-2") #'vsplit-last-buffer) (global-set-key (kbd "C-x C-3") #'hsplit-last-buffer) (global-set-key (kbd "C-x C-0") #'delete-window) (global-set-key (kbd "C-x C-5 C-0") #'delete-frame) (global-set-key (kbd "C-x C-5 C-1") #'delete-other-frames) (global-set-key (kbd "C-x C-5 C-2") #'make-frame-command)

Una función para según el estilo del cursor saber en qué modo estamos, Escape para entrar y salir del modo, algunos comandos para God Mode y algunos atajos de teclado nuevos usando Ctrl para evitar tener que introducir espacios.

Devil Mode

Pero y si nos gusta la no modalidad de Emacs. Personalmente soy bastante fan de la no modalidad, el poder llamar cualquier comando sin saber si estoy en uno u otro modo. El problema (o no, ya digo que esto depende de cada uno), es el uso excesivo de modificadores. Modificadores que se sitúan en zonas malas del teclado y que tenemos que pulsar a la vez junto con otra (a veces dos) teclas. Devil Mode actúa de forma diferente. Escoge una tecla de fácil acceso, por defecto la coma y la convierte en el iniciador de la secuencia.

La secuencia empezada por la coma espera a una tecla, pero ya ha introducido un Ctrl "pegajoso" o sticky. Una de las características de Devil Mode es que nunca hay que pulsar dos teclas a la vez, la secuencia se puede ir construyendo tecla a tecla. Cada coma adicional es un Ctrl adicional esperando una letra. Así para escribir C-x C-s (save file), es tan sencillo como coma, x, coma, s. Y C-x b es coma, x, b. Existen algunas excepciones. Coma seguido de espacio es el uso más común de la coma, y no hace nada, solo inserta coma y espacio. Lo mismo con coma y Enter. Coma y coma inserta coma también. Coma y m, cambia el modificador de Ctrl a Alt y coma con dos m, es Ctrl y Alt pulsado a la vez.

Una característica extra de Devil Mode es que admite ciertas repeticiones en los comandos sin tener que usar la coma. Por ejemplo en los movimientos, coma p p p n n, es el equivalente a C-p C-p C-p C-n C-n. Esto por defecto solo está activado en algunos comandos concretos como estos que he mencionado y que son comandos que sin Devil se harían rápidamente y sin levantar el dedo de Ctrl.

Del mismo modo que God Mode, en Devil no hay problema en introducir los atajos grandes normales. Todos ellos siguen funcionando.

En general Devil me gusta más porque precisamente preserva la no modalidad de Emacs. Lo único que cambia es que algunos comandos se alargan secuencialmente pero nunca tendremos que pulsar más de una tecla a la vez.

La configuración de Devil, en mi caso, es bastante simple.

(use-package devil :ensure t :config (global-devil-mode) (devil-set-key (kbd ",")) (global-set-key (kbd "C-,") 'global-devil-mode))

2026-08-17

Máscaras (Adrianistán)

Si vamos a un museo de arqueología o de antropología, no será raro encontrarnos con máscaras de diferentes épocas y civilizaciones. Las máscaras tienen un aura de atracción y misterio. Cuando llevas puesta una máscara, es mucho más difícil saber quién o qué hay detrás. Nuestro mejor sentido, el de la visión, queda invalidado. Tienes que recurrir a otras técnicas para descubrir que hay detrás. Si es que quieres claro. Porque, ¿quieres de verdad saber que hay tras la máscara? La pantomima es comfortable.

Recientemente he convivido con varios grupos de gente. Es curioso comparar, las sensaciones en cada grupo han sido diferentes. Mi comportamiento y las emociones experimentadas han sido otras. Las personas de mi alrededor también han podido ver máscaras diferentes yaciendo sobre mí. ¿Alguien puede vernos con autenticidad? ¿O siempre nos exponemos ante los demás con una máscara? Alguien podría decir que con tu pareja o tus padres, algún amigo cercano. Pero creo que las máscaras de novio, hijo o "amigo de zutanito" siguen existiendo. Es más, ¿somos nosotros mismos capaces de vernos sin máscara? ¿Tenemos la valentía de mirar que hay tras nuestra propia máscara? ¿O nos da miedo ver que puede salir?

Quizá no tenga sentido plantearse estas preguntas. El yo no es accesible. Es una amalgama de vivencias, pensamientos y ensoñaciones que solo la máscara es capaz de dar forma, como la vasija al agua. Solo a través de la máscara adoptan una coherencia. Sin la máscara no seríamos una versión pura, sino un producto de la entropía,inútil e inservible por si solo. Y si las máscara que poseemos, en el fondo, son lo más auténtico que tenemos. Y saber elegir cuando vestir una u otra máscara, la mayor libertad que tenemos.

Dicen algunos gurús una frase muy manida: fake it till you make it. Podría resumirse como, si quieres ser como aquel, ponte la máscara que lleva aquel. En un determinado momento, la máscara será tuya y ya ni te darás cuenta que la llevas puesta. Parece que hay cierta evidencia psicológica de que funciona hasta cierto punto. Así pues, elegid sabiamente vuestras máscaras para el próximo baile.

2026-08-10

1493: El mundo creado por Colón – Charles C. Mann (La Página Definitiva)

Descubrimos que Homogenoceno es palabra real.

2026-08-08

Verano de Emacs: introducción (Adrianistán)

Voy a comenzar una serie veraniega, titulada "Verano de Emacs". En esta serie, vamos a ver, algunos detalles de como usar Emacs. Existen multitud de tutoriales y documentación en Internet. Esto no es una serie desde el principio, simplemente voy a ir comentando cosas que no me parecen obvias o sobre las que he tenido que investigar un poco para llegar a alguna conclusión. Parte de la idea de hacerla, de hecho, es ayudarme a mí mismo a hacer un uso efectivo de esta gran herramienta así como justificar algunas decisiones que he tomado. Por tanto los temas que voy a tocar son cosas que uso o que considero interesantes usar. Voy a ignorar aquellas funcionalidades que no uso. Pongamos un ejemplo. Emacs soporta pestañas, aunque no vienen habilitadas por defecto. Después de haberlas usado en alguna ocasión nunca he llegado a darles un buen uso y no las uso. En esta serie no aparecerán junto con muchas otras cosas.

¿Por qué Emacs?

Se pueden dar miles de razones para no usar Emacs. Es feo, tiene una curva de aprendizaje alta, no usa atajos de teclado estándar, necesita configuraciones, pese a ser un software con solera es relativamente lento, comparativamente tiene pocos usuarios, ... Así que, ¿por qué usarlo? Realmente esto no va de programadores, que quizá es lo primero que se te venga a la cabeza al ver esto en este blog. Pero eso es solo un subtipo de gente a la que Emacs le puede venir bien. Hablo de la gente que escribe en general. De la gente que se expresa mediante la palabra. Emacs es, ante todo, un editor de texto. El equivalente al boli y papel en el mundo digital. Y es maleable. Puedes usar Emacs tal y como viene, o puedes modificarlo para que se adapte a tus manías, a tu forma de pensar, con y sin distracciones, tal y como quieras. Es por tanto quizá la mejor manera para escribir y expresarse. Tanto para hacer poesía como para diseñar estrategias empresariales, Emacs es esa capa entre nuestra mente y la realidad. Y en Emacs la maleabilidad no es solo una cantidad ingente de ajustes (que también) sino la posibilidad de cambiar prácticamente todo, sin recompilar, directamente sobre el propio programa. Acceso para controlar el ordenador, nuestra bicicleta de la mente, de forma precisa y con libertad.

Dicho esto, existen otros programas que pueden compartir ideales con Emacs. De hecho existe software muy similar a Emacs por diseño como Lem y podríamos hablar de otros editores de texto frikis como Neovim, Helix, ... Aquí el hecho de preferir Emacs es quizá algo más histórico que otra cosa, aunque no me cortaré al decir que he conocido gente con una visión humanística más allá de lo técnico que es realmente inspiradora.

En cualquier caso no pretendo convencerte si no sientes la necesidad de meterte en este mundo. Otro elefante en la habitación es que si leíste No estoy hecho para los tiling WM quizá te sorprenda que use un software tan maleable cuando en el caso de Niri y Sway al final no me convenció. Emacs es mi excepción, mi gran excepción. Porque es precisamente el sitio de un ordenador donde quiero tener todo el control.

Fichero de configuración

Para configurar Emacs, principalmente se usa el Init File, un fichero de código Emacs Lisp que se ejecuta cuando Emacs arranca. Emacs Lisp es el programación que usa Emacs y es bastante peculiar (quizá de los pocos lenguajes que queden con dynamic scoping). Quizá en un artículo posterior haga una introducción al lenguaje, pero la mayoría de configuraciones no requieren de código complejo.

La ubicación del init file puede ser: ~/.emacs, ~/.emacs.d/init.el o ~/.config/emacs/init.el

Nomenclatura de atajos de teclado

Emacs tiene multitud de atajos de teclado. Además dispone de una notación para que los podamos escribir siempre de la misma forma. Las letras C, M, S, s representan Control, Meta (Alt), Shift y Super (Windows) respectivamente y son modificadores. Las otras teclas suelen representarse por su tecla en el teclado. Si van unidas por un guion es que hay que pulsarlo a la vez. Hay atajos de teclado largos, separados por espacios. Cuando hay un espacio se deben soltar las teclas que no sean modificadores antes de continuar. Por ejemplo: "C-x C-c" (salir de Emacs), sería: pulso Control, pulso x a la vez, suelto la x, pulso c, dejo de pulsar Control.

Existen modificaciones sobre los comandos como God mode, del cuál quiero hablar en un post futuro.

Configurar emacsclient

Cuando instalamos Emacs es posible que nos salgan dos entradas en nuestro lanzador de aplicaciones: Emacs y Emacs (cliente). Esto es porque Emacs puede ejecutarse con un modo cliente-servidor. Permite tener un Emacs siempre levantado invisible y clientes ligeros que se abren y cierran sin tanto retardo y que comparten estado entre ellos. Cuando inicio Emacs siempre abro la sesión completa, "Emacs" a secas.

Así pues para arrancar el servidor nada más lanzar Emacs y así poder lanzar clientes después, tengo en la configuración:

(server-start)

Por otro lado, podemos configurar la variable EDITOR de nuestro shell para que se use emacsclient cuando algún programa de CLI lo requiera.

export EDITOR="emacsclient -c -a emacs"

Si añadimos a un .bashrc, .profile, o un fichero equivalente en Zsh, Fish, ... Se abrirá emacsclient cuando algún CLI requiera de un editor. El flag -c indica que se abrirá de forma gráfica, mientras que con -t se abriría en la terminal. El flag -a indica qué hacer si no hay levantado un servidor de Emacs. En ese caso, simplemente lanzamos Emacs.

2026-08-07

t.co era malo, share.google es aún peor (otro blog más)

Hace casi quince años escribía yo que los acortadores de URLs son malos, pero que t.co (el que usaba de manera subrepticia Twitter en aquel momento) era el peor... y hace quince años tenía razón, pero en algún momento dejé de tenerla, porque apareció el dichoso share.google.

En su momento repasaba las ventajas de los acortadores de URLs, al estilo de bit.ly (permiten escribir URLs breves y/o memorables y monitorizar los clics en el enlace (el riesgo que implica la segunda cláusula ya era grande entonces, y hoy aún lo es más))… y los males que añadía el de Twitter: se insertaba sin permiso y el monitorizado solo lo ejercía Twitter, con lo que perdía cualquier efecto positivo.

Pues bien. ¿No os habéis fijado en la cantidad de enlaces que os llegan que comienzan con un share.google/loquesea? Si compartís un enlace después de hacer una búsqueda en Google, al menos desde Android, el flujo es algo así como

¿Habéis visto la URL de arriba? en.apf.gv.at. ¿Habéis visto la URL de abajo? share.google. Como servidor es maniático, cuando ve la dichosa URL, comparte a Firefox para limpiar la URL. ¿Problema adicional? Que Google registra la URL en su aplicación de Android, con lo cual tenemos un obstáculo más que saltar al llegar a Firefox:

A no ser que leas con atención y canceles, la opción por defecto nos devolverá a Google y tendremos que volver a comenzar (o darlo por imposible y rendirnos, si no hemos leído con atención).

Igualico igualico que con t.co… con la diferencia de que,

  • por un lado, si Twitter era popular hace quince años, ahora esto está presente en todos los móviles Android (si alguien sabe cómo desactivarlo (sin cambiar el buscador por defecto, que si bien es una opción muy interesante, no es lo que quiere la mayoría de usuarios, diría), que avise). Y además de ser mucho más ubicuo, lo tiene Google, que ya sabe más de ti que Twitter, y ahora sigue acumulando. Si la persona con quien compartes también tiene su cuenta de Google, hay bastantes números de que Google acabe completando aún más sobre tu grafo social, sin ningún tipo de autorización y, en la mayoría de casos, sin que nadie se entere.
  • Y, de regalo, t.co redirigía y punto: si compartías a Firefox, el enlace quedaba limpio sin más. Y ahora hay que hacer el pino puente para acabar de limpiar la URL.

A uno le gustaría pensar que estos comportamientos, sin manera obvia de desactivarlos (de hecho, a mí me gustaría que estas cosas fueran opt in, y no opt out, que es lo que es ahora, como mínimo en la práctica), llamasen la atención de las autoridades antimonopolio de la UE. Pero parece que, al menos de momento, no.

2026-08-04

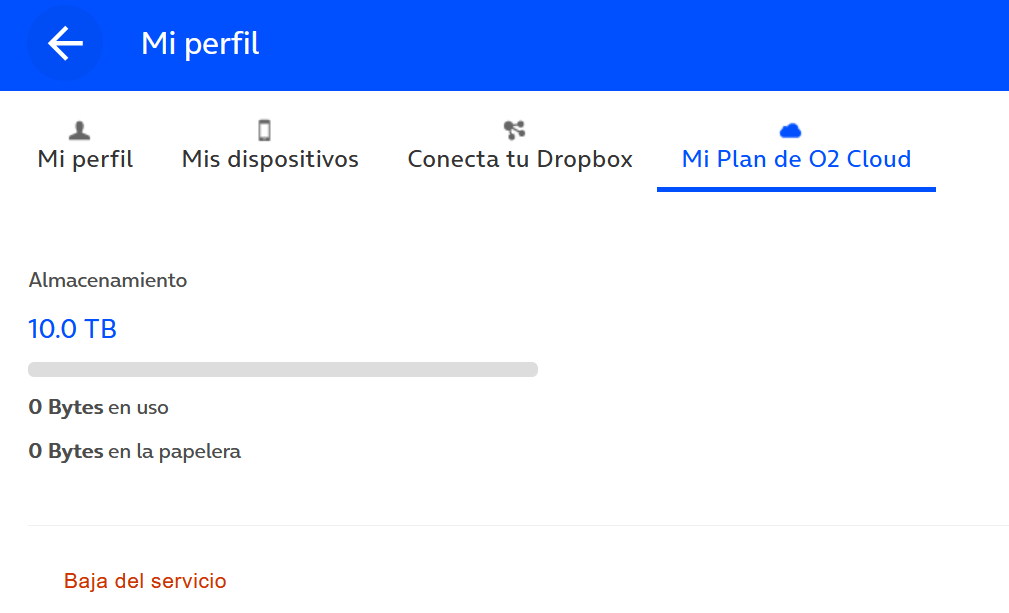
¿Tienes O2? Tienes diez teras de disco en la red (otro blog más)

Diez teras. Sí. No es una errata. Cuando me lo dijeron, yo también lo pensé. Y mi suscripción de O2 no es la más cara.

Ahora mismo…

  • Con Google One, el plan de 100 gigas que confieso avergonzado que pago sale por 20€ al año, y dan 200 por 30 (los planes más grandes incluyen Gemini Pro, o sea que no son comparables, pero por completismo, el de 400 sale a 50 y el de 2 teras se va a 100).
  • Dropbox cobra 120€ al año por 2 teras.
  • Proton, por los mismos 120€ anuales, se queda en 500 gigas, pero con sus garantías de privacidad.
  • Probablemente el mejor pack ahora mismo, si vas a usar diferentes cuentas, es el de Microsoft 365Familia, que por 130 te da seis cuentas OneDrive con un tera por cuenta y además incluye Office para todos.

Vamos, que si eres usuario de O2, los diez teras incluidos son como para tenerlos en cuenta.

¿Que cómo se instala? Os vais a la tienda de aplicaciones del móvil y buscáis «O2 Cloud». Unos cuantos SMS de confirmación más tarde tendréis la aplicación del móvil instalada.

Advertencia: como mínimo en Android, los permisos para acceder a fotos y vídeos son imprescindibles, aunque no hace falta activar la sincronización. No nos olvidemos de que O2 es Telefónica, y alguna ñapa tenía que haber…

Desde la web de la aplicación, entonces, os podréis descargar la aplicación de escritorio, al más puro estilo Dropbox. Por algún motivo (recordemos: O2 es de Telefónica…) no permite tener la carpeta a sincronizar en un disco de red, pero qué se le va a hacer. Y tampoco sé deciros qué pasará cuando la carpeta crezca, inevitablemente, más allá de la capacidad de disco que tengáis. Siempre queda la opción de no instalarla, eso sí.

Y eso es todo. De nada…

2026-08-01

devLecturas (II) (otro blog más)

Cinco enlaces más de cosillas de desarrollo web entendido en sentido amplio (la edición anterior es de principios de junio, no sé yo si esto va a tener mucha continuidad, pero lo seguiremos intentando).

De los vídeos de la commit, celebrada a principios de junio, me han llamado la atención un par de charlas. La primera, una «nueva manera de testear el frontend», «test while developing«.

Y la segunda, la de Ramón Corominas sobre evaluación automática de accesibilidad:

Aprovechando que estoy con uno de accesibilidad, hace apenas unos días Olga Carreras repasaba la WCAG Evaluation Methodology (WCAG-EM) 2.0.

Volviendo a principios de junio, Manuel Matuzovic hablaba de encabezados «concientes de su contexto». La idea, si los navegadores acaban dándole soporte, es que finalmente podamos escribir bloques de código dándoles título con un <h1>, y que sea luego el navegador el que lo convierta en el h-loquesea conveniente usando un «offset» y le aplique el CSS adecuado, cosa especialmente interesante si se trabaja con componentes. De momento solo se está implementando en Firefox. Dedos cruzados para que lo adopten el resto de navegadores 🤞.

Y para cerrar (el enlace es más antiguo, pero yo la encuentro ahora), tenemos esta Retro UI library que no creo que use nunca, pero que me parece absolutamente maravillosa.

2026-07-29

Clicks Keyboard. I wanted to believe… (otro blog más)

…y aún sigo queriendo creer, y no está perdida toda la esperanza. Pero.

Recordará el lector habitual, atento y con [mucha] memoria, que los teclados son tema de preocupación de esta casa, y en particular los teclados físicos de los móviles (les escribimos un réquiem en 2013, ilustrado con foto del añorado Nokia N97, y en 2009 nos enamoramos del (¿la?) Palm Prē).

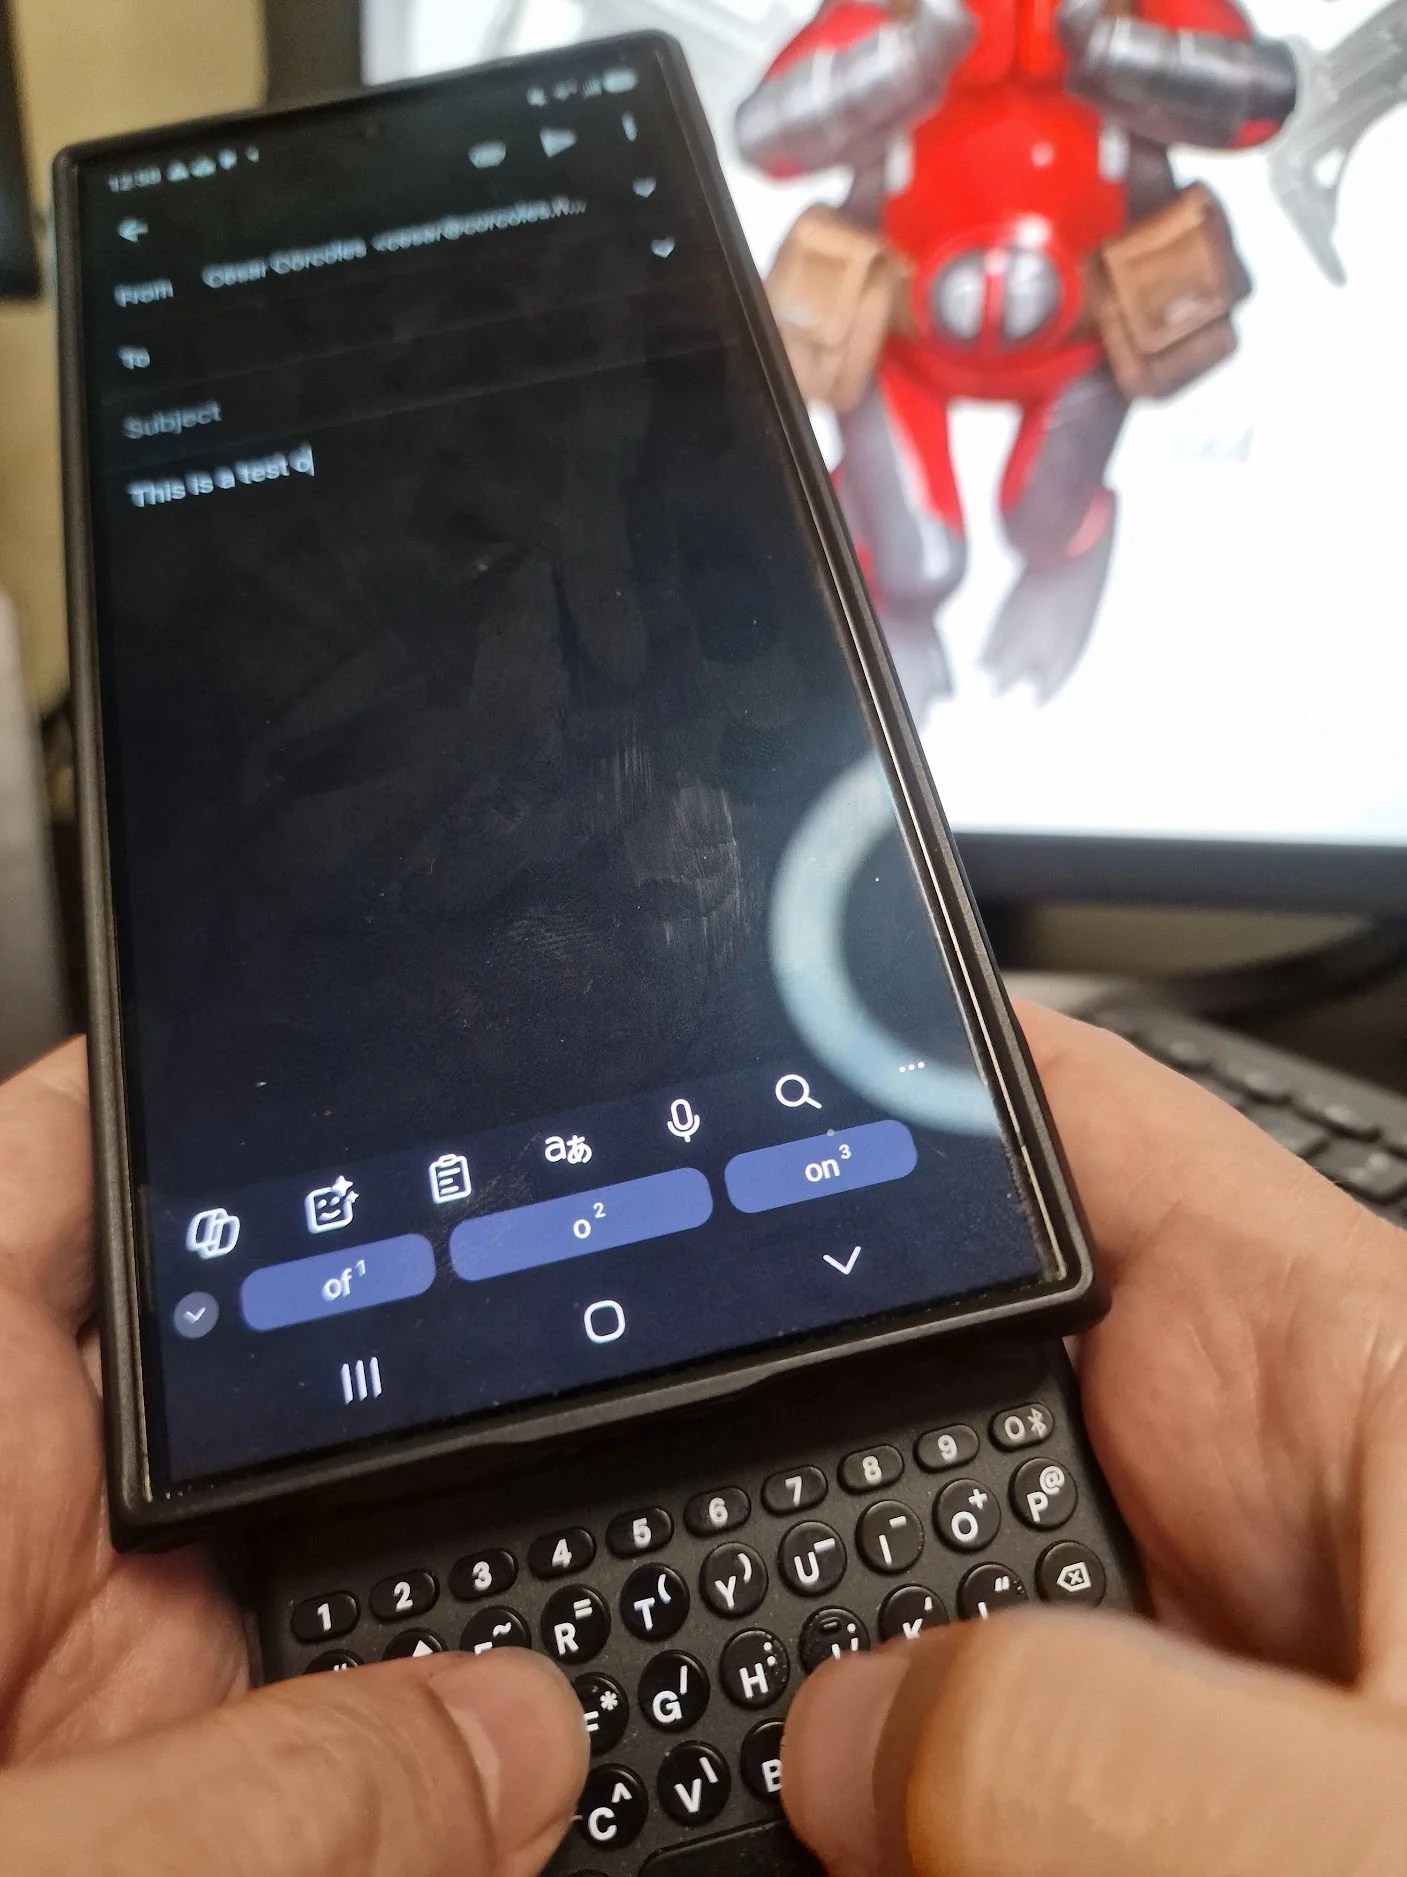
O sea que cuando Clicks anunció el Kickstarter de su Power Keyboard, para allá que nos fuimos, no sé si con mucho convencimiento en el producto, pero sí con todas las ganas de votar (en dinero) por el resurgimiento del teclado físico para el móvil. Y el tecladín, con los retrasos habituales de los kickstarters, llegó a casa hace ya unas cuantas semanas, pero entre unas cosas y otras, no habíamos encontrado un momento para reseñarlo por aquí.

Lo primero que debe decirse es que la ingeniería y la calidad de materiales del teclado son excelentes: en Clicks no han escatimado esfuerzos: el dispositivo es contundente hasta el nivel arma de asalto, las teclas en sí parecen preparadas para escribir la próxima Odisea, la conexión al ordenador, tanto físicamente, vía MagSafe, como lógicamente, a través de Bluetooth con soporte para hasta diez dispositivos, funciona a la perfección, y el software que alimenta el teclado no da ningún problema.

Ahora bien.

Conecte usted los 180 gramos del teclado1 a los doscientos gramos del móvil medio (233 pesa el S24 Ultra de la foto), y la cosa se va a un peso que no es de recibo. Si encima el móvil no es nativamente MagSafe (diría que en el mundo Android solo la última generación de Pixels lo es), pues además hay que sumar una funda que no hace nada bueno ni por el peso ni por el volumen del invento.

Vaya, que en la práctica, si el móvil no es un iPhone Air, con sus 165 gramos, no le veo yo la utilidad práctica2 al teclado más allá de la demostración de ingeniería.

Ahora bien: sigo queriendo creer. Clicks anunció junto al teclado su Communicator, una suerte de Blackberry que, para los que fueron adictos al añorado cacharro canadiense, pueden resultar una tentación irresistible…

  1. El peso se explica en parte porque se incluye una batería de 2300 mAh capaz de alimentar inalámbricamente el móvil, además de mantener en funcionamiento la electrónica del teclado. Pero también es necesario un cierto peso para poder soportar el móvil correctamente sin que la distribución de peso se haga extremadamente incómoda. ↩︎
  2. No es del todo cierto: esa capacidad de conectar el teclado a múltiples dispositivos puede hacer que sea útil para los múltiples dispositivos «smart» que uno pueda tener en casa, comenzando por la tele… ↩︎

2026-07-26

Veinte años de bloguero (Adrián Perales)

El pasado 21 de julio se cumplieron 20 años desde que empecé con esto de los blogs.

Yo he cambiado y el blog ha cambiado conmigo, hay meses en los que no hay una sola entrada nueva, pero mi manera de entender internet es, aún hoy y en buena parte, la misma que en 2006. Me gusta tener un rinconcito en internet donde comentar los temas que me interesan en cada momento, sin ninguna pretensión.

Me encanta saber que, aunque poquitas, hay personas al otro lado que me leen y les interesa lo que cuento. Me encanta ver a personas que me leen desde hace años.

No diré aquello de «por otros veinte años» porque si algo no ha cambiado en mí es que soy una persona extremadamente variable y veinte años son muchos años. Sí diré que este blog seguirá aquí por una buena temporada, y estaré tan encantado como siempre de recibir comentarios e interacciones a partir de mis pensamientos.

¡Seguimos!

2026-07-17

Mundial 2026 – Los rivales de la Roja (VIII): Argentina (La Página Definitiva)

Hora de rematar

2026-07-12

Mundial 2026 – Los rivales de la Roja (VII): Francia (La Página Definitiva)

La Bastilla que nos falta

2026-07-09

Mundial 2026 – Los rivales de la Roja (VI): Bélgica (La Página Definitiva)

La Batalla por Puigdemont

2026-07-05

Mundial 2026 – Los rivales de la Roja (V): Portugal (La Página Definitiva)

La otra cara de la moneda ibérica.

2026-07-02

Texto a voz y GNU/Linux en 2026 (Adrián Perales)

Con mi resto visual, una de las opciones de accesibilidad que más uso es la lectura de texto en voz alta («Texto a voz», «Text to speech» o TTS). En los sistemas de Apple viene VoiceOver integrado y hay apps como VoiceDream que lo convierten en una característica cómoda y deseable, con voces que suenan muy bien (todas privativas, claro). Pero en GNU/Linux la cosa cambia. En esta entrada repaso algunas de las opciones que he encontrado.

El problema de base

Desde mi vuelta a GNU/Linux he probado Fedora y KDE Neon, y ambos tienen como sistema de texto a voz un motor llamado espeak-ng. Las voces que ofrece son, por decirlo suavemente, muy poco naturales.

Al buscar por el asunto, rápidamente encontramos speech-dispatcher, con el que podemos encontrar otros motores. Sin embargo, en mi experiencia no era fácil de configurar ni sabía de voces en español.

Otro sistema que me recomendaron en el fediverso es Piper, pero no le dediqué el suficiente tiempo como para configurarlo.

(Nótese que, de normal, a día de hoy soy bastante vago con mi sistema operativo: si no encuentro una opción no dedico tiempo a investigar para configurarlo.)

Algunas aplicaciones dedicadas

Dado que hay motores de IA generativa que ofrecen instalar voces en local, han aparecido varias aplicaciones que se pueden instalar en nuestro sistema para acceder a voces más naturales.

Parlou es una aplicación con diseño de Gnome que tiene de base el sistema Piper y tiene voces para distintos idiomas, incluido el español. Tiene opciones de configuración como cambiar la voz, la velocidad, el tono y guardar el resultado como audio, pero no ofrece controles para cambiar de párrafo.

VoiceGen y SpeechNote tienen la misma limitación: no permiten movernos entre párrafos. Ambos ofrecen voces de diferentes motores, y SpeechNote tiene más características.

El principal problema de estas opciones, además del espacio en disco que requieren ciertas voces, es que necesitamos pegar el texto en la aplicación. No podemos leer directamente en el navegador ni pegarles una URL para que detecte el texto.

Una solución suficiente

Suficiente, que no perfecta, es instalar el motor RHVoice y configurarlo como predeterminado en nuestro sistema, lo cual nos permitirá usar Firefox como nuestra aplicación de texto a voz. Vamos por partes.

RHVoice va primero. Es un motor TTS libre que, en el momento de escribir estas líneas, ya ha añadido soporte para voces en español, aunque solo con acento latinoamericano.

En una página de su web nos explica cómo instalarlo en GNU/Linux, unas instrucciones fácilmente comprensibles para quien controle un poco de inglés, por lo que no veo necesario transcribirlas aquí. Yo fui capaz de seguirlas sin mayor complicación, y no recuerdo haber hecho nada en particular para configurarla como voz por defecto del sistema.

La voz que nos interesa es Mateo, la única disponible en español.

Una vez hecho esto, podremos hacer uso de la nueva voz en cualquier aplicación del sistema. Por ejemplo, las aplicaciones de KDE Plasma suelen ofrecer una opción para leer texto seleccionado.

Pero, en mi experiencia, la mejor aplicación TTS en Linux es el mismo modo de lectura de Firefox, que funciona con cualquier artículo de la web que nos crucemos y dispone de un control para la velocidad de lectura y botones para cambiar de párrafo, justo lo que echo en falta en las otras opciones.

Si queremos escuchar un texto que hayamos escrito nosotros, es cuestión de exportarlo como HTML y pasarlo al navegador. Cualquier editor Markdown competente ofrece la opción.

En definitiva

Ojalá las aplicaciones dedicadas sigan evolucionando para poder pasarles una dirección web o arrastrar un archivo para que nos lo lean, además de añadir los susodichos botones para cambiar de párrafo. Respecto a las voces del sistema, lo ideal sería que las distribuciones GNU/Linux modernas ya trajeran RHVoice (u otro motor más moderno) instalado de serie.

Creo que a las distribuciones GNU/Linux aún les queda trabajo en cuanto a la accesibilidad. Tan solo KDE Plasma ofrece por defecto el seguimiento del cursor de texto con zoom, y a la vista está que aún queda camino con el tema de las voces.

Pero, mientras esperamos y seguimos las novedades, la combinación RHVoice con el modo de lectura de Firefox es, como decía, una solución suficiente.

No es perfecta porque aún no tiene voces para español de España (no es imprescindible pero se agradece por la costumbre), requiere algún paso intermedio y no podemos hacernos una «playlist» como con VoiceDream. Pero todo se andará.

El mundo del software libre va lento pero seguro, y estoy convencido de que la accesibilidad será otro campo donde los usuarios estaremos bien provistos, aunque haya que esperar un poco.

2026-07-01

Mundial 2026 – Los rivales de la Roja (IV): Republik Österreich (La Página Definitiva)

¿Cómo que dieciseisavos?

2026-06-25

La adultez está siendo mi mejor etapa (Adrián Perales)

Aunque la juventud sea un tesoro divino y muchos digan que cualquier tiempo pasado fue mejor, estoy muy contento con la etapa vital en la que me encuentro.

Siempre he sido una persona introvertida. Me costaba mucho iniciar el contacto con otra persona y me veía muy alejado de los intereses típicos de mi edad.

Mientras mis compañeros de clase salían a beber, yo me quedaba en casa disfrutando de cultura o probando programas en mi ordenador.

Mientras otros estaban con las hormonas revolucionadas, a mí jamás me ocurrió (soy asexual o algo).

He dedicado buena parte de mi vida a mi objetivo de ser profesor y esa fijación hizo que renunciara a muchos planes y grupos. Cuando terminé la carrera decidí que debía abrirme un poco más a los demás, y mi manera de relacionarme cambió a mejor.

Desde que empecé a trabajar he pasado por muchísimo estrés, lo que me llevó a la baja de 2024, pero incluso con eso he tenido muchos más planes y experiencias bonitas en los últimos años que en mi juventud.

Ahora, de adulto, estoy mucho más a gusto conmigo mismo y con los demás.

Estoy muy cerca de decir que se mitifica mucho la juventud, pero entiendo que mi experiencia no es la habitual. Yo no experimenté esa rebeldía o esa llamada diversión normativas. Pero sí creo que se infravalora la adultez.

Si la juventud es la época de la rebeldía, yo soy mucho más rebelde ahora que tengo maneras de lograr que otras personas reflexionen y que mi conciencia social ha crecido muchísimo.

Si la juventud es la época de diversión, yo me divierto mucho más ahora con adultos que quedan para tomar algo y no para pasar frío y ligar toda la noche.

(Esto último es una simplificación, evidentemente, pero hasta hace muy poco no entendí el porqué del boteellón.)

Desde que cumplí los treinta me he esforzado mucho en equilibrar mi vida personal y laboral (aún me queda mucho por mejorar ahí), introduje el ejercicio (que se ha convertido ya en parte de mi rutina), he viajado, he fortalecido mi relación con mis cercanos y he conocido a gente maravillosa.

No me gusta decir que aún soy joven. No deberíamos empujar la juventud hasta el infinito. Considero que mi adultez empezó con mi trabajo, a los 25 años, momento en el que empecé a tomar decisiones vitales que me han llevado a ser quien soy ahora mismo.

Muchos dirán que no he vivido mi juventud. Y me da exactamente igual. He vivido la vida como ha venido, a mi forma. Y mi adultez, claro, está muy marcada por el hecho de que no he iniciado una familia, que lo cambiaría todo.

Así que sí, en suma, considero que la adultez está siendo mi mejor etapa vital. Quiero vivir una adultez sana, a gusto conmigo mismo, y si me toca pasar por otra etapa más tarde de lo habitual, estoy dispuesto.

2026-06-24

Mundial 2026 – Los rivales de la Roja (III): República Oriental del Uruguay (La Página Definitiva)

Entre hispanos anda el juego.

2026-06-20

Mundial 2026 – Los rivales de la Roja (II): Arabia Saudí (La Página Definitiva)

El ISIS bueno.

2026-03-14

Perdiendo el miedo a la red oscura: una breve introducción (Página de inicio on Un sitio solicitado por la comunidad, para la comunidad)

El otro día, tras montar y probar un par de contenedores con herramientas actualizadas, me sentí preparado para conectar la instancia de la comunidad de NVDA de Mastodon a la red oscura. Me intriga conocer ese lado del fediverso, saber quién monta instancias allí y por qué, ver qué se publica, y dar a mis usuarios la oportunidad de hacer lo mismo. Pero como estos temas traen controversia, decidí preguntar primero, y dar marcha atrás en cuanto alguien dijera que no. Y alguien dijo que no, por lo que la misión quedó interrumpida. Pero me pidieron que escribiera sobre el tema, y aquí estamos.

En esta entrada quiero hablar de Tor e I2P, los dos proyectos que más destacan relacionados con navegar de forma anónima por Internet y evitar la censura impuesta en algunos países. Porque esos son sus propósitos iniciales, aunque luego se usen para otra cosa. Como toda herramienta, se pueden usar bien o usar mal. En este caso, la web oscura ha dado lugar a toda clase de leyendas (y hasta películas de terror) por su mal uso por parte de delincuentes que la emplean para traficar con armas, pornografía, violencia extrema, coordinar asesinatos y a saber qué más. Y no por ello hay que demonizarla, al igual que se hacía con el p2p a principios de siglo, donde estaba extendido el rumor de que en el momento que usaras p2p, la policía se presentaba en tu casa. Por cierto, ¿sabías que al llamar por WhatsApp a un contacto usas P2P? Al final, el término alude a una conexión directa entre dos equipos, simplemente. En fin, no me voy a extender más con ese tema, vamos a lo interesante.

TOR

TOR son las siglas de The Onion Router, el enrutador de la cebolla. Según Wikipedia, su lanzamiento inicial se produjo en septiembre de 2002, así que ya lleva casi un cuarto de siglo entre nosotros. Su objetivo es construir una red sobre Internet donde se preserve el anonimato de las comunicaciones, y el destinatario de las mismas (por ejemplo, un servidor) no conozca su origen (dirección IP del cliente). Esto se consigue montando un circuito formado por varios nodos que cifran y retransmiten las comunicaciones entre origen y destino. Por defecto, un circuito está formado por tres nodos, y añadir más no es garantía de mayor anonimato, pero sí de mayor lentitud. La arquitectura de TOR se podría dividir en los siguientes componentes:

  • Cliente: se encarga de cifrar las comunicaciones en origen y establecer un circuito de varios nodos. Existe el mito de que un cliente puede redirigir tráfico de la red TOR de otros usuarios. Antes era así, pero ahora es mentira, sólo dirigirá tu propio tráfico hacia donde tú le indiques. El cliente también puede ofrecer servicios ocultos.
  • Repetidor: los repetidores son nodos que distribuyen el tráfico por la red TOR. Son mantenidos por voluntarios u organizaciones.
  • Nodo de salida: es el nodo que actúa como salida de un circuito. Su propósito es descifrar las comunicaciones, enviarlas a destino, cifrar la respuesta y enviarla de vuelta por el circuito hasta el origen.
  • Directorio: el directorio contiene un listado de nodos que actúan como repetidores, nodos de salida, políticas de salida de estos nodos y datos sobre servicios ocultos (explicados más adelante). Existen varios directorios, ya que si hubiera uno solo y fallara, toda la red se caería.

Un mismo nodo puede ejercer como repetidor, nodo de salida y cliente, y son los que garantizan más anonimato. Sin embargo, requieren diversos trámites para ser incluidos en los directorios y exponen a sus propietarios ante las autoridades, por lo que lo más sencillo es ejecutar simplemente un cliente, que además no requiere que se abran puertos en el router ni ningún otro tipo de configuración.

Clientes disponibles

El programa TOR es un cliente minúsculo que se maneja desde consola y se suele ejecutar como servicio. Si habías oído que TOR es un navegador, te has topado con otro mito. Es habitual confundir TOR con TOR Browser, el navegador recomendado por el proyecto que también lleva TOR incorporado. Veamos cómo instalar y configurar cada uno de ellos en Windows.

TOR Browser

TOR Browser es un navegador web basado en Mozilla Firefox ESR. Es tan accesible con lectores de pantalla como Firefox y, a excepción de algunas opciones de menú y botones propios, tiene la misma interfaz. Tor Browser cuenta, además, con un perfil configurado a medida, extensiones preinstaladas y otras modificaciones cuyo objetivo es lograr un mayor grado posible de anonimato y protección de la privacidad equilibrado con una experiencia de navegación adecuada. Esto significa que podemos configurarlo para que nos proteja aún más de lo que ya lo hace. Por ejemplo, aumentando al grado máximo las restricciones de la extensión Noscript.

Para descargarlo, podemos acudir a la página de descarga de Tor Browser, buscar la tabla y elegir el instalador de la plataforma que corresponda. En este caso, para Windows de 64 bits, dejo el enlace a la versión 15.0.13, la actual mientras escribo esta guía. No uses este enlace si hay una versión posterior. Como veremos más adelante, mantenerse actualizado en este terreno no es opcional, sino una precaución más. Si quieres actualizar el navegador, conéctalo a la red TOR, ve al menú Ayuda y elige la opción Acerca de, tal y como harías con Firefox.

El instalador es muy simple. De hecho, lo único que hace es extraer un portable, y crear accesos directos en el escritorio y el menú Inicio. Así que, llegado el momento de desinstalar, será suficiente con borrar la carpeta del portable y los accesos directos. La ubicación de instalación que ofrece de manera predeterminada es el escritorio, y se puede desmarcar la creación de accesos directos para tener todo más organizado. Una vez instalado, para abrirlo, entraremos en la carpeta Tor Browser y ejecutaremos el acceso directo Tor Browser.

Primera experiencia de navegación

Al arrancar Tor Browser por primera vez, detectará el idioma del sistema y adaptará su interfaz. Esto significa que desde el principio lo tendremos en español si nuestro sistema está en español. Lo primero que se muestra es una pantalla de conexión, con un botón para conectar, otro de configuración de conexión que casi nunca suele ser necesario, y un interruptor para que se conecte automáticamente al abrir el navegador. Pulsamos el botón Conectar y esperamos a que se complete la conexión. Si quieres desconectarte, cierra el navegador, y TOR se cerrará automáticamente con él.

Una vez el navegador se ha conectado a la red TOR, podemos abrir cualquier página web que visitemos con frecuencia. Como se establece un circuito de nodos aleatorio, el propietario de la web verá una conexión que se produce incluso desde otros países, y sólo tendrá aquella información que tú quieras proporcionarle. Además, si la conexión es https, añade una capa de cifrado extra para impedir que el propietario de un nodo de salida intercepte y vea claramente tus comunicaciones. Como ejemplo, visita la página principal de la audiocinemateca. Observa que tarda un poco más en cargar, pero por lo demás funciona como siempre.

La primera vez que se visite una página, el navegador preguntará si deseamos solicitar las versiones en inglés de las páginas para mejorar nuestro anonimato. Si has elegido la audiocinemateca como te he indicado, observarás algo más: tiene un servicio cebolla disponible. Esto se debe a que mi servidor le indica a Tor Browser, mediante la cabecera Onion-Location, que ofrezco ese servicio. Dile que “Ahora no” quieres visitarlo, lo siguiente que haremos será aprender a buscarlos a mano.

En la red TOR, las personas y entidades que proporcionan servicios también tienen derecho a ser anónimas. Por ello, un cliente puede ofrecer servicios ocultos o servicios cebolla, y sin abrir puertos ni nada que se le parezca. Estos servicios son más seguros que un servidor tradicional, ya que el usuario no abandona la red TOR por ningún nodo de salida para visitarlos. Simplemente, al igual que el usuario establece un circuito de varios nodos, el servicio hace lo propio hasta un punto de encuentro común, y establecen una conexión cifrada.

En lo que se refiere a web, los servicios ocultos suelen funcionar por http, dejando el cifrado en manos de TOR. Las conexiones seguras por https son poco frecuentes, ya que las pocas entidades que ofrecen certificados son de pago, y en cierto modo la transacción rompe el anonimato de quien ofrece el servicio. Sin embargo, si el propósito de la entidad es únicamente ofrecer una vía más segura y no desea ser tan anónima, https se puede usar y cumple su función de maravilla.

Cuando una web dispone de un servicio oculto y avisa de ello,Tor Browser mostrará un botón cerca de la barra de direcciones. Estando en la audiocinemateca, pulsa alt+d para ir a la barra de direcciones. Después, pulsa tabulador hasta el botón “Añadir esta página a marcadores”, y luego flecha derecha. Llegarás a un botón llamado “.onion disponible”. Si lo pulsas, se recargará la página. Podrás usar la audiocinemateca como siempre, pero en la barra de direcciones verás esto: https://3vynrelomm3k43lqhetkztg2o25eif4hrppodo225gqhvglxv3bc7jqd.onion/. Poco intuitivo, ¿verdad? Es el valor hash de una clave pública. En la red TOR, por desgracia, no se pueden comprar ni usar nombres de dominio. Si acaso, algún servicio más caro de lo que querríamos pagar ofrece la posibilidad de generar certificados hasta que la clave pública comience por las letras o palabras deseadas.

Existen montones de servicios ocultos sin un equivalente en la web ordinaria. En esta entrada no hablaremos de ellos, pero sí aprenderás a montar el tuyo propio. Para todo lo demás, busca por ahí.

TOR, sin navegador

Como dijimos, TOR es un pequeño programa independiente que se puede instalar y usar como cualquier otro programa. A mí me gusta compilarlo desde el código fuente, pero es una tarea algo compleja cuya explicación queda fuera del propósito de esta entrada. Cuando se ejecuta por sí solo, TOR ofrece un proxy de tipo SOCKS5 en el puerto 9050. Se puede configurar cualquier aplicación que use TCP y tenga soporte de servidores proxy para que se conecte a través de la red TOR. La configuración de puertos, maneras de usar la red y otros ajustes es demasiado extensa para explicarla, pero los valores por defecto son razonablemente seguros como punto de partida.

Para descargar la versión más reciente, podemos acudir a la página de descarga de TOR y elegir la expert bundle más adecuada para nuestra plataforma. La versión actual es la 0.4.9.8 y, de nuevo, advertimos que debe mantenerse actualizada por seguridad. Si no tienes tiempo de actualizar, es mejor que TOR permanezca apagado. La plataforma también importa, no sólo por rendimiento, sino por capacidad criptográfica. Dicho de otro modo: no elijas TOR para Windows de 32 bits si tu Windows es de 64.

Una vez descargado, vamos a descomprimirlo en una ubicación conocida. Por ejemplo C:\tor. Al hacerlo, deberíamos ver 3 subcarpetas: data, tor y docs. A continuación, crearemos un fichero de configuración. Con tu editor favorito, crea el archivo C:\tor\torrc y añade el siguiente contenido:

GeoIPFile C:\tor\data\geoip GeoIPv6File C:\tor\data\geoip6 AvoidDiskWrites 1 ControlPort 9051 CookieAuthentication 1 DataDirectory C:\tor\data TruncateLogFile 1 log notice file C:\tor\data\tor.log

Con estos ajustes, le indicamos a TOR algunas rutas básicas, le pedimos que no escriba en disco si puede evitarlo, y que borre el archivo de registro anterior cuando se reinicie. También le indicamos el puerto donde podrá recibir instrucciones de control (si usamos software compatible con ello) y la forma de autentificarse al conectar por dicho puerto. Ahora, instalaremos el servicio. Para ello, sigue estos pasos:

  1. Abre una consola como administrador. Pulsa Windows+r, escribe cmd y pulsa control+shift+intro.
  2. Navega a la carpeta de TOR: cd C:\tor.
  3. Instala el servicio, indicando dónde está la configuración: tor\tor --service install --options -f C:\tor\torrc.
  4. Si todo ha ido bien, el servicio se instalará y se pondrá en marcha. Utiliza la consola de services.msc para gestionar su modo de arranque, iniciarlo y detenerlo, como harías con cualquier servicio.

Ahora que has instalado TOR, puedes configurar el proxy de tu navegador usando el tipo SOCKS5, host 127.0.0.1 y puerto 9050. Puedes, pero te recomendamos que no lo hagas. Recuerda protegerte bien y usar un navegador especializado, o una app que tenga cualquier otro propósito, o un entorno suficientemente controlado por tu parte.

Para desinstalar TOR, ejecuta este comando como administrador: C:\tor\tor\tor --service remove. Si lo deseas, borra a continuación su carpeta.

Nuestro primer servicio oculto: un servidor de NVDA Remote

Cada cliente TOR puede ofrecer a la red tantos servicios ocultos como quiera. Los más conocidos son sitios web, pero también se pueden levantar servidores de correo electrónico, chat, o cualquier cosa que admita conexiones TCP. Al contrario que sucede con los programas cliente, los servidores no tienen que estar preparados para ningún tipo de proxy. A todos los efectos, sus conexiones entrantes llegarán siempre por 127.0.0.1, y un puerto aleatorio, por lo que por esa vía no podremos identificar a nuestros visitantes. Vamos a preparar un servidor de NVDA Remote siguiendo estos pasos:

  1. Instala un servidor de NVDA Remote en Windows (usa esta guía). Genera un certificado nuevo para él y ponlo en marcha.
  2. Crea una carpeta para el servicio oculto, por ejemplo C:\tor\data\remote.
  3. Edita el archivo torrc, que dejamos en la carpeta C:\tor y añade el servicio oculto.
  4. Reinicia TOR.
  5. Accede a la carpeta que creaste para el servicio, y observa que ahora tiene algunos archivos. Abre el archivo hostname con un editor de texto. Su contenido es la dirección del servicio oculto recién creado, que se puede compartir o publicar según sea necesario.

Sí, lo sé, no he explicado qué hay que añadir al archivo torrc, no quería que se me descuadrara la lista de pasos. Simplemente, pon estas líneas:

HiddenServiceDir C:\tor\data\remote HiddenServiceEnableIntroDoSDefense 1 HiddenServicePort 6837 127.0.0.1:6837

Estas líneas pueden repetirse tantas veces como sea necesario para añadir varios servicios. Mantén a salvo la carpeta del servicio, ya que contiene información sensible que un atacante podría usar para replicarlo, como las claves privadas. Si borras o pierdes la carpeta, perderás esa dirección de servicio sin posibilidad de recuperación.

Ahora, en NVDA, instala los complementos TeleNVDA y Soporte proxy. Abre las opciones de NVDA y ve a la categoría Proxy. En el grupo “Todo el tráfico”, indica que usarás un proxy de tipo SOCKSv5, dirección localhost, y puerto 9050. Para finalizar el experimento, conéctate con TeleNVDA indicando la dirección de tu servicio oculto en el campo “Equipo o servidor”. Observa que aunque tanto tu copia de NVDA como el servidor están en el mismo ordenador, la conexión se establece pasando por un circuito bastante extenso, por lo que irá lenta.

I2P

I2P se define a sí mismo como “el Internet invisible”. Su propósito es similar al de TOR: crear una red cifrada sobre Internet que permita una navegación anónima y privada. Sin embargo, tiene varias diferencias que debemos conocer:

  • No está pensado para visitar servicios fuera de I2P: existen algunos nodos de salida para navegar por la web, pero pueden funcionar de forma intermitente. I2P se centra más en los contenidos de la propia red I2P.
  • Es una red distribuida: mientras que TOR tiene directorios centrales, I2P dispone de una base de datos de red descentralizada a lo largo de enrutadores con buen ancho de banda, ejecutados por voluntarios y elegidos aleatoriamente por la red. Sus únicos puntos centrales son los servidores de resembrado, utilizados para conectar a la red a nuevos nodos que se ejecutan por primera vez.
  • Las direcciones de los servicios I2P son también valores hash de claves públicas, pero se pueden personalizar mucho más que las .onion. Cada enrutador I2P dispone de una libreta de direcciones, que asocia nombres de servicios a hashes de claves, similar al archivo hosts de un sistema operativo.
  • Cada usuario, por defecto, participa en la red redirigiendo tráfico de otros usuarios y formando parte de uno o varios túneles, lo que mejora el anonimato. Para ello, se cede ancho de banda de nuestra conexión. Como veremos, este comportamiento se puede desactivar para usar la red como nodo oculto. En condiciones óptimas en las que se cede ancho de banda, I2P requiere un puerto aleatorio abierto en el router. Si el router dispone de UPNP y lo tiene activado, I2P gestionará este puerto por sí mismo.
  • No hay ninguna entidad que expida certificados SSL válidos. Los certificados son menos habituales que en TOR, y están autofirmados.

El enrutador principal ofrecido por el proyecto I2P está programado en Java. Se trata de una solución autocontenida, más pesada que TOR, que incluye aplicaciones como un cliente de correo, un cliente BitTorrent y un servidor web propios, todos ellos centrados en preservar el anonimato y la privacidad. La consola del enrutador está traducida a español, y permite configurar, activar y desactivar módulos y túneles según sea necesario. Nuevamente, es tan extenso que no vamos a explicar todo. De hecho, puesto que la interfaz es más intuitiva y la documentación tiene una buena parte traducida, no hablaremos de cómo crear un servicio oculto propio. Veamos cómo instalarlo paso a paso en Windows.

Instalación de Java

Como todo buen software basado en Java, el primer paso para que I2P funcione es instalar Java. La versión 8, la que tradicionalmente se instala desde java.com, ya no es válida. Se necesita Java 17 o posterior. La versión actual más reciente es la 26, y su instalador se puede obtener desde el siguiente enlace:

Descarga el JDK de Java 26

La instalación no tiene mucho misterio, tan sólo hay que seguir las pantallas del asistente. Si dispones de varios entornos Java, asegúrate de que Java 26 es el que se ofrece por defecto. Desde una consola, ejecuta el comando java -version para averiguarlo. Si aparece una versión anterior, modifica las variables de entorno del sistema, en particular path y, si existe, JAVA_HOME. Para acabar, agrega los archivos java.exe y javaw.exe al firewall de Windows para que puedan operar sin restricciones.

Instalación de I2P

I2P no es tan portable como TOR. Ofrece dos modalidades de instalador: un archivo de gran tamaño con Java incorporado y ciertos plugins de navegador, y un instalador más sencillo que depende de Java y no incorpora tantos elementos. Por suerte o por desgracia, el segundo es el más accesible, tanto durante la instalación como después, así que es el que usaremos.

La versión actual de I2P es la 2.12. Puedes descargar el instalador con este enlace directo, o visitar la página de descargas en caso de que haya una versión más reciente.

El instalador es intuitivo. Tan sólo hay que seguir las pantallas del asistente, con una particularidad: en la pantalla de selección de componentes debemos buscar la tabla y marcar la casilla “Windows service”. El servicio de Windows es la forma más accesible de gestionar el funcionamiento de I2P.

Una vez creados los accesos directos, llegaremos a la última pantalla. Tras pulsar el botón “Hecho”, el servicio se pondrá en marcha por sí solo e I2P estará listo para funcionar.

Para desinstalar I2P, navega a la ruta “C:\Program Files\i2p” y ejecuta el archivo uninstall_i2p_service_winnt.bat. Esto desinstalará el servicio, al igual que install_i2p_service_winnt.bat lo reinstala de nuevo. Después, ejecuta el archivo uninstaller.jar que hay dentro de la carpeta uninstaller. Desde consola, se puede ejecutar java -jar uninstaller.jar. La configuración de i2p y todos los datos, por su parte, se encuentran en “C:\Program data\i2p”, y deben eliminarse a mano.

En cuanto a las actualizaciones, se descargan y se instalan por sí solas de forma transparente mientras el servicio esté en marcha. Es recomendable dejar encendido el gestor de torrents, ya que se usa como canal de intercambio por defecto.

Configuración inicial de I2P

Ahora que el servicio de I2P está en marcha, podemos acceder a la consola web. Para ello, se puede abrir el acceso directo “I2P router console” que hay en el escritorio o, desde un navegador, se puede visitar la siguiente dirección: http://localhost:7657

La primera pantalla que se mostrará al entrar es la selección de idioma. Se puede omitir la configuración inicial, pero es recomendable no hacerlo y seguir el asistente hasta el final. Las pruebas de ancho de banda, si bien es cierto que también se recomiendan, pueden omitirse para no revelar a M-Lab nuestra dirección ip. Al completarlas, I2P sugerirá unos valores máximos de entrada y salida, y nos preguntará cuánto ancho de banda deseamos compartir. El valor predeterminado es 80%, pero se puede bajar al 0. No obstante, esto todavía no oculta nuestro enrutador.

Para evitar formar parte de túneles de otros enrutadores, visitaremos la página de configuración de red de la consola, elegiremos la opción “Modo oculto - no se publica la IP (evita el tráfico participante)” y pulsaremos el botón Guardar cambios. Desde este momento, I2P ya no requiere puertos abiertos al exterior, ni usará UPNP para redirigirlos cuando esté disponible. El “modo portátil” también puede ser útil si istalamos I2P en un ordenador portátil y cambiamos con frecuencia de red.

La libreta de direcciones

El potencial de I2P radica en sus servicios ocultos. Por defecto, al igual que sucede en TOR, la dirección de un servicio oculto es el hash de una clave pública, acabado en “.b32.i2p”. Por ejemplo, la dirección de la audiocinemateca en I2P es huffwds7ecz2atf2kzljvykkazoper444ehrp5nfkgdxgzkrp2oq.b32.i2p. Gracias a la libreta de direcciones, se puede crear un nombre más amigable, como audiocinemateca.i2p, mucho más sencillo de memorizar, escribir en la barra de direcciones del navegador y almacenar en marcadores.

La libreta de direcciones se gestiona desde su página correspondiente en la consola. Hay cuatro tipos de libretas:

  • Privada: contiene un listado de direcciones que no queremos compartir con otros usuarios de I2P.
  • Local: contiene un listado de direcciones propio que se puede compartir con otros usuarios.
  • Publicada: contiene direcciones que se publican para que otros usuarios puedan sincronizar su libreta con la nuestra, siempre que estemos sirviendo un sitio web por I2P y hayamos dado permiso para compartirla. Se sincroniza con la local, pero no tiene por qué coincidir con ella.
  • Router I2P: contiene direcciones obtenidas de un servicio de suscripción.

En la página de suscripciones podemos gestionar desde qué servicios se actualiza la libreta del enrutador. Por defecto se ofrece uno, mantenido por el proyecto I2P y con muy pocas entradas. A continuación dejo algunos más que se pueden agregar debajo:

http://notbob.i2p/hosts-all.txt http://reg.i2p/export/hosts-all.txt http://skank.i2p/hosts.txt http://stats.i2p/cgi-bin/newhosts.txt

La audiocinemateca está registrada en varios de estos servicios, por lo que tan pronto como se sincronicen, podrás entrar escribiendo audiocinemateca.i2p en la barra de direcciones del navegador.

Existe una forma alternativa y rápida de añadir entradas si no podemos o no queremos sincronizar libretas externas. El propietario de un sitio web puede proporcionarnos un enlace como este: http://audiocinemateca.i2p/?i2paddresshelper=huffwds7ecz2atf2kzljvykkazoper444ehrp5nfkgdxgzkrp2oq.b32.i2p.

Al visitarlo con el navegador, aparecerá una ventana de la consola preguntando qué queremos hacer. Se puede agregar la entrada a cualquiera de las libretas disponibles, o no hacer nada y simplemente navegar al destino.

Configuración del navegador

Hasta ahora, hemos configurado el enrutador de I2P, un proceso que no entraña riesgos de seguridad. Los riesgos vienen al navegar, a pesar de que el propio enrutador ofrece una serie de protecciones para mitigarlos, como la eliminación de ciertas cabeceras http. A grandes rasgos, el proceso consiste en configurar el navegador para que utilice el proxy http que hay en la dirección 127.0.0.1, puerto 4444. Sin embargo, en este apartado vamos a hacer algo más: configurar un perfil alternativo sólo para navegar por aquí, manteniendo el resto de nuestros datos bien asegurados y apartados en el perfil por defecto. El navegador, por supuesto, será Firefox en su última versión. Sigue estos pasos:

  1. Pulsa Windows+r para abrir el diálogo Ejecutar, escribe firefox -p y pulsa intro. Aparecerá una ventana de selección de perfil.
  2. Crea un nuevo perfil con el nombre que prefieras. Por ejemplo, puedes llamarlo i2p.
  3. Selecciona el perfil en la lista y pulsa intro para usarlo. Firefox arrancará como si se hubiera instalado por primera vez.
  4. Configura Firefox para que sea tan privado como permitan las opciones.
  5. Ve a los ajustes de Firefox, pulsa el botón “Configuración” que hay en la primera pantalla e indica los datos del proxy, que redirigirá tanto el tráfico http como el https. Recuerda: el host es 127.0.0.1 o localhost, y el puerto 4444.
  6. Navega por la red I2P con normalidad (y con cuidado).

Para dejar de navegar por I2P, vuelve a ejecutar firefox -p y regresa al perfil por defecto.

A continuación, enumero algunas configuraciones y consejos que pueden ser útiles para aumentar el grado de privacidad:

  • Instalar la extensión noscript y configurarla en modo estricto, exactamente como hicimos con Tor Browser.
  • Activar el modo permanente de navegación privada.
  • Bloquear todos los rastreadores y cookies, quitando las excepciones de la protección máxima. No te preocupes, las webs funcionarán.
  • Deshabilitar las protecciones contra software fraudulento o descargas peligrosas, así como el envío de informes de error, y la recomendación de extensiones y funciones mientras se navega. De esa forma se reduce el envío de datos a Mozilla.
  • Deshabilitar la reproducción de contenido con DRM.
  • La casilla “Pedir a los sitios web que no compartan ni vendan mis datos” parece útil, pero sólo envía una cabecera http extra, no nos aportará nada.
  • Existen ajustes adicionales para reducir nuestra exposición en general y nuestra huella de navegación, pero deben activarse en about:config.
  • Para otros servicios de I2P que no sean web, tales como correo, chat o intercambio de archivos, se recomienda usar las aplicaciones de la consola en la medida de lo posible.

Si no tienes claro qué ajustes modificar, puedes usar este archivo user.js. Descomprímelo y cópialo en la raíz de tu carpeta de perfil, por ejemplo C:\users\usuario\appData\roaming\mozilla\firefox\profiles\i2p. Está basado en el archivo user.js de Arkenfox, con algunos cambios hechos al final y comentados en español. Los ajustes de proxy vienen configurados para usar Privoxy por el puerto 8118, que es justo lo que veremos a continuación.

Cómo usar Privoxy para conectar una aplicación a TOR e I2P a la vez

Imagina un escenario más práctico y menos anónimo donde queremos que un navegador seguro, o una aplicación de otro tipo, pueda navegar por Internet con normalidad sin enrutar tráfico por Tor o I2P, pero al mismo tiempo pueda acceder a sitios .i2p y servicios .onion. Aquí entra en juego Privoxy.

Privoxy es un proxy de exploración de la web sin caché, que incluye acciones y filtros para bloquear anuncios, mejorar la privacidad y editar contenido web al vuelo mientras navegamos. Para lograr el objetivo que nos hemos propuesto no editaremos filtros ni acciones, por lo que funcionará como un proxy casi neutral. Simplemente, nos apoyaremos en sus capacidades de redirigir tráfico según la URL buscada.

Para instalar Privoxy en Windows, se puede descargar la versión 4.1.0 como un archivo zip. Consulta la página principal de Privoxy para descargar una versión posterior, si la hay.

Ahora, descomprimimos el archivo zip en una carpeta cualquiera, por ejemplo la raíz de nuestro disco duro. De esa forma, todos los ficheros del programa quedarán en C:\privoxy_4.1.0.

El siguiente paso es editar el fichero de configuración config.txt que se encuentra en la carpeta de Privoxy. Si lo deseas, haz una copia del original por si quisieras usar Privoxy de otra manera en el futuro. El fichero debe vaciarse por completo, y quedar sólo con estas líneas:

forward . . forward-socks5t .onion 127.0.0.1:9050 . forward .i2p 127.0.0.1:4444

Teniendo la configuración lista, instalamos el servicio. Desde una consola con privilegios de administrador navegamos a la carpeta de Privoxy. Una vez allí, ejecutamos este comando: privoxy --install. Aparecerá una ventana con un mensaje de confirmación, ivitándonos a entrar en la consola services.msc para gestionar el servicio. Y es precisamente allí donde podremos iniciarlo, sin necesidad de retoques adicionales.

Para acabar, llega el turno de los clientes. Aunque no es el ideal, seguiremos poniendo como ejemplo el navegador. Si configuraste en la sección anterior un perfil de Firefox adicional, tan sólo deberás usarlo y reconfigurar el proxy en los ajustes de Firefox. Cambia el puerto 4444 por el 8118, ¡y a navegar! Podrás comprobar que accedes a cualquier web sin dificultad, y también a dominios .i2p y .onion.

Precauciones al navegar por la red oscura

Al navegar por Internet existen multitud de peligros, y la red oscura no es una excepción. A todos los ataques habituales debemos sumar uno más: la gente va a actuar de forma proactiva para averiguar quién eres: desde el dueño de un servicio oculto que quiera conocer a sus clientes, hasta los operadores de telefonía o las autoridades. De hecho, saber quién eres puede llegar a ser incluso más importante que saber qué haces. Aunque no te importe que se sepa tu identidad y hagas cosas dentro de la ley, conviene que tengas en cuenta lo siguiente:

  • Los scripts son un vector de ataque: me gusta decir que la web oscura es el reino de los elementos nativos. Una buena web en un servicio oculto debe tener Javascript como algo, si acaso, opcional si quiere dar un buen servicio a sus visitantes. Angular, React y cualquier otro framework están fuera de lugar aquí.
  • El tamaño de pantalla, las media queries de css, la carga de contenido multimedia en un formato específico, e incluso las cabeceras http pueden contener elementos dirigidos a identificarte. Algo tan simple como una hoja de estilos que diferencie entre enlaces visitados o no visitados puede lanzar una conexión con una URL concreta y decirle al dueño del servicio que ya has estado ahí.
  • Por tanto, además de Javascript, se recomienda desactivar también el historial y las cookies.
  • Si necesitas habilitar todo o parte de lo anterior, asegúrate de que el servicio es de confianza, y rebaja las protecciones sólo para ese servicio, por ejemplo añadiéndolo como excepción en las opciones del navegador.
  • Usa siempre un navegador suficientemente seguro, como TOR Browser. Evita navegadores basados en Chromium, como Brave. Aunque estén preparados para TOR y lo lleven incorporado, envían más telemetría y datos por ahí fuera de los que deben.
  • No utilices estas tecnologías en empresas o equipos de empresa. Los antivirus suelen reaccionar mal, el personal de seguridad también, y el de recursos humanos probablemente también.
  • Ten respeto, pero no miedo. No hay que bajar la guardia en estas redes, pero tampoco asustarse. Si realmente te asusta entrar en este terreno o no crees tener los conocimientos suficientes, lo mejor es que no toques.
  • Mantén todo el software actualizado. Es una obligación, no es opcional. Cada nueva versión de TOR o I2P mejora el cifrado, la gestión de la red, y puede corregir agujeros críticos de seguridad.

Al final no has respondido a la pregunta: ¿qué implica conectar Mastodon a la red oscura?

Para ti, como usuario, ningún cambio perceptible. Desde la configuración de perfil se pueden bloquear los dominios .onion y .i2p para no interactuar con ellos. Por otro lado, esta conexión abriría la posibilidad de seguir cuentas de instancias ocultas, conversar con ellas y conocer una parte de Internet a la que actualmente no tenemos acceso. Sin embargo, también entraña riesgos. Como hemos visto, crear dominios es una tarea muy sencilla, y si alguien decide enviar spam o acosar, detenerlo puede ser más complicado que en la red habitual. También puede que algunas conversaciones no aparezcan completas desde otras instancias no conectadas a la red oscura.

Referencias

2025-12-26

Cómo trabajar con la pantalla apagada usando Virtual Display Driver (Página de inicio on Un sitio solicitado por la comunidad, para la comunidad)

La pantalla del ordenador es ese periférico que siempre está mostrando algo. Nunca falla, no puede permitírselo. Si lo hace, es porque falla el sistema entero. Es la piedra angular de cualquier ordenador, cualquier sistema, cualquier aplicación. He visto portátiles en casi perfectas condiciones desechados sólo porque la pantalla estaba rota. Así que suena absurdo trabajar con ella apagada. Tan absurdo que los fabricantes, con el paso de los años, han ido acabando con cualquier mínima posibilidad que pudiera existir de desactivarla. Porque ¿quién querría hacer algo así? Pues sin ir más lejos, un usuario ciego que no la necesita, como yo.

Trabajar con la pantalla apagada tiene múltiples ventajas. La principal, sin duda alguna, es la privacidad. Nos suele gustar usar el PC sin que alguien se acerque discretamente y vea lo que estamos haciendo. Y por desgracia, pasa con más frecuencia de la que parece. No es la primera vez que la gente me pregunta por qué no se ve nada y si el ordenador está realmente encendido, y no será la última. Pero como la privacidad no lo es todo, también tenemos otro buen motivo para querer apagarla: la exposición prolongada a una luz que no vemos y que, a largo plazo, acaba afectando a nuestra salud.

Hasta el descubrimiento que presento en esta entrada, y que hice ayer mismo, sólo conocía estas tres formas de desactivar la pantalla, cada una con sus pros y sus contras. Hablamos de la pantalla de un portátil. Evidentemente, en equipos de sobremesa, la solución es tan simple como darle al interruptor o tirar del cable:

  • Bajar el brillo al 0%: reducir la luminosidad puede funcionar mejor o peor, dependiendo de la marca. La luz será menos dañina y el consumo de energía disminuirá, pero es posible que todavía se siga viendo el contenido con el que interactuamos.
  • Utilizar una segunda pantalla que no está conectada: la mayoría de portátiles con Windows vienen con un conector para usar una pantalla adicional. Podemos pulsar la combinación windows+p y elegir “Sólo segunda pantalla”. Si todo va bien, el sistema puede preguntar si queremos conservar o revertir los cambios, o efectuar el cambio de pantalla sin preguntar nada. El problema es que casi nunca va bien, ya que las tarjetas gráficas y los sistemas operativos más recientes son capaces de identificar si realmente hay una segunda pantalla conectada y, si no es así, el proceso no continúa. Otro punto en contra va relacionado con la resolución de la nueva pantalla, que tiene un impacto a la hora de navegar por el escritorio, la web, y otras aplicaciones. Como única gran ventaja, eso sí, tenemos que la pantalla principal se desactiva por completo, ahorrando energía. Si el equipo tiene conector VGA, o se usa un adaptador HDMI a VGA, este método funcionará siempre.
  • Cortinas de pantalla: ciertos lectores de pantalla, como Jaws for Windows, NVDA y VoiceOver, incluyen una función llamada cortina de pantalla. Al activarla no se apaga la pantalla, sino que sus píxeles emiten de manera uniforme el mismo contenido, de tal manera que no se ve nada. Esto no reduce el consumo de energía, pero es una solución eficaz para preservar nuestra privacidad. No obstante, no está exenta de problemas. Y es que la cortina se activa a nivel de software, por lo que la pantalla tampoco se verá al realizar tareas tales como aplicar OCR, compartir en videollamada el escritorio o tomar capturas de pantalla. Las capturas aparecerán vacías, y el OCR no encontrará texto.

La solución óptima siempre ha sido utilizar una tarjeta gráfica simulada a la que se conecten pantallas simuladas. El problema es que no existía, y cuando existió no la conocimos… hasta hace poco. El nombre no es muy original, pero tampoco importa: se trata de Virtual Display Driver.

Pasos para configurar Virtual Display Driver

En primer lugar, deberemos disponer de tres cosas importantes: el propio driver, una cuenta con privilegios de administrador, y un sistema Windows 10 o posterior X64 o ARM64. Para descargar el driver, se puede visitar la página de la última release en GitHub y descargar el archivo vdd.control en la lista que hay bajo el botón desplegable “Assets”. Por ejemplo, y para ahorrar tiempo, aquí está la descarga directa de la versión 25.7.23, la más reciente en el momento en que escribo esta entrada. Ahora que tenemos todo lo necesario, se pueden seguir estos pasos:

  1. Extraemos el archivo zip descargado a una carpeta en la raíz de la unidad del sistema. Por ejemplo, C:\virtualMonitor.
  2. Accedemos a la carpeta, y ejecutamos el archivo VDD Control.exe. Aparecerá una alerta de escritorio seguro.
  3. La interfaz no es muy accesible, pero tiene un cuadro de texto con información de depuración, y algo que por suerte podemos usar: una barra de menú.
  4. En la barra de menú, vamos a “Virtual Display Driver”, luego a “System”, y finalmente a “Install Driver”. Aparecerá una advertencia de Windows preguntando si queremos instalar el controlador, ya que el firmante no es de confianza. Pulsamos Instalar, y al hacerlo, escucharemos que un nuevo dispositivo se conecta. ¡Nuestra nueva pantalla virtual está lista! Se puede desinstalar el driver del mismo modo, eligiendo la opción “Uninstall driver”.
  5. Pulsa el botón con una x para salir de la aplicación.

Hora de apagar la pantalla

Una vez esté todo instalado, podemos pulsar windows+p. En la lista, observaremos que está seleccionada la opción “Duplicar”. Bajamos hasta “Solo segunda pantalla”, pulsamos intro, y la pantalla principal se apagará. Sin embargo, esta nueva pantalla comienza por defecto con una resolución de 800x600. Desde Configuración > Sistema > Pantalla, y tras seleccionar la pantalla 2, se puede modificar a un valor más adecuado, como 1920x1080, y conservar los cambios al acabar. Para encender la pantalla, es suficiente con pulsar Windows+p de nuevo, elegir en la lista “Solo pantalla de PC” y pulsar intro.

Posibles problemas

Si el driver o la aplicación de control no funcionan, puede deberse a la falta de librerías en el sistema. Tal y como mencionan sus autores en GitHub, se deben instalar las versiones más recientes de Microsoft .Net Runtime y Microsoft Visual C++ Redistributable. Por ahora, no explicaremos cómo hacerlo, pero en el futuro se podría ampliar esta sección.

Si has llegado hasta aquí siguiendo todos los pasos, ahora puedes apagar la pantalla de tu portátil de la mejor forma posible: físicamente, ahorrando energía, sin impacto en las aplicaciones, y con la garantía de que se mantiene tu privacidad en todo momento. Es hora de que las miradas, ya sean discretas o indiscretas, vayan al lugar que les corresponde: los portátiles de los demás.

¡A disfrutar!

2024-10-25

Cómo usar GeForce Experience con lectores de pantalla: una guía que jamás debió ser escrita (Página de inicio on Un sitio solicitado por la comunidad, para la comunidad)

Actualización: a partir de noviembre de 2024, GeForce Experience queda obsoleto en favor de la nueva aplicación de NVIDIA, que es más accesible con lectores de pantalla. No obstante, se mantiene el contenido por motivos históricos. Como se dijo en una entrada anterior, los controladores son una parte esencial de nuestro sistema que no debemos descuidar. Son los encargados de gestionar la relación entre el sistema operativo y los distintos componentes del equipo, y deben mantenerse actualizados siempre que sea posible. Esto lo sabe muy bien NVidia, que permite mantener al día los controladores de sus tarjetas gráficas mediante la aplicación GeForce Experience; una aplicación que antes era accesible, y ahora no. En este caso, no utilizo el término “accesible” como consultor de accesibilidad, sino como usuario. Si entramos a analizar el cumplimiento de las WCAG, incluso en su versión 2.0, estoy seguro de que aquello fallaría por todos lados. Así que en este caso empleo el término “accesible” como accesible para personas ciegas, una simplificación errónea pero conveniente para la historia que nos ocupa, y muy extendida en el colectivo. GeForce Experience es una aplicación con una interfaz hecha a base de HTML, CSS y JavaScript, que se ejecuta sobre un control de navegador web en una ventana independiente. A priori esto es fantástico, porque un usuario de lector de pantalla puede recorrerla con los modos foco y exploración y acceder a todos sus contenidos. En un momento dado, alguien en NVidia tuvo la maravillosa idea de añadir atributos aria-hidden a todos los componentes. Los posibles porqués pueden ser muchos. Tal vez fue una configuración errónea de una biblioteca de terceros. Tal vez querían proteger su interfaz de programas automatizados, que aprovechan las APIs de las tecnologías de asistencia. Sea como fuere, NVidia demostró que la accesibilidad no le preocupaba demasiado. Nadie allí dentro pensó que las personas ciegas también usan tarjetas gráficas.

Espera un momento, Jose, que yo tampoco había caído. ¿Para qué quiere un ciego una tarjeta gráfica?

Supongo que, si lo explico ahora, no tendré que explicarlo luego. Puede parecer que, como no vemos, no necesitamos tarjetas gráficas decentes, pero nada más lejos de la realidad. Hoy en día se usan para muchas otras cosas:

  • Ejecutar videojuegos accesibles que no van a rebajar sus requisitos gráficos.
  • Usar modelos de inteligencia artificial aprovechando la potencia de la tarjeta.
  • Minar criptomonedas.
  • Usar Jaws for Windows, un lector de pantalla que todavía depende de la tarjeta gráfica para obtener ciertos datos.
  • Ejecutar software que requiere una resolución de pantalla determinada.
  • Mejorar el rendimiento general del sistema.

Ahora que ya hemos abordado el problema y demás prejuicios, entremos en las soluciones que podemos aplicar para conseguir el objetivo: actualizar los controladores. Ya que la parte de iniciar sesión con una cuenta NVidia es accesible, nos olvidaremos de ella.

Primer método: de memoria y a ciegas

Tras abrir GeForce Experience, NVDA nos anunciará que estamos en un “documento”, como sucedería en cualquier página web. El único texto visible en ese documento es “common-crimsion-window”, que no nos dice absolutamente nada. Para actualizar los controladores, procedemos del siguiente modo:

  1. Activamos el modo foco. Es importante no pulsar tabulador antes de activarlo.
  2. Si recorremos la ventana con tabulador, veremos dos botones etiquetados como “main-tab-label” antes de un botón “notificationButton”. Pulsamos el segundo para ir a la pantalla de controladores. Importante, no confundir con los botones “mainTab”, que también existen.
  3. Si habíamos recibido la notificación de que había un controlador nuevo para instalar, es posible que la actualización ya esté descargada y preparada. Tabulamos hasta un botón llamado “express-driver-install” y lo activamos.
  4. Aparecerá un diálogo del control de cuentas de usuario. Al confirmarlo, la instalación continuará por sí sola.
  5. Mientras se instala, navegamos al escritorio y regresamos a GeForce Experience para que el foco pueda volver a navegar por la interfaz.
  6. Sabremos que la instalación se acerca a su fin porque el controlador gráfico se reinicia. En este momento, NVDA puede decir una o varias veces la palabra “horizontal”. Al acabar, aparecerá un diálogo modal, que logra atrapar el foco en su interior si llegamos hasta él.
  7. Llegados a este punto, puede que GeForce Experience nos pida reiniciar el equipo, o puede que no. Lo sabremos por la cantidad de botones en el diálogo de finalización:
    • Si sólo aparece un botón “updatesInstallerDialog-2”, podemos pulsarlo, cerrar GeForce Experience y dar el proceso por concluido hasta la próxima actualización.
    • Si aparecen los botones “updatesInstallerDialog-1” y “updatesInstallerDialog-2”, el segundo reiniciará el equipo, así que cuidado! Para salir sin reiniciar, se debe pulsar el primero.

Segundo método: destripar la aplicación para adaptarla a nuestras necesidades

Esto no siempre funciona, pero esta vez sí, así que aprovechemos! Al principio de la entrada dijimos que el responsable del problema es el atributo aria-hidden. Vamos a deshacernos de él. Para ello, necesitaremos acceso como administrador, y un editor de texto plano, como Notepad++, que pueda ejecutarse con privilegios elevados.

En primer lugar, abrimos el archivo C:\Program Files\NVIDIA Corporation\NVIDIA GeForce Experience\www\index.html. En él, buscamos la siguiente línea:

<div ui-view layout="column" flex aria-label="crimsion-window-space" aria-hidden="true"></div>

Cambiamos el atributo aria-hidden de true a false y guardamos. A continuación, editamos C:\Program Files\NVIDIA Corporation\NVIDIA GeForce Experience\www\app.js. En este caso, debemos usar la función de buscar y reemplazar con los siguientes textos:

  • aria-hidden=true se sustituye por aria-hidden=false
  • aria-hidden="true" se sustituye por aria-hidden=“false”`

Tras guardar los cambios, la mayor parte de la interfaz de GeForce Experience volverá a ser accesible con lectores de pantalla. O al menos, tan accesible como puede serlo una interfaz sin textos alternativos adecuados y con otras etiquetas bastante mejorables. Es posible que sigan haciendo falta algunas de las instrucciones de la sección anterior. Es importante tener en cuenta que esta adaptación no durará para siempre. Si GeForce Experience se actualiza, habrá que volver a repetirla. Por suerte, las actualizaciones de controlador llegan con más frecuencia que las de la aplicación, por lo que tendremos unos meses de respiro.

Tercer método: pasar completamente de la aplicación y las cuentas NVidia

Si conoces el modelo exacto de tu tarjeta gráfica y sabes que hay una actualización, puedes visitar esta página y hacerte con los controladores actualizados. El instalador se puede manejar bastante bien, y su interfaz no oculta controles por defecto.

Conclusión

En esta entrada hemos visto cómo parchear GeForce Experience o recurrir a métodos alternativos para actualizar los controladores de la tarjeta gráfica a ciegas. GeForce Experience resulta ser la alternativa más cómoda para actualizar, pero no es accesible con lectores de pantalla, lo que supone una barrera insalvable para la mayoría de usuarios. Se requieren conocimientos avanzados para llevar a cabo las prácticas explicadas en secciones anteriores, y nunca se deben utilizar documentos como este para justificar que un producto es accesible “porque los ciegos modifican los archivos, cambian un atributo aquí y otro allí y al final se las arreglan”.

He sentido mucha pena y vergüenza (de la ajena, que no de la propia) mientras escribía esto. Pena porque sé que hay usuarios que tendrían que leer este documento, no lo harán y continuarán atascados en un problema sin solución aparente. Vergüenza porque, en pleno 2024, con una norma UNE en Europa y varias directivas, y con la Section 508 en Estados Unidos, NVidia sigue sin tener en cuenta la accesibilidad y se deja potenciales clientes fuera. Espero que en el futuro la situación cambie, y a ser posible para mejor.

¡Gracias por leer!

2024-09-08

¿Conoces la URA de tu ayuntamiento? (Página de inicio on Un sitio solicitado por la comunidad, para la comunidad)

He decidido rescatar este hilo. Lo escribí en Twitter, un 4 de octubre de 2022, y tuvo bastante difusión (si lo comparamos con todo lo que escribía habitualmente). Dos años después, han cambiado muy pocas cosas. No obstante, he editado algunas publicaciones para reflejar esos cambios.

¿Conoces la URA de tu ayuntamiento? Yo tampoco. Posiblemente, no tenga. Pero espera, Jose, ¿qué es eso de una URA? URA significa unidad responsable de accesibilidad, y es obligatoria en todas las administraciones públicas. Venga, vamos a hablar de ellas.

En el año 2018 se aprobó el RD 1112/2018. Todos lo conocemos. Los sitios web de las administraciones públicas deben cumplir con el nivel AA de las WCAG 2.1, salvo excepciones. Las aplicaciones móviles, a partir del 23 de junio de 2021, también. Pero ¿qué administraciones?

La administración general del estado, las de las comunidades autónomas, las entidades locales, las entidades del sector público y las asociaciones constituidas por las mismas. Y todas deben tener una URA, según el artículo 16.

La URA atiende todas las quejas, reclamaciones y consultas relacionadas con la accesibilidad. También elabora informes periódicos, actividades de promoción y concienciación, y es el punto de contacto con el observatorio de accesibilidad web.

Todas las URAs deben enviar 3 informes anuales al observatorio desde el año 2020 (artículo 19). Y todas las administraciones públicas deben disponer de una declaración de accesibilidad. Desde el año 2018. Sin plazos, sin fechas límite, desde que entró en vigor el decreto.

Cuando se habla de accesibilidad, es raro no oír la frase de “Queda mucho por hacer”. Y claro que queda mucho, porque lo que hay que hacer se suele quedar sin hacer, así que siempre sigue ahí.

La teoría sobre el papel es preciosa, ahora vayamos a la práctica. Otra frase que se oye mucho es “la accesibilidad no interesa a nadie”. Y es casi verdad, al menos no tiene la prioridad que debería. Nuestros políticos, sin importar su color, no se la dan. Pero demostrémoslo con hechos.

Aquí hay un listado con todas las URAs actuales: https://administracionelectronica.gob.es/pae_Home/pae_Estrategias/pae_Accesibilidad/implantacion-rd-1112-2018/unidades-responsables-de-accesibilidad.html

A nivel general parece que la cosa va bien. Y a nivel autonómico. De las universidades tampoco nos podemos quejar.

En el excel aparecen 43 universidades (si sumamos la CRUE), y todas tienen URA. Me llama la atención que una de ellas la tenga en márqueting: https://administracionelectronica.gob.es/pae_Home/dam/jcr:7f6d8a92-ff4e-4327-b8bf-92fc8aa93960/2021227_Designaciones_URA_-_Universidad.xlsx

Pero bueno, es su obligación tenerla y la tienen. También es obligación de todos los municipios tenerla, y aquí el panorama cambia: https://administracionelectronica.gob.es/pae_Home/dam/jcr:8b847de9-4b58-4493-8deb-ea4f357985d5/20220921_Designaciones_URA_-_EELL.xlsx

Con fecha de 21 de septiembre de 2022 (el Excel no ha cambiado desde entonces), sólo 347 ayuntamientos tienen URA. Hay 20 grupos de municipios que la dejan en manos de su diputación, y 27 para otras entidades.

Pero según esta web, en 2019 había… 8131 municipios en total en España: https://es.statista.com/estadisticas/633516/numero-de-municipios-segun-numero-de-habitantes-espana/

¿Qué puede estar pasando? A lo mejor los pueblos pequeños no pueden permitírsela y hay bastantes, ¿no? Eso explicaría por qué Madrid capital no la tiene.

A lo mejor es algo que se lleva a nivel provincial. Eso explicaría por qué en Ciudad Real la tienen 2 o 3 pueblos de tamaño similar al mío y el resto no. Nótense las ironías.

El caso es que 6 años después de su implantación, y con alguna que otra bronca de por medio metiendo prisa, muchos sitios web de las AAPP siguen sin ser accesibles. Pero al menos tendrán declaración de accesibilidad, ¿no? Me fijo en los dos municipios donde resido habitualmente.

Me voy a Fuenlabrada y encuentro esta declaración. Algo obsoleta ya y haciendo referencia a una UNE de 2015, pero al menos se pusieron las pilas 2 meses después del hilo original en Twitter: https://www.ayto-fuenlabrada.es/web/portal/accesibilidad

Y me voy a Socuéllamos, y directamente no encuentro. ¿Para qué la iban a meter? ¿Qué es eso de accesibilidad? ¿Se come? https://socuellamos.es/

¿Y cómo es una URA en los sitios donde existe? Dice el decreto lo siguiente: “Las funciones que corresponda desarrollar a las Unidades responsables de accesibilidad serán asignadas a Unidades ya existentes”. Traducción: ni presupuesto extra, ni personal extra.

Resumen: cada uno tira como puede con lo que puede y cuando se acuerda. Y nadie hace nada para cambiarlo. Sabiendo esto, ¿cómo obligamos a las empresas privadas a que sean accesibles? ¿Con otra ley que quede bien de cara a Europa y no se aplique?

Ahora tenemos la Ley 11/2023. Sé de primera mano que, al menos, el sector bancario sí se la toma en serio. Pero está claro que no ocurrirá lo mismo con todas las empresas obligadas a cumplirla. Si me baso en los antecedentes, no queda otra que ser pesimista. De aquí a unos años nueva ley, nueva prórroga, y vuelta a empezar. Ojalá me equivoque.

2024-08-04

Cómo visualizar y crear archivos ZIM, una buena alternativa para almacenar sitios web fuera de línea (Página de inicio on Un sitio solicitado por la comunidad, para la comunidad)

Si buscas en cualquier buscador información para descargar sitios web completos, encontrarás montones de tutoriales que recomiendan toda clase de programas. Este es sólo uno más, que he querido escribir tras encontrarme por casualidad con el formato ZIM, el tipo de archivo que usa la Wikipedia para volcar todo su contenido y permitir su uso sin conexión. Pero espera, ¿quién querría descargar un sitio web entero y para qué? Tal vez, más personas de las que crees. Visitar un sitio web previamente descargado puede tener ventajas, como las siguientes:

  • La más obvia: se puede navegar por el sitio cuando no hay conexión. Por ejemplo, si hay caídas de la red o estamos en una zona con escasa cobertura.
  • La velocidad de carga no es un problema, incluso si la conexión es lenta.
  • Se llevan al máximo conceptos tales como la privacidad y el anonimato al navegar… al menos, para el propietario del sitio web en cuestión, que nunca sabrá que lo estamos visitando.
  • Si el sitio web se actualiza y pierde contenido, se conserva una copia con toda la información.
  • Se puede visitar el sitio web incluso cuando su propietario ha decidido eliminarlo.

En esta entrada haremos algo muy similar a lo que hace el gran archivo de Internet con su Wayback Machine, pero a mucha menor escala y en un formato de fichero distinto, por suerte para nuestros discos duros. Y como es habitual, lo haremos acompañados de un lector de pantalla, preferiblemente NVDA. ¡Empezamos!

Requisitos previos

Para seguir y comprender adecuadamente las distintas secciones de esta entrada, se recomienda lo siguiente:

  • Experiencia manejando la consola, ya sea cmd, bash o PowerShell. Muchas de las instrucciones dadas pueden aplicarse en casi cualquier plataforma.
  • La utilidad de línea de comandos wget (sólo si quieres crear tus propios archivos ZIM). Puede emplearse desde Windows con MSYS2 o WSL, o en Linux. Se encuentra como paquete en la mayoría de distribuciones, y también podría estar disponible para Windows de forma independiente.
  • Si utilizas lector de pantalla, se recomienda destreza con la navegación por objetos, uso del cursor de revisión, o mecanismos equivalentes.

Introducción al formato ZIM

El proyecto OpenZIM define el formato ZIM como “un formato de archivo perfectamente adecuado para guardar la Wikipedia en un pen drive USB”. Pero parece que no sólo se aplica a la Wikipedia, sino a cualquier contenido en la web que pueda almacenarse sin conexión. Un archivo ZIM contiene en su interior ficheros HTML codificados en UTF-8, enlazados adecuadamente entre sí y con todos los recursos asociados: hojas de estilo, imágenes, contenido multimedia, ficheros descargables y scripts. Una web alojada en uno de estos archivos debe ser autosuficiente, eliminando por completo o reduciendo al máximo la interactividad, los comportamientos dinámicos y la dependencia del exterior. Los archivos ZIM contienen metadatos sobre el nombre de la web, su creador, su idioma y una descripción del contenido, entre otros, y facilitan al software que los interpreta la posibilidad de realizar búsquedas de texto completo.

Cómo leer un archivo ZIM existente

Aunque es un formato poco común, la biblioteca de Kiwix contiene montones de archivos ZIM que se pueden visualizar y descargar. La Wikipedia, por su parte, vuelca periódicamente todos sus contenidos en esta dirección. Y efectivamente, en un pen drive de 128 GB cabrían las versiones en inglés y español juntas con todos sus recursos. Pero en este tutorial trabajaremos con algo más manejable: un pequeño archivo ZIM preparado para la ocasión. En la última sección aprenderemos a crearlo, pero ahora veamos cómo acceder a su contenido. Existen varios programas que pueden abrir archivos ZIM. Se pueden descargar en el catálogo de aplicaciones de Kiwix. En general son fáciles de usar, y cada uno tiene sus ventajas y desventajas.

Kiwix desktop

Kiwix Desktop es un cliente de escritorio compatible con Windows y Linux. Permite cargar archivos ZIM individuales y gestionar una biblioteca completa. En Windows, su proceso de instalación es tan sencillo como descargar la versión más reciente, descomprimirla en la carpeta donde queramos alojar el programa, y abrir el archivo ejecutable. En las distribuciones de Linux más populares, se puede instalar con pacman, dnf o apt. Y si eso no nos convence, también hay una versión para instalar con flatpack. La interfaz de Kiwix Desktop está basada en el framework QT5. Al manejarla con teclado, el tabulador no llega a todos los elementos disponibles, pero tiene algunos atajos que podemos usar. Por ejemplo, control+o para abrir un archivo. La mayoría de los controles están etiquetados, y con navegador de objetos se pueden alcanzar las zonas a las que el foco no llega por sí solo. A pesar de que se diseñó para ser intuitivo y amigable, la lectura de contenido con Kiwix Desktop dista mucho de ser cómoda con lectores de pantalla. Los documentos no se muestran en un búfer virtual que se pueda recorrer en modo exploración, y sólo se escucha parte del texto al tabular y pasar por encima de un enlace. Además, Kiwix Desktop no soporta scripts en los archivos ZIM. De todos los lectores, es sin duda el más restrictivo.

Kiwix JS y extensiones de navegador

Esta alternativa puede ser la más equilibrada en términos de accesibilidad y facilidad de uso. Kiwix JS es una aplicación que se entrega de múltiples formas. Elige la que más te guste, el resultado en todos los casos será muy similar:

En los casos donde el navegador esté involucrado, puede que ciertas características de seguridad limiten partes del contenido, lo que no impedirá leer la mayoría de los archivos. Kiwix JS se puede usar sin problema en modo exploración. Algunos de sus controles, dependiendo de la versión que elijas, pueden estar no etiquetados. Sin embargo, el botón para seleccionar un archivo ZIM está claramente identificado. La primera vez que carguemos un archivo, Kiwix indicará que no procede de un lugar seguro, y permitirá elegir si nos fiamos del contenido o si, por el contrario, compensa más abrirlo en modo restringido. Una vez se abra el archivo, el contenido aparecerá en un marco. La accesibilidad a la hora de leer y navegar, llegados a este punto, ya sólo dependerá del contenido.

Kiwix-tools

Esta es la alternativa más accesible, pero también la más avanzada, ya que implica usar la consola. La principal ventaja es que, una vez en marcha, podemos compartir la URL de acceso con otros usuarios de la red local, o de Internet en general si se configura adecuadamente. En este tutorial no se explica cómo asegurar las conexiones del exterior ni cómo crear un proxy inverso, aunque es el procedimiento recomendado. Nunca expongas el servidor Kiwix directamente en Internet. Las herramientas de consola de Kiwix (kiwix-tools) permiten realizar búsquedas, gestionar bibliotecas con varios archivos ZIM y levantar servidores accesibles desde otro equipo. En algunas distribuciones de Linux, como Debian, se encuentran en los repositorios oficiales (paquete kiwix-tools). Sin embargo, la versión ofrecida no suele ser la más reciente. Por lo tanto, a continuación se proporcionan los enlaces de descarga directa de la versión actual a fecha de redacción de esta entrada, la 3.7.0-2:

De nuevo, no hace falta instalación. Tan sólo basta con descomprimir las herramientas en la carpeta deseada y ejecutar desde consola las que queramos. Por ejemplo, podemos usar kiwix-serve para servir por red el archivo ZIM descargado anteriormente con un comando como este:

./kiwix-serve nvda-addons.zim

El contenido estará disponible en localhost por el puerto 80, o en la dirección ip del servidor, si es un equipo remoto. El servidor kiwix-serve dispone de algunos parámetros extra que se pueden pasar al ejecutarlo:

  • --library archivo.xml: sirve para cargar bibliotecas con varios archivos ZIM. Por ejemplo: kiwix-serve --library biblioteca.xml
  • -i dirección_ip: limita las direcciones ip en las que escucha el servidor. Por ejemplo: kiwix-serve -i 127.0.0.1 archivo.zim
  • -M: vigila los cambios de una biblioteca y reacciona actualizándose si la modificamos. Útil para añadir o eliminar archivos ZIM sin reiniciar el servidor. Por ejemplo: kiwix-serve -M --library biblioteca.xml
  • -p puerto: si el puerto 80 está en uso por otra aplicación, este argumento permite elegir uno distinto. Por ejemplo: kiwix-serve -p 8080 archivo.zim
  • -r prefijo: cambia el prefijo de URL. Útil si ejecutamos kiwix-serve tras un proxy inverso en un servidor con alojamiento compartido. Ejemplo: kiwix-serve -r /biblioteca/ archivo.zim. El contenido estaría disponible en http://localhost/biblioteca.

Por defecto, el servidor retendrá el control de la consola hasta que lo cerremos. Para ello, se puede pulsar control+c. En Linux, se puede cargar como servicio y dejarlo permanentemente en funcionamiento, algo que se sale del ámbito de este tutorial.

Gestión de bibliotecas con kiwix-manage

Imaginemos que hemos descargado la Wikipedia en español, la Wikipedia en inglés, el archivo ZIM de ejemplo de este tutorial y algunos más que nos resulten de interés. En vez de ejecutar un número indefinido de instancias de kiwix-serve para mostrarlos, podemos añadirlos a una biblioteca. Para ello, usaremos kiwix-manage:

kiwix-manage biblioteca.xml add archivo1.zim archivo2.zim archivo3.zim

Para agregar el archivo con la web de complementos de NVDA: kiwix-manage biblioteca.xml add nvda-addons.zim Ahora, podemos ejecutar el servidor con la biblioteca recién creada: kiwix-serve -M --library biblioteca.xml Para visualizar todos los archivos de la biblioteca, se puede usar un comando como este: kiwix-manage biblioteca.xml show Cada archivo, entre sus metadatos, tiene un identificador (id) formado por números y letras. Dicho identificador se puede usar para eliminar uno de los archivos: kiwix-manage biblioteca.xml remove identificador

Lectores para Android y dispositivos Apple

Si tienes iPhone, iPad o Mac, puedes descargar Kiwix en la AppStore. En Android, se puede descargar Kiwix en la Play Store, pero está limitada y no permite abrir archivos ajenos a la biblioteca de Kiwix. Si necesitas esto último, descarga el archivo APK directamente.

Cómo crear un archivo ZIM

En la sección anterior se proporcionó un archivo ZIM de ejemplo con la web de complementos de NVDA en español alojada por la comunidad internacional, así como herramientas para procesarlo y acceder a su contenido. Ahora, crearemos ese mismo archivo. Para ello es necesario un sistema con Linux y Wget instalado. A diferencia de la sección anterior, esta parte la haremos más guiada.

Descarga de zimwriterfs

Zimwriterfs es la herramienta que usaremos para crear archivos ZIM. Forma parte de las zim-tools, que no son tan comunes en los repositorios de las distribuciones como las kiwix-tools vistas antes. En primer lugar, descargamos la versión más reciente, actualmente la 3.4.2:

Asumiendo un sistema x86_64, descomprimimos el archivo descargado y navegamos a la carpeta extraída. Por ejemplo, en nuestra carpeta de usuario, se puede ejecutar este comando: tar -zxf zim-tools_linux-x86_64-3.4.2.tar.gz && cd zim-tools_linux-x86_64-3.4.2

Descarga del sitio web

El siguiente paso es hacernos con todos los ficheros de la web que queremos. En la medida de lo posible, estos ficheros deben ser autosuficientes, sin dependencias del exterior. Si una web utiliza PHP para devolver contenido con demasiado dinamismo, o Ajax, es una Single Page Application o se apoya en Angular/VUE/React, probablemente no se pueda descargar por completo usando wget. Por suerte, la web de complementos de NVDA es estática y cumple todos los requisitos para funcionar fuera de línea. Con este comando, se descargará en una carpeta nueva en la ubicación donde nos encontramos: wget -k -p -r -D addons.nvda-project.org https://addons.nvda-project.org/index.es.html

La descarga tardará unos minutos. Mientras tanto, veamos qué significa cada argumento del comando anterior:

  • -r: descargar de forma recursiva. Si no lo usamos, se descargaría sólo una página.
  • -p: descargar todos los requisitos necesarios para que la página funcione: imágenes, scripts, hojas de estilo, etc.
  • -k: cuando se complete la descarga, procesar los enlaces de todos los archivos para conectarlos entre sí.
  • -D addons.nvda-project.org: restringir las descargas al dominio addons.nvda-project.org. De lo contrario, ¡wget seguiría recursivamente todos los enlaces que encuentre y se descargaría medio Internet!

Preparación de otros recursos necesarios

Zimwriterfs necesita que se le pasen varios argumentos obligatorios para funcionar. Uno de ellos corresponde a una ilustración de 48x48 en formato png, que no tenemos. Por tanto, debemos diseñarla o buscarla. Para este tutorial, se ha elegido el icono de NVDA, se ha modificado su tamaño y se ha convertido en png. Hay muchos programas que facilitan esta tarea, como Irfanview. No profundizaremos en los pasos necesarios. Al finalizar la conversión, dejaremos el archivo nvda.png dentro de la carpeta addons.nvda-project.org que contiene la web descargada en el paso anterior.

Creación del archivo ZIM

Ya sólo faltan un par de comandos para completar la creación de nuestro archivo. Sin embargo, para prepararlos, debemos tener claros los metadatos. Esto es lo que zimwriterfs espera recibir obligatoriamente:

  • Un breve nombre interno.
  • El archivo html principal. En nuestro caso, index.es.html
  • La ruta a la ilustración del paso anterior.
  • Idioma: código de idioma en formato ISO639-3. Por ejemplo eng para inglés, fra para francés, o spa para español.
  • Título: un breve título de 30 caracteres o menos.
  • Descripción: una breve descripción del contenido.
  • El nombre del creador o creadores del contenido.
  • El nombre de la persona o entidad que publica el archivo ZIM.

Y estos metadatos se pueden añadir de manera opcional:

  • Descripción extendida del contenido.
  • Etiquetas, separadas por el signo punto y coma.
  • URL de origen del contenido.
  • Variante. Por ejemplo, Wikipedia tiene las variantes maxi y mini, entre otras. Si sólo queremos un archivo por sitio web, no es necesario indicar este parámetro.

Por supuesto, aquí opcional no hay nada. Vamos a crear un archivo con todos los metadatos. Primero, ejecutamos este comando para fijar una variable de entorno necesaria: export MAGIC=/usr/lib/file/magic.mgc Y ahora, llamamos a zimwriterfs: ./zimwriterfs --name="nvdaaddons" --welcome=index.es.html --illustration=nvda.png --language=spa --title="Complementos para NVDA" --description="Sitio web en español de complementos de la comunidad de NVDA" --creator="Equipo de complementos de NVDA" --publisher="José Manuel Delicado" --source="https://addons.nvda-project.org" --tags="NVDA;complementos;lector de pantalla;accesibilidad" --longDescription="Sitio web de complementos de la comunidad internacional de NVDA, sólo contenidos en español e inglés" --flavour=NVDA ./addons.nvda-project.org nvda-addons.zim Tras unos segundos, obtendremos un archivo ZIM muy similar al que se proporcionó al principio de este tutorial.

Conclusiones

Tras leer las secciones anteriores, deberías saber leer y crear tus propios archivos ZIM. Nos hemos dejado por el camino algunos conceptos, como la creación de un proxy inverso, la ejecución de kiwix-serve como servicio, y el resto de herramientas disponibles en las kiwix-tools y las zim-tools. ¿Te animas a explorarlas? Si la respuesta es sí, ¡asómate por Mastodon y comparte lo que has descubierto! ¡Hasta la próxima!

2024-06-03

De Docker al fediverso (Página de inicio on Un sitio solicitado por la comunidad, para la comunidad)

En este tutorial aprenderemos conceptos básicos de Docker. Después levantaremos una instancia de Mastodon, una red social descentralizada, y tomaremos medidas para que sea lo más segura posible. Dicha instancia estará formada por contenedores que operan de forma sincronizada, y que ofrecerán sus servicios al público mediante el servidor web Apache.

Requisitos

  • Un servidor con Debian 12 o Ubuntu. Se recomienda que esté protegido, sólo con los puertos ssh, http y https abiertos.
  • Acceso por SSH y conocimientos del manejo de la consola.

Introducción a Docker

Docker es una tecnología que nos permite desplegar aplicaciones y simular ciertas condiciones para que funcionen correctamente. Estas aplicaciones se ejecutan dentro de “contenedores”. Un contenedor se queda a medio camino entre el equipo anfitrión y una máquina virtual:

  • Engaña a la aplicación contenida.
  • Simula redes que en el equipo anfitrión no están.
  • Simula un sistema de archivos propio.
  • Le da a la aplicación las versiones de las librerías que necesita, que a lo mejor no se corresponden con las del equipo anfitrión. Eso ofrece más garantías de que siempre funcionará igual, esté donde esté.

Sin embargo, un contenedor no se ejecuta sobre un núcleo separado. Una aplicación preparada para tal fin puede escalar y acceder al equipo anfitrión sin nuestro permiso.

Los contenedores tienden a ser efímeros: cuando terminan de ejecutarse, lo normal es destruirlos. Se crean a partir de imágenes, que podemos construir por nuestra cuenta o descargar de algún registro. El registro por defecto, si no configuramos ninguno, es el Docker Hub, y allí es donde suelen subirse las imágenes con las que vamos a trabajar. De hecho, si nos hacemos una cuenta, podemos subir nuestras propias imágenes.

Instalación de Docker

Una vez instalado, los comandos para interactuar con Docker son los mismos en cualquier plataforma, también en Windows. Ya que en todos los tutoriales de este sitio hemos trabajado con Debian, vamos a usar Debian aquí también:

  1. Instalamos paquetes que nos permitirán agregar repositorios https: apt update && apt install apt-transport-https ca-certificates curl gnupg lsb-release
  2. Agregamos la clave GPG del repositorio de Docker: mkdir -m 0755 -p /etc/apt/keyrings && curl -fsSL https://download.docker.com/linux/debian/gpg | sudo gpg --dearmor -o /etc/apt/keyrings/docker.gpg
  3. Agregamos el repositorio: echo "deb [arch=$(dpkg --print-architecture) signed-by=/etc/apt/keyrings/docker.gpg] https://download.docker.com/linux/debian $(lsb_release -cs) stable" | tee /etc/apt/sources.list.d/docker.list > /dev/null
  4. Instalamos el motor de Docker: apt update && apt install docker-ce docker-ce-cli containerd.io docker-buildx-plugin docker-compose-plugin

Se puede cambiar la palabra debian por ubuntu en la URL de los repositorios si queremos hacer la instalación en ese sistema.

En la consola, hemos encadenado dos comandos para que se ejecuten seguidos. Esto se hace con el operador &&, que no habíamos visto hasta ahora.

Nuestro primer contenedor: Fedora

Comprar un servidor VPS sólo para probar una nueva distribución de Linux cuesta dinero, y virtualizarla puede ser imposible cuando no hay accesibilidad. Antes de lanzarnos a cambiar de distribución, puede ser una buena idea hacer algunas pruebas y ver si entendemos sus comandos.

En primer lugar, vamos a bajarnos la imagen más reciente de Fedora: docker pull fedora:latest

En Docker, es habitual que la etiqueta latest apunte a la versión estable más reciente de la imagen deseada. De hecho, la palabra latest se asume si no indicamos otra etiqueta.

Una vez descargada, podemos verla con el siguiente comando: docker images

La imagen, además de su nombre, lleva un identificador asociado. Gracias a él, podremos eliminarla cuando ya no la queramos: docker rmi identificador

Pero es un poco pronto para eliminarla, teniendo en cuenta que no la hemos usado. Creemos un contenedor:

docker run --rm -t -i fedora:latest /bin/bash

En este comando, hemos indicado que el contenedor será destruido al apagarse. Se acoplará una terminal para él, así como la entrada estándar de teclado, usará la imagen de Fedora con el tag latest, y dentro ejecutará el comando /bin/bash. El resultado es una consola dentro del contenedor. Podemos experimentar con ella, llamar a dnf update para actualizar los paquetes, y salir con control+d o el comando exit. Al abandonarla, el contenedor será destruido.

Si queremos hacer un contenedor que no se destruya, el comando varía ligeramente:

docker run --name micontenedor -t -i fedora:latest /bin/bash

En este caso, el contenedor guardará y recordará los cambios que hagamos en su interior. Al salir se detendrá, pero no se destruirá. Podremos volver a él con este comando:

docker start -i -a micontenedor

Si queremos eliminarlo: docker rm micontenedor

Es muy importante eliminar todos los contenedores creados a partir de una imagen antes de eliminar la imagen. Se puede hacer al revés con el modificador --force, pero puede tener efectos no deseados.

Segundo contenedor: un servidor de NVDA Remote

Tener la consola en pantalla es útil para experimentar, pero no es lo habitual. Lo ideal es que cada contenedor ofrezca sus servicios en segundo plano. Para ello, durante su creación, prescindiremos de los modificadores -t y -i.

El contenedor que vamos a crear ahora ofrece un servicio de red. Por defecto, Docker no abre los puertos del contenedor al exterior, sino que es algo que debemos pedirle nosotros. Para ello, usaremos el argumento -p, seguido del puerto exterior, y finalmente del interior. Sabemos que la imagen de NVDA Remote Server abre el puerto 6837. Sin embargo, desde la red del trabajo sólo nos dan libertad para acceder a los puertos 80 y 443, así que configuraremos el 443 como puerto de entrada. Con el argumento -d, además, le diremos al contenedor que se ejecute en segundo plano y nos devuelva el control de la consola en cuanto se inicie:

docker run -d -p 443:6837 --name micontenedor jmdaweb/nvda-remote-server:latest

Como se puede observar, esta imagen no estaba descargada, pero se descarga en cuanto la solicitamos.

Ahora, con el comando docker ps, podemos ver que el contenedor está activo. El comando docker logs micontenedor mostrará por pantalla la salida de la aplicación. Y si con start iniciábamos, docker stop micontenedor detendrá el contenedor indicado.

Con el contenedor activado, podremos conectarnos a un servidor de remote totalmente operativo en ipDelServidor:443.

Comunicación entre contenedores

Docker permite crear y gestionar redes. No profundizaremos demasiado en ello, ya que sólo necesitaremos unos conocimientos básicos.

El comando docker network --help nos dará más información. Cuando conectamos varios contenedores a una misma red, estos pueden interactuar entre sí sin que sus puertos estén abiertos al exterior. Por ejemplo, si tenemos una arquitectura en la que PHP se ejecuta con Wordpress en un contenedor, Apache en otro y MySQL en otro, nos interesará que todos se conecten entre sí, pero sólo Apache aceptará conexiones entrantes del exterior. Al crear un contenedor con docker create o docker run, se puede especificar su red con el argumento --network, seguido del nombre de la misma. Si escribimos --network host, el contenedor se comportará como cualquier aplicación del equipo anfitrión, ofreciendo sus puertos sin ninguna clase de traducción de red. Por tanto, el modificador -p dejaría de ser necesario.

Compartir archivos con volúmenes

Y si lo normal es destruir un contenedor al acabar de usarlo, ¿qué sucede con los datos que se generan en su interior? ¿De qué vale la base de datos que me he montado en MySQL? Cuando queremos preservar información, se emplean volúmenes. Dichos volúmenes pueden ser carpetas del sistema montadas en el contenedor, o almacenes gestionados por el propio Docker. Quizá la primera opción nos interese más, ya que así tendremos en todo momento los datos a mano. Hagamos un experimento sencillo con la imagen de Fedora que ya tenemos:

  1. Creamos una carpeta dentro de /root que actuará como volumen: mkdir /root/contenedores-pruebas
  2. Arrancamos un nuevo contenedor con Fedora: docker run --rm -v ./contenedores-pruebas:/root/contenedores-pruebas -t -i fedora:latest /bin/bash
  3. Desde la consola de Fedora, escribimos información en un fichero de texto dentro del volumen: echo hola > /root/contenedores-pruebas/prueba.txt
  4. Salimos de la consola, lo que provoca la destrucción del contenedor. Sin embargo, en la carpeta asociada al volumen, permanece el archivo txt con lo que escribimos.

¡Importante! Para que Docker monte volúmenes a partir de carpetas existentes, se debe indicar la ruta absoluta. De lo contrario, pensará que se trata de un volumen administrado, y fallará si el volumen no existe.

Ejecución de comandos dentro de un contenedor

Normalmente, cada contenedor ejecuta un único proceso, pero viene equipado de tal forma que podemos ejecutar más. Si queremos modificar el fichero de configuración del servidor de NVDA Remote, debemos usar Nano dentro del contenedor. De hecho, se ha incluido a propósito en la imagen original para poder hacerlo. Mientras el contenedor está activado, podemos llamar al comando docker exec, indicando el nombre y el comando que se ejecutará. Por ejemplo:

docker exec -t -i my_nvda_remote nano /etc/NVDARemoteServer.conf

Esto se aplicará más adelante en Mastodon para hacer copias de seguridad de la base de datos o gestionar aspectos de la instancia, por ejemplo.

Los ficheros docker-compose.yml

Cuando queremos desplegar un servicio que necesita usar varios contenedores, redes y volúmenes, poner en marcha cada elemento puede convertirse en una tarea repetitiva y no exenta de fallos. Docker-compose viene a solucionar el problema. Podemos crear un archivo docker-compose.yml con una serie de instrucciones en su interior que siguen un formato concreto en lenguaje Yaml, y esta herramienta se encargará de levantar o destruir el servicio a petición, creando y eliminando contenedores en el camino. Tiempo atrás, docker-compose se distribuía como un ejecutable independiente. Había que prestar atención para actualizarlo cada vez que salía una nueva versión. Ahora, viene en forma de plugin de Docker, y ya lo hemos instalado al principio de este capítulo. El gestor de paquetes de nuestra distribución ayudará a mantenerlo al día junto con todo lo demás.

Para utilizar un archivo docker-compose.yml, navegamos al directorio donde se encuentra. A continuación, podemos ejecutar algunos de estos comandos:

  • docker compose up -d: pone en marcha todos los servicios del archivo. Descarga imágenes si es necesario, y luego crea redes, volúmenes y contenedores.
  • docker compose down: apaga el servicio. Elimina redes, contenedores y volúmenes, pero no imágenes.
  • docker compose run --rm servicio comando: crea sólo un contenedor con el servicio indicado, cuyo nombre está en el archivo docker-compose.yml, y ejecuta en su interior el comando solicitado.
  • docker compose pull: actualiza todas las imágenes relacionadas con el servicio a sus versiones más recientes.

Archivo docker-compose.yml de ejemplo para Libre Translate

Libre Translate es un traductor gratuito, de código abierto y autoalojado. Con poco más de 20 GB libres, cualquier persona puede montarlo en su servidor con todos los modelos de idioma disponibles. A continuación hay un archivo docker-compose.yml que lo pone en marcha.

version: "3" services: libretranslate: container_name: libretranslate image: libretranslate/libretranslate:latest restart: unless-stopped command: --req-limit 30 --char-limit 5000 --api-keys --disable-files-translation --req-limit-storage redis://127.0.0.1:6379 --update-models environment: - LT_API_KEYS_DB_PATH=/app/db/api_keys.db volumes: - /root/libretranslate/api_keys:/app/db - /mnt/resource/libretranslate:/home/libretranslate network_mode: host

Instalación y configuración de la instancia de Mastodon

Obtención del código

En primer lugar, instalaremos Git en Debian: apt update && apt install git

Vamos a asumir que tenemos la sesión iniciada como root. Clonaremos el repositorio de Mastodon en nuestra carpeta de perfil de usuario, que se encuentra en /root:

git clone https://github.com/mastodon/mastodon.git

Ahora, accedemos a su interior: cd mastodon

Y usamos Git para situarnos en el tag de la versión más reciente. En el momento de redactar este tutorial, la versión más reciente es la 4.2.9: git checkout v4.2.9

Preparación de volúmenes

Mastodon no es una aplicación simple. Está formada por un conjunto de aplicaciones que se coordinan entre sí. En Docker, esto se traduce en varios contenedores, uno por aplicación. Vamos a verlos en detalle:

  • Web: ofrece la interfaz web y casi toda la API de Mastodon.
  • Streaming: es el encargado de ofrecer notificaciones y publicaciones en tiempo real, así como la API de streaming.
  • Sidekiq: ejecuta tareas en segundo plano. Es el corazón de esta red social, el nexo de unión entre todos los demás componentes. Si Sideqkiq falla o va lento, los usuarios lo notarán.
  • PostgreSQL: gestor de la base de datos principal. Almacena publicaciones, cuentas de usuario y algunos aspectos de la configuración de la instancia.
  • Redis: base de datos de rápido acceso cuyo objetivo es alojar una caché para que las líneas temporales carguen más deprisa, entre otras cosas.
  • Elasticsearch: componente opcional que añade capacidades de búsqueda a la instancia. Por supuesto, en este tutorial no es opcional. Ya que está, vamos a usarlo.
  • Tor y Privoxy: permiten que la instancia federe con otras instancias de la red Tor, y que los usuarios puedan visitarla de forma anónima. No lo documentaremos aquí. No es seguro ofrecer este tipo de acceso en una instancia de Mastodon.

Muchos de estos contenedores necesitan volúmenes. Como queremos que sus datos persistan entre reinicios y tenerlos a mano, vamos a crearlos como carpetas en el sistema anfitrión dentro del repositorio de Mastodon. Se podrían crear sin problema en cualquier otro sitio, siempre que luego ajustemos las rutas.

mkdir elasticsearch mkdir redis mkdir postgres16 mkdir system

Nota: la carpeta system contendrá elementos multimedia descargados de otras instancias y subidos por nuestros usuarios, por lo que se recomienda que esté en una partición con suficiente espacio libre.

Las carpetas están creadas, pero los contenedores intentarán escribir en ellas utilizando cuentas de usuario con menos privilegios que root por motivos de seguridad. Conociendo los identificadores de usuario y grupo, podemos asignarlos a cada carpeta:

chown -R 991:991 system chown -R 70:70 postgres16 chown -R 1000:0 elasticsearch chown -R 999:1000 redis

Preparación del núcleo para ElasticSearch

Ya tenemos los volúmenes listos. Antes de continuar poniendo en marcha la instancia, debemos modificar en el núcleo del sistema un parámetro que ElasticSearch necesita, y que por defecto tiene un valor muy bajo.

Para ello, podemos ejecutar el siguiente comando: echo vm.max_map_count=262144 > /etc/sysctl.d/elastic.conf

O crear el archivo /etc/sysctl.d/elastic.conf y escribir en su interior vm.max_map_count=262144, que al final se traduce en lo mismo. Después, mediante el comando reboot, reiniciamos el servidor.

El archivo docker-compose.yml de Mastodon

En el repositorio de Mastodon podemos encontrar un archivo docker-compose.yml en el que se definen varios contenedores y redes. Está preparado para compilar las imágenes desde el principio, algo que no nos interesa pudiendo descargarlas. También tiene muchas líneas comentadas, ya que el buscador ElasticSearch viene deshabilitado. Vamos a modificarlo para adaptarlo a nuestras necesidades. Este sería un posible fichero resultante:

version: '3' services: db: restart: always image: postgres:16-alpine shm_size: 256mb networks: - internal_network healthcheck: test: ['CMD', 'pg_isready', '-U', 'postgres'] volumes: - ./postgres14:/var/lib/postgresql/data environment: - 'POSTGRES_HOST_AUTH_METHOD=trust' redis: restart: always image: redis:7-alpine networks: - internal_network healthcheck: test: ['CMD', 'redis-cli', 'ping'] volumes: - ./redis:/data es: restart: always image: docker.elastic.co/elasticsearch/elasticsearch:7.17.4 environment: - "ES_JAVA_OPTS=-Xms512m -Xmx512m -Des.enforce.bootstrap.checks=true" - "xpack.license.self_generated.type=basic" - "xpack.security.enabled=false" - "xpack.watcher.enabled=false" - "xpack.graph.enabled=false" - "xpack.ml.enabled=false" - "bootstrap.memory_lock=true" - "cluster.name=es-mastodon" - "discovery.type=single-node" - "thread_pool.write.queue_size=1000" networks: - external_network - internal_network healthcheck: test: ["CMD-SHELL", "curl --silent --fail localhost:9200/_cluster/health || exit 1"] volumes: - ./elasticsearch:/usr/share/elasticsearch/data ulimits: memlock: soft: -1 hard: -1 nofile: soft: 65536 hard: 65536 ports: - '127.0.0.1:9200:9200' web: image: ghcr.io/mastodon/mastodon:v4.2.9 restart: always env_file: .env.production command: bash -c "rm -f /mastodon/tmp/pids/server.pid; bundle exec rails s -p 3000" networks: - external_network - internal_network healthcheck: # prettier-ignore test: ['CMD-SHELL', 'wget -q --spider --proxy=off localhost:3000/health || exit 1'] ports: - '127.0.0.1:3000:3000' depends_on: - db - redis - es volumes: - ./system:/mastodon/public/system streaming: image: ghcr.io/mastodon/mastodon:v4.2.9 restart: always env_file: .env.production command: node ./streaming networks: - external_network - internal_network healthcheck: # prettier-ignore test: ['CMD-SHELL', 'wget -q --spider --proxy=off localhost:4000/api/v1/streaming/health || exit 1'] ports: - '127.0.0.1:4000:4000' depends_on: - db - redis sidekiq: image: ghcr.io/mastodon/mastodon:v4.2.9 restart: always env_file: .env.production command: bundle exec sidekiq depends_on: - db - redis networks: - external_network - internal_network volumes: - ./system:/mastodon/public/system healthcheck: test: ['CMD-SHELL', "ps aux | grep '[s]idekiq\ 6' || false"] networks: external_network: internal_network: internal: true

Como vemos, se hace referencia a un archivo .env.production que no existe. Ya mencionamos que parte de la configuración de la instancia se almacena en la base de datos. Otra parte se almacena en este archivo.

El archivo .env.production

En la misma carpeta donde está el archivo docker-compose.yml (en este caso, la raíz del repositorio) debe haber un archivo llamado .env.production con las siguientes variables, como mínimo. La documentación de Mastodon proporciona otras variables que podemos añadir. Este es sólo un archivo de ejemplo:

# El contenido estático se deja en manos de Ruby y Docker RAILS_SERVE_STATIC_FILES=true # El nivel de registro se configura en advertencias RAILS_LOG_LEVEL=warn # Ajustes de Redis REDIS_HOST=redis REDIS_PORT=6379 # Ajustes de la base de datos DB_HOST=db DB_USER=postgres DB_NAME=postgres DB_PASS= DB_PORT=5432 # Buscador ES_ENABLED=true ES_HOST=es ES_PORT=9200 # Comienza a modificar a partir de aquí # Dominio de la instancia. LOCAL_DOMAIN=miinstancia.com # Valores secretos SECRET_KEY_BASE=secreto1 OTP_SECRET=secreto2 VAPID_PRIVATE_KEY=secreto3 VAPID_PUBLIC_KEY=secreto4 # Ajustes para enviar correos SMTP_SERVER=smtp.gmail.com SMTP_PORT=587 SMTP_LOGIN=miinstancia@gmail.com SMTP_PASSWORD=clave_de_gmail SMTP_FROM_ADDRESS=miinstancia@gmail.com SMTP_OPENSSL_VERIFY_MODE=peer SMTP_AUTH_METHOD=plain # Cambiar a true si la instancia sólo contendrá un usuario (instancia unipersonal) SINGLE_USER_MODE=false # Ajustes del traductor con DeepL # DEEPL_API_KEY=clave-api-de-DeepL # DEEPL_PLAN=free # Ajustes del traductor con Libre Translate #LIBRE_TRANSLATE_ENDPOINT=http://URL-del-traductor #LIBRE_TRANSLATE_API_KEY=clave-de-api-opcional

Como se puede observar, hay varios ajustes que debemos configurar:

  • Datos del servidor de correo: necesitamos una cuenta en un proveedor de correo. Gmail suele ser el más utilizado, especialmente con Google Workspace (de pago), por lo que decidimos dejar los ajustes del servidor. Esto no significa que no puedan usarse otros servidores, incluido un postfix local.
  • Nombre de dominio o subdominio: una vez que lo elijamos y pongamos en marcha la instancia, ya no podrá cambiarse, así que es una decisión que debe tomarse con calma.
  • Datos del traductor: el traductor es un componente opcional. Se pueden usar Libre Translate o DeepL. Descomenta las líneas del que prefieras, o no descomentes nada si no quieres traductor en tu instancia.
  • Valores secretos: los generaremos más adelante.
  • ¿La instancia es unipersonal? Si la respuesta es sí, esta variable debe estar a true.

Generación de los 4 valores secretos

Es hora de iniciar uno de los contenedores y responder una serie de preguntas. El siguiente comando ejecutará un asistente interactivo y realizará los primeros preparativos. Al finalizar, imprimirá por pantalla el resultado. Copia los 4 valores secretos, y sustitúyelos en el archivo .env.production del apartado anterior: docker compose run --rm web bundle exec rake mastodon:setup

Puesta en marcha y creación de la cuenta de administrador

La instancia está lista para arrancar. Y como ya vimos en una sección anterior, basta ejecutar un único comando para que todo se ponga en marcha: docker compose up -d

Cuando recuperamos el control de la consola, podemos ver el estado de los contenedores con docker ps. Tras un par de minutos, todos ellos deberían aparecer como ‘healthy’, que significa sano. Si alguno de ellos se reinicia continuamente o no se encuentra en buen estado, comprueba que no te has equivocado al seguir los pasos anteriores, y pregunta, no vaya a ser que yo me haya equivocado con el tutorial.

Los contenedores perdurarán y se activarán por sí solos cada vez que se reinicie el sistema. Para detener la instancia, ejecutaremos docker compose down

Ahora, desplegamos los índices del buscador, un paso indispensable para que funcione: docker exec mastodon-web-1 tootctl search deploy

Para finalizar la configuración, crearemos una cuenta de administrador. Tras ejecutar el siguiente comando, aparecerá en pantalla la contraseña de la cuenta, compuesta por 32 caracteres. Se puede cambiar más adelante desde la interfaz de administración:

docker exec mastodon-web-1 tootctl accounts create usuario --email usuario@miinstancia.com --confirmed --role owner

¡Todo listo! Mastodon ya está en funcionamiento. Pero aún no se puede entrar, falta mucho por hacer.

Obtención de un certificado para nuestro dominio

No puede haber instancia de Mastodon sin un dominio, o al menos un subdominio dentro del dominio. Vamos a asumir que ya tenemos un dominio que apunta a la dirección ip de nuestro servidor, y que los puertos 80 y 443 se encuentran abiertos. Esto último es importante, ya que son necesarios para obtener el certificado.

Con el certificado, garantizaremos que la conexión a la instancia se hace por https, y por tanto que el tráfico va cifrado entre cliente y servidor. Para comenzar, instalaremos Certbot:

apt update && apt install certbot

Antes de realizar la solicitud, tal vez sea conveniente reforzar la seguridad. Sabéis que a mí me gusta mucho dejar atrás RSA, aunque rompa compatibilidad con navegadores antiguos, y cambiarlo por algo más reciente. Para hacerlo, editaremos el archivo /etc/letsencrypt/cli.ini:

nano /etc/letsencrypt/cli.ini

No vamos a cambiar nada de lo que se encuentra en él, pero sí agregaremos lo siguiente:

key-type = ecdsa elliptic-curve = secp384r1

Ahora, pulsamos control+x para salir, la s o la y (según el idioma) para confirmar que queremos guardar, e intro para guardar el fichero sin cambiar su nombre.

Finalmente, solicitamos un certificado. En este ejemplo, se usa el dominio miinstancia.com: certbot certonly --standalone -d miinstancia.com

Si es la primera vez que usamos Let’s Encrypt, tendremos que aceptar los términos del servicio, y proporcionar un correo electrónico. Los certificados caducan cada 3 meses. Cuando falten pocos días para alcanzar la fecha de caducidad, recibiremos un correo que informará de ello. Para renovar todos los certificados solicitados, basta con apagar el servidor web, ejecutar certbot renew, y ponerlo en marcha de nuevo.

Ahora que ya tenemos un certificado, podemos continuar con el servidor web, Apache.

Instalación y configuración de Apache

Apache es un servidor web modular cuyo comportamiento se programa en uno o varios archivos de configuración. En cada distribución de Linux se presenta de una manera distinta. En Centos, todos los módulos vienen habilitados. En Debian y Ubuntu hay que habilitar a mano algunos para casos concretos, e incluso los hosts virtuales pueden encenderse o apagarse.

Para instalar Apache, ejecutaremos el siguiente comando:

apt update && apt install apache2

A continuación, habilitamos los módulos necesarios para usar SSL, redirigir a https y conectarse a los contenedores de Mastodon que funcionarán en el equipo: a2enmod ssl proxy_wstunnel rewrite headers

A pesar de que Apache nos lo solicite, aún no es momento de reiniciarlo. Debemos añadir y habilitar el fichero de configuración de la instancia. Por ejemplo, podemos situarlo en /etc/apache2/sites-available/miinstancia.conf. En su interior, se debe forzar el uso de https, y redirigir todas las solicitudes seguras hacia la instancia. Este podría ser un fichero de ejemplo:

<VirtualHost *:80> ServerName miinstancia.com:80 <IfModule mod_rewrite.c> RewriteEngine on RewriteRule ^ - [E=protossl] RewriteCond %{HTTPS} on RewriteRule ^ - [E=protossl:s] RewriteCond %{HTTP_HOST} ^www\.(.+)$ [NC] RewriteRule ^ http%{ENV:protossl}://%1%{REQUEST_URI} [L,R=301] </IfModule> </VirtualHost> <VirtualHost *:443> ServerAdmin correo@miinstancia.com ServerName miinstancia.com:443 SSLEngine on DocumentRoot /root/mastodon/public <LocationMatch "^/(assets|avatars|emoji|headers|packs|sounds|system)"> Header always set Cache-Control "public, max-age=31536000, immutable" Require all granted </LocationMatch> <Location "/"> Require all granted </Location> ProxyPreserveHost On RequestHeader set X-Forwarded-Proto "https" ProxyAddHeaders On ProxyPass /api/v1/streaming ws://localhost:4000/api/v1/streaming ProxyPass / http://localhost:3000/ ProxyPassReverse / http://localhost:3000/ ErrorDocument 500 /500.html ErrorDocument 501 /500.html ErrorDocument 502 /500.html ErrorDocument 503 /500.html ErrorDocument 504 /500.html CustomLog logs/ssl_request_log \ "%t %h %{SSL_PROTOCOL}x %{SSL_CIPHER}x \"%r\" %b" BrowserMatch "MSIE [2-5]" \ nokeepalive ssl-unclean-shutdown \ downgrade-1.0 force-response-1.0 SSLProxyEngine on <IfModule mod_headers.c> Header always set Strict-Transport-Security "max-age=63072000; includeSubDomains; preload" </IfModule> SSLHonorCipherOrder off SSLCipherSuite ECDHE-ECDSA-AES128-GCM-SHA256:ECDHE-RSA-AES128-GCM-SHA256:ECDHE-ECDSA-AES256-GCM-SHA384:ECDHE-RSA-AES256-GCM-SHA384:ECDHE-ECDSA-CHACHA20-POLY1305:ECDHE-RSA-CHACHA20-POLY1305:DHE-RSA-AES128-GCM-SHA256:DHE-RSA-AES256-GCM-SHA384 SSLProxyCipherSuite ECDHE-ECDSA-AES128-GCM-SHA256:ECDHE-RSA-AES128-GCM-SHA256:ECDHE-ECDSA-AES256-GCM-SHA384:ECDHE-RSA-AES256-GCM-SHA384:ECDHE-ECDSA-CHACHA20-POLY1305:ECDHE-RSA-CHACHA20-POLY1305:DHE-RSA-AES128-GCM-SHA256:DHE-RSA-AES256-GCM-SHA384 SSLCertificateFile /etc/letsencrypt/live/miinstancia.com/fullchain.pem SSLCertificateKeyFile /etc/letsencrypt/live/miinstancia.com/privkey.pem SSLProtocol all -SSLv3 -TLSv1 -TLSv1.1 SSLProxyProtocol all -SSLv3 -TLSv1 -TLSv1.1 SSLSessionTickets on SSLUseStapling on SSLStrictSNIVHostCheck on </VirtualHost>

Para completar la configuración de Apache, habilitamos el nuevo fichero y reiniciamos:

a2ensite miinstancia systemctl restart apache2

¡Servidor listo! Si intentamos entrar desde el exterior, observaremos que la conexión es segura, y podremos acceder a la instancia. La cuenta de administrador creada al principio permitirá personalizar un montón de aspectos desde la web. Pero eso es algo que dejamos para otro día. ¡Feliz federación!

Algo de protección extra: inclusión del dominio en la lista de precarga

Al conectar a una web que fuerza conexiones seguras, como la que acabamos de construir, la mayoría de los usuarios escribirán su nombre en la barra de direcciones, sin anteponer el prefijo https. El navegador primero accederá por http estándar, y acabará siendo redirigido. Si bien esto no supone un fallo muy serio de seguridad, le puede dar una pista a un potencial espía de la URL exacta a la que queremos ir. Para evitarlo, los navegadores incluyen listas de precarga con dominios conocidos. Cuando un dominio está en la lista de precarga, el navegador inicia directamente una conexión segura con él.

Si quieres que tu dominio esté en esa lista, sigue estos pasos:

  1. Accede a la web https://hstspreload.org
  2. En el primer cuadro de edición, que automáticamente recibe el foco, escribe el nombre de tu dominio. No se admiten subdominios.
  3. Si se superan todos los requisitos, marca la casilla de aceptación y envía el formulario.
  4. Sigue los pasos 1 y 2 para comprobar el estado de precarga del dominio cada pocos días. Tardará varias semanas en estar listo, pero no dejes que esto te impida usar tu instancia con normalidad y anunciarla. Como se menciona en el título de la sección, es un extra que no interfiere.

Esto es todo por ahora. ¡Gracias por leer! Espero ver nuevas instancias pronto!

Syncthing, mi programa favorito para compartir archivos en grupo (Página de inicio on Un sitio solicitado por la comunidad, para la comunidad)

Imagina que quieres compartir una carpeta enorme con otra persona. Dejas la carpeta en tu nube favorita, y esperas pacientemente a que se sincronice con el servidor, un proceso que va a tardar horas. La otra persona comenzará a descargarla en cuanto se haya terminado de subir. Seguramente tardará menos horas que tú, porque su velocidad de descarga es algo mayor, pero le llevará también mucho tiempo. Para colmo, te has quedado sin espacio en tu cuenta y uno de los archivos no cabe. ¿Y si la transferencia se hiciera por P2P, directamente al ordenador de la otra persona, y el único límite estuviera en el espacio del disco duro?

Empecé a usar Syncthing allá por el 2016, cuando se puso de moda la sincronización P2P con BitTorrent Sync. A mí no me gustaba porque era algo muy centralizado, había que pagar por funciones extra y ocurrían cosas que no recuerdo con la privacidad. Así que me fui por la alternativa más libre, como siempre. Y desde entonces no la he soltado, ¡será por algo!

Syncthing permite sincronizar carpetas entre dispositivos de una manera casi descentralizada. Las transferencias son de un ordenador a otro, cifrando los datos y aplicando SSL a la conexión con certificados y claves privadas en ambos extremos. Pero dejemos la parte técnica para más adelante, y empecemos por lo fácil.

Instalación

Por defecto, el ejecutable de Syncthing para Windows funciona desde consola, almacena todos sus datos en appdata\local y deja una ventana abierta permanentemente, y eso queda feo. Además, no arranca solo al iniciar sesión. Hay que complementarlo con algo, y ese algo se llama Sync Trayzor.

Sync Trayzor se encarga de arrancar Syncthing, vigilar su actividad y enviar notificaciones cuando tienen lugar una serie de eventos, como cambios en las carpetas locales o dispositivos que se conectan y se desconectan. Se minimiza a la bandeja del sistema, y no deja ventanas molestas en medio. Una vez instalado y configurado, nos podemos olvidar de él.

La versión más reciente, compatible con sistemas ARM y de 64 bits, está aquí. Incluye instaladores y portables, y requiere .net Framework para funcionar: https://github.com/germancoding/SyncTrayzor/releases/latest

Al instalarlo y ejecutarlo, abrirá una ventana con una barra de menú. Desde Archivo > Preferencias se puede configurar todo lo necesario. Las únicas cosas que yo suelo cambiar están en la primera pestaña. Me interesa que Sync Trayzor arranque con Windows, que se minimice y se cierre a la bandeja del sistema, que arranque minimizado y que no envíe notificaciones cuando se conecta o desconecta alguien (de verdad, pueden ser muy molestas).

En Mac no existe Sync Trayzor, hay que instalar Syncthing como una aplicación normal y corriente: https://github.com/syncthing/syncthing-macos/releases/latest

En Linux, para no variar, depende de la distribución. El equipo de Syncthing tiene un repositorio propio para Debian y derivados, y en Centos, Fedora y compañía Syncthing está como paquete en el repositorio EPEL. Una vez instalado, se puede activar del siguiente modo: systemctl enable syncthing@usuario systemctl start syncthing@usuario

Aunque es jugar con fuego y no lo recomiendo, no tiene por qué pasar nada si ese usuario es root, sólo manejamos nosotros el sistema y está bien asegurado.

En Android, Syncthing se puede descargar desde la Play Store.

Ahora que ya hemos instalado Syncthing y está en funcionamiento, podemos empezar a jugar con él. No hay que preocuparse por las actualizaciones, llegarán de forma totalmente transparente y sin que nos enteremos (Windows), o se instalarán de la forma habitual, como cualquier otro paquete o aplicación (Mac, Linux y Android).

Primeros pasos

Syncthing se maneja desde la web. Concretamente, desde esta dirección. Su interfaz es plenamente accesible y muy intuitiva. Necesita alguna mejora, como todo, pero son detalles insignificantes. Se puede dividir la ventana en las siguientes regiones:

  • Menú principal.
  • Notificaciones (si las hay).
  • Carpetas.
  • Este dispositivo.
  • Otros dispositivos.
  • Enlaces a webs externas.
  • Diálogos varios (siempre se irán abajo del todo). Sólo aparecerán cuando los abramos nosotros.

Cómo obtener nuestro ID de dispositivo

Por defecto, nuestro dispositivo tiene un identificador único. No va asociado a la máquina, sino a los datos empleados en la generación de nuestro certificado y clave. Por lo tanto, una copia de Syncthing podría migrarse con todos sus datos de un ordenador a otro mientras no se ejecute varias veces simultáneamente. El nombre legible del dispositivo se copia del nombre del equipo, pero podemos editarlo. Para ello, haz lo siguiente:

  • En el menú principal, pulsa Acciones.
  • Pulsa Ajustes.
  • En el primer cuadro de edición que encontrarás, cambia el nombre de tu dispositivo.
  • Pulsa Guardar.

Los cambios de nombre no se reflejarán en el resto de la red, salvo al vincular nuevos dispositivos. Para no causar confusión, se recomienda un nombre único, tan único y duradero como el identificador.

Para conectar con otras personas, tendremos que pasarles (siempre en privado) nuestro identificador, o pedirles el suyo. Para conocer tu identificador de dispositivo, haz lo siguiente:

  • Pulsa Acciones.
  • Pulsa Mostrar ID.
  • Aparecerá el identificador, junto con un código QR. Copia el texto del identificador y dáselo a la otra persona.
  • Pulsa Cerrar.

Conexión con otro dispositivo

Si recibes un identificador de otra persona, busca y activa el botón “Añadir un dispositivo”. En el formulario que se muestra, introduce el identificador en el primer campo. En el segundo, introduce el nombre que quieres darle, o déjalo vacío para tomar el nombre remoto elegido por la otra persona. Finalmente, pulsa Guardar. ¿Esperabas más? Hay más cosas que se pueden configurar de cada dispositivo, pero no las veremos todavía.

Por otro lado, si eres tú quien comparte su identificador, recibirás una notificación en la parte superior de la ventana cuando un dispositivo nuevo quiera conectar contigo. Confirma que quieres agregarlo, y se desplegará un diálogo idéntico al anterior. Los campos de identificador y nombre estarán rellenos, con todo listo para que pulses el botón Guardar.

Creación de nuestra primera carpeta compartida

Hemos conectado con éxito con el otro dispositivo. En este momento, aparece como conectado, pero sin uso. Al pulsar intro sobre su encabezado, se desplegará una tabla debajo con la información del dispositivo. Se pueden ver ciertos datos sensibles, como la dirección ip del dispositivo, su versión de Syncthing y su sistema operativo. Por este motivo, lo ideal es conectar sólo con gente de mucha confianza. Ten en cuenta que tus “contactos” también podrán saber cuándo te conectas y te desconectas, y crear un perfil con tus hábitos frente al ordenador.

Ahora, vamos a compartir una carpeta. Para ello, busca y activa el botón “Agregar carpeta”. Se desplegará un diálogo en la parte inferior.

De nuevo, vamos a rellenar dos campos:

  • Etiqueta de la carpeta: el nombre que se verá en los otros dispositivos.
  • Ruta de la carpeta: la ruta absoluta a la carpeta, tal y como aparece en la barra de direcciones del explorador de Windows. Por ejemplo, D:\Carpeta compartida.

Pero esta vez no pulsaremos el botón Guardar. Mientras agregabas dispositivos, seguramente viste una lista con varios enlaces antes del formulario. Es una lista con “pestañas” que muestran otras partes del diálogo. En el diálogo de agregar carpeta, esa lista también está presente. Pulsamos sobre un enlace llamado “Compartiendo”.

Desde aquí, podremos seleccionar el dispositivo o dispositivos con los que se compartirá la carpeta. Marcamos los que queramos y esta vez sí, podemos pulsar Guardar.

¡Todo listo! Ahora, la carpeta se comportará como cualquier carpeta en la nube. Cuando dejemos un archivo, le llegará a la otra persona, y cuando lo borremos, desaparecerá. El navegador puede estar cerrado mientras hacemos un uso cotidiano de Syncthing.

Podemos añadir más dispositivos a la carpeta, pero hay un problema: si nuestro ordenador se apaga, no podrán comunicarse entre sí. De hecho, cualquier dato que llegue a la carpeta deberá pasar por nuestro equipo antes de propagarse. Somos el centro de comunicación entre dispositivos, y de transferencia de datos. No parece muy práctico, así que vamos a solucionarlo.

Creación de un clúster radial

Si has llegado hasta aquí, has completado los primeros pasos con Syncthing, así que ¡enhorabuena! Vamos a desatar toda la potencia del P2P.

En los apartados anteriores hemos conectado dos dispositivos, que podríamos llamar A y B. Ahora, queremos agregar a la misma carpeta un dispositivo C. Repetimos todos los pasos anteriores y lo conectamos, pero sólo queda vinculado al dispositivo que lo enlazó, por ejemplo al dispositivo A. El dispositivo A puede comunicarse con B y con C, pero B no puede comunicarse con C directamente. Para que esto sea posible, el dispositivo A debe convertirse en un “presentador”. Nos lo podemos imaginar en el centro de un círculo, presentando al resto de dispositivos entre sí, y estando estos en el exterior de la circunferencia. Si quieres indicar que uno de tus dispositivos enlazados es un presentador, haz lo siguiente:

  • Busca el dispositivo que quieres modificar y despliégalo pulsando intro sobre su encabezado.
  • Busca y activa el botón “Editar”.
  • En el diálogo que se muestra, pulsa intro sobre el enlace “Compartiendo” para activar la pestaña correspondiente.
  • Busca la casilla “Presentador” y márcala.
  • Explora esta parte del diálogo. Observa que se muestran todas tus carpetas, y están marcadas las que compartes con ese dispositivo.
  • Pulsa Guardar.

A partir de ahora, cuando ese dispositivo agregue más dispositivos a la carpeta, aparecerán automáticamente en tu lista de dispositivos, y cuando los elimine desaparecerán. Esto trae múltiples ventajas:

  • Si el presentador apaga su dispositivo, el resto de dispositivos seguirán comunicándose y sincronizando datos entre ellos.
  • Las transferencias hacia un dispositivo se repartirán entre todos, consiguiendo que cada uno tenga que enviar menos información y consumir menos ancho de banda para completar la sincronización de la carpeta.

Creación de un clúster en malla

Esta es una práctica posible, pero no recomendada. Consiste en marcar todos los dispositivos como presentadores en ambos extremos. Es decir, tanto el que invita como el invitado indican que el otro es un presentador. De esa forma, cualquiera puede vincular dispositivos a una carpeta existente y propagar por toda la red la información del nuevo dispositivo. Cuando un dispositivo se da de baja de la red y alguien lo elimina, la información sobre el mismo vuelve a propagarse, por lo que es imposible hacerlo desaparecer y nuestra lista puede acabar llena de dispositivos fantasma. Si Syncthing detecta que la casilla de presentador se marca en ambos lados, emitirá un mensaje de advertencia.

Carpetas sólo enviar o sólo recibir

Por defecto, las carpetas que creamos son de tipo “Enviar y recibir”. Esto significa que cualquiera puede modificar su contenido y propagar los cambios por toda la red. Pero a veces, nos puede interesar otro enfoque donde un dispositivo envíe algo y todos los demás lo reciban. Por ejemplo, imaginemos que tenemos los archivos de una web en nuestro disco duro, y todo preparado para sincronizar una carpeta con el servidor web. El servidor puede generar archivos temporales que no nos interesa recibir, pero queremos modificar la web y que los cambios queden reflejados allí casi al instante.

Al igual que con los dispositivos, las carpetas deben modificarse desde ambos extremos. Uno o más dispositivos pueden elegir que la carpeta sea de tipo “Sólo enviar”, mientras otros que sea “sólo recibir”. Esto no afecta a la hora de sincronizar el contenido, que se propagará por toda la red según corresponda. Para cambiar el tipo de una carpeta, haz lo siguiente:

  • Pulsa intro en el encabezado de la carpeta para expandirla.
  • Busca y activa el botón Editar.
  • Activa el enlace “Avanzado” para desplegar la parte correspondiente del diálogo.
  • Modifica el tipo de carpeta en el cuadro combinado correspondiente.
  • Finalmente, pulsa Guardar.

Se pueden modificar los archivos en una carpeta de tipo sólo recibir, pero no se propagarán por la red. Syncthing detectará que hay contenido que no debería estar ahí, y ofrecerá desde la web la posibilidad de eliminar las diferencias. El resto de dispositivos también verán que la carpeta no está totalmente sincronizada.

Syncthing y la privacidad

Como ya se ha mencionado anteriormente, las transferencias en Syncthing son seguras y van cifradas de extremo a extremo. Se realizan por conexiones SSL, y cada dispositivo dispone de su propio certificado y clave privada, generados la primera vez que arranca el programa. No obstante, hay algunas consideraciones de privacidad que se deben tener en cuenta:

  • Cada dispositivo puede ver la dirección ip y el estado (conectado, desconectado, sincronizando) de todos los que tiene agregados. Usa Syncthing para compartir contenido sólo con personas de confianza.
  • Ciertos datos pasan por los servidores del proyecto. Enseguida hablaremos más de ellos.

Componentes de Syncthing

Si bien es cierto que las transferencias en Syncthing suelen ser de equipo a equipo, este programa sólo es totalmente descentralizado en redes de área local. Sin embargo, a diferencia de otras soluciones de la competencia, todos los actores involucrados en el funcionamiento de Syncthing se pueden replicar y modificar desde la configuración. Veamos cuáles son:

  • Servidor de descubrimiento global: es el servidor que Syncthing usa para descubrir otros dispositivos por su identificador y conectar con ellos.
  • Repetidor: aunque Syncthing soporta UPNP y gestiona de forma transparente la apertura de puertos, a veces se encuentra con algún router que no tiene activada esta tecnología o un firewall muy estricto. En esos casos, recurre a un repetidor para sincronizar las carpetas. Los repetidores suelen reducir notablemente la velocidad de transferencia.
  • Servidor de lista de repetidores: un servidor al que Syncthing acude para buscar los repetidores disponibles, por si tuviera que usarlos.
  • Servidor de actualizaciones: el lugar donde el programa busca nuevas versiones.
  • Servidor de recopilación de datos y estadísticas: el lugar donde Syncthing envía datos de carácter anónimo para mejorar el producto, si se lo consentimos. La primera vez que abramos la web nos pedirá consentimiento mediante una notificación. Este consentimiento se puede modificar desde las opciones.

Se recomienda no modificar ninguno de estos servidores, a menos que sepas lo que estás haciendo y quieras montar una red completa y privada.

Conclusiones

Existen muchas más cosas que se pueden cambiar en Syncthing. Se pueden limitar las velocidades de descarga y subida por dispositivo, configurar la interfaz web para que sea accesible desde el exterior, asignar un nombre de usuario y contraseña, cifrar carpetas sólo en algunos dispositivos, comprimir los datos antes de transferirlos, y mucho más. Sin embargo, son aspectos muy avanzados que no afectarán a la experiencia general de uso, y por lo tanto no hablaremos de ellos en este tutorial.

Muchas gracias por leer hasta aquí. Ahora, ¡a sincronizar carpetas!

Cómo actualizar nuestros drivers con Driver Pack Solution evitando un montón de problemas (Página de inicio on Un sitio solicitado por la comunidad, para la comunidad)

A pesar de ser el sistema de escritorio más usado, Windows siempre ha tenido un gran problema con la gestión de sus actualizaciones. Hoy en día, mediante Windows Update recibimos actualizaciones del sistema, como siempre. Gracias a Winget y la Microsoft Store, podemos mantener nuestras aplicaciones actualizadas de un modo muy similar. Pero ¿qué pasa con los drivers? Los drivers, o controladores, son una parte esencial de nuestro sistema que no debemos descuidar. Son los encargados de gestionar la relación entre el sistema y todos los componentes físicos del equipo y dispositivos periféricos. A veces, por Windows Update nos puede llegar alguna actualización de controladores. Otras, el fabricante de un componente incluye su propio software para actualizar su controlador. Pero en la mayoría de casos, tan pronto como se instala el controlador para un dispositivo y funciona, queda olvidado y ya no volvemos a saber de sus actualizaciones. Los fabricantes del equipo, interesados en que quede obsoleto tan pronto como sea posible para que te compres otro, ofrecen actualizaciones a cuentagotas y durante muy poco tiempo. Sin embargo, está demostrado que unos controladores actualizados solucionan problemas, alargan la vida del equipo, e incorporan mejoras que nunca imaginaríamos que vienen de ahí. Existen muchas herramientas que permiten descargar e instalar los controladores más recientes para nuestros dispositivos. En este tutorial hablaremos de Driver Pack Solution, una de ellas. Lo que la diferencia de otras es algo que a mí me gusta mucho: puedes descargar todos los packs de controladores y no depender de Internet para configurar casi cualquier ordenador.

Descarga

Para descargar la versión más reciente de Driver Pack Solution, acudiremos a esta página. Si no es la primera vez que lo descargamos, puede ser útil comprobar el número de versión. En el momento de escribir este tutorial, la versión actual es la 17.10.14-24060. A continuación, asumiendo que queremos todos los packs, podemos descargar este torrent con nuestro cliente torrent favorito. La descarga ocupa unos 42 GB. Se recomienda añadir como excepción al antivirus la carpeta donde descarguemos Driver Pack Solution, ya que puede decidir borrar algunos de los ejecutables incluidos.

Se puede prescindir del torrent descargando el ejecutable en línea y los packs que se muestran más abajo, pero no se recomienda. Entre otras cosas, porque la velocidad de descarga directa es tan baja que nos devuelve a aquellos felices años donde había módems de 56K.

Ejecución de DriverPack

Teniendo a mano un buen descompresor, como WinRar o 7-Zip, y el torrent descargado por completo, es momento de descomprimir ficheros. Concretamente, empezaremos por el único comprimido que hay en la raíz: DriverPack_17.10.14-24060.7z. Es muy importante elegir la opción “Extraer aquí” o similares, ya que los archivos extraídos servirán para completar la estructura de carpetas existente.

A continuación, pulsamos intro sobre el archivo DriverPack.exe. Nos pedirá privilegios de administrador, y comenzará a realizar una serie de comprobaciones del sistema que pueden tardar varios minutos. Si detecta una conexión activa a Internet y nos invita a usarla, pulsaremos Cancelar para quedarnos sólo con el contenido fuera de línea.

Después del arranque, la interfaz de DriverPack está lista para su uso. Con NVDA, se puede manejar como si de una página web se tratara, empleando los modos foco y exploración cuando sea necesario.

Actualización de controladores

He aquí la parte complicada. Driver Pack Solution viene muy bien como herramienta de diagnóstico, pero si la dejamos hacer decidirá por nosotros, y esas decisiones puede que no nos gusten. Concretamente:

  • Puede instalar software publicitario y otros programas que a lo mejor no son deseados.
  • Puede forzar la instalación de controladores que hagan que el equipo se vuelva inestable.

Así que parece mejor idea hacer las actualizaciones a mano. Para ello, activamos un enlace llamado “Modo experto”. Se mostrará una tabla con controladores que se pueden actualizar, y posiblemente otra con controladores que se pueden instalar. Debemos quedarnos con el contenido de esas tablas. Una vez copiado, podemos cerrar Driver Pack Solution.

A continuación, extraeremos las partes que nos interesen de cada pack a una carpeta común, por ejemplo C:\drivers. Cada pack tiene una estructura similar en su interior: nombre del fabricante y sistemas para los que se ha hecho el controlador.

Imaginemos que queremos actualizar una tarjeta de red Realtek en un Windows 10 u 11 de 64 bits. Abrimos el archivo DP_LAN_Realtek-NT_24060.7z, y extraemos el contenido de realtek\matchver\FORCED\10x64 a la carpeta común. Por si acaso, podemos incluir ntx64 y 88110x64. Debemos hacer esto con todos los packs. Si surgen dudas sobre qué extraer, siempre es mejor pasarse que quedarse corto, aunque sin extraer los packs enteros, que ocupan muchísimo descomprimidos. Por ejemplo, para actualizar una placa base Intel, es más sencillo extraer toda la carpeta intel del pack de chipset.

Concluida la extracción, le llega el turno al administrador de dispositivos de Windows. Podemos abrirlo pulsando windows+r y escribiendo devmgmt.msc, o desde el menú que aparece al pulsar windows+x. Una vez abierto, comienza un proceso algo repetitivo:

  1. Abrimos el menú contextual del controlador que necesita actualizaciones, y elegimos “Actualizar controlador”.
  2. Pulsamos el botón “Examinar mi PC en busca de controladores”.
  3. Elegimos la carpeta donde están extraídos todos los drivers. Por ejemplo, C:\drivers. Nos aseguramos de que la casilla “Incluir subcarpetas” esté marcada. Si no es la primera vez que hacemos esto, todos los valores ya vendrán configurados y sólo tendremos que pulsar en Siguiente.
  4. Esperamos a que el controlador se actualice. Si es necesario reiniciar el equipo, lo reiniciamos antes de continuar con el siguiente controlador.

Algunos consejos útiles

  • Windows sabe lo que es mejor para él. Si el administrador de dispositivos se niega a actualizar un controlador, y hemos comprobado que está extraído en la carpeta, no hay que forzarlo. De lo contrario, pueden producirse problemas. Es normal que Driver Pack sugiera controladores que no debe, y que la tabla de actualizaciones nunca se quede vacía.
  • En otras ocasiones, Windows puede indicar que no hay nada que actualizar, simplemente porque no hemos extraído el controlador adecuado del pack correcto. Las tarjetas de sonido Realtek son un buen ejemplo de controladores repartidos entre varios packs, más aún si incluimos los componentes software de sus efectos de sonido.
  • Hay controladores cuyo nombre cuesta identificar al buscar su correspondencia en la tabla. Generalmente, si llevan la palabra ’estándar’ o ‘genérico’ en el nombre, pueden necesitar una actualización. Por ejemplo, un “Controlador Sata AHCI estándar” puede sustituirse por un “Intel Sata Ahci Controller” del paquete Mass Storage.
  • A veces los fabricantes pueden tener razón y Windows no ser tan infalible. Si algún dispositivo falla tras actualizar, revierte al controlador anterior.

2024-06-02

Creación de redes seguras con OpenVPN (Página de inicio on Un sitio solicitado por la comunidad, para la comunidad)

OpenVPN es un software que nos permite construir redes vpn seguras, aprovechando los estándares de cifrado TLS y los diversos algoritmos ofrecidos por OpenSSL y bibliotecas similares. En este tutorial veremos cómo configurar un servidor, y añadir algunos clientes. Además, a diferencia de otros tutoriales disponibles en la red, intentaremos mejorar la seguridad y nos centraremos en construir una subred a la que varios equipos puedan conectarse para interactuar entre sí.

1. Requisitos

  • Un servidor con Debian instalado y acceso como root. Asumiremos que estamos usando Debian 13.
  • Conocimientos suficientes para entender lo que aparece escrito por consola, ejecutar comandos básicos y editar ficheros.
  • Leves nociones sobre arquitectura de redes: direcciones ip, máscara de subred, etc.
  • Saber cuál es la dirección ip pública del servidor o, si la tiene, su ip dentro de la red local. En este tutorial asumimos que la ip del servidor es 192.168.1.2. Puedes conocer tu dirección ip con la utilidad ip.
  • Saber cuál es el nombre del adaptador de red que tiene acceso a Internet. Puede ser eth0, o tener un nombre más complejo si el servidor es físico. Asumimos enp5s0f0. Puedes conocer los nombres de tus adaptadores con la utilidad ip.

2. Instalación de OpenVPN en el servidor

Para instalar la versión estable más reciente, se recomienda acudir a los repositorios de OpenVPN, en vez de descargar el paquete ofrecido por nuestra distribución. Ejecutaremos los siguientes comandos en orden:

  • Agregamos la clave gpg de los repositorios: curl -fsSL https://swupdate.openvpn.net/repos/openvpn-repo-pkg-key.pub | gpg --dearmor > /etc/apt/trusted.gpg.d/openvpn-repo-pkg-keyring.gpg
  • Agregamos las URLs de los repositorios al sistema: echo "deb [arch=amd64 signed-by=/etc/apt/trusted.gpg.d/openvpn-repo-public.gpg] http://build.openvpn.net/debian/openvpn/stable trixie main" > /etc/apt/sources.list.d/openvpn-aptrepo.list
  • Refrescamos el índice de paquetes: apt update
  • Y finalmente, instalamos los paquetes que nos interesan: apt install openvpn openvpn-dco-dkms
  • Instalamos los paquetes del cortafuegos, que más adelante vendrán bien para redirigir el tráfico de red y conservar los cambios entre reinicios: apt install iptables iptables-persistent

3. Configuración de OpenVPN como servidor

OpenVPN es un software que se ha diseñado para ejecutarse tantas veces como sea necesario. Podemos tener uno o varios clientes conectados a una o varias redes de terceros, y uno o varios servidores ofreciendo redes de distintos tipos a nuestros clientes. En este tutorial, sólo montaremos un servidor dentro del sistema Debian. Más adelante, haremos una ampliación para que haya dos servidores. El resto de clientes irán en equipos independientes.

3.1. Creación de una autoridad de certificación propia

Para cifrar el tráfico entre todos los componentes de la red y verificar la autenticidad de la misma, trabajaremos con certificados de cliente y servidor. Dichos certificados irán firmados por una autoridad de certificación propia. Podríamos recurrir a una de terceros, pero no nos va a dar tanta flexibilidad, y el resultado va a ser el mismo. OpenVPN viene con easy-rsa, un conjunto de scripts que facilitan la creación y gestión de autoridades y certificados. Usaremos easy-rsa para generar la autoridad, un certificado para el servidor, y tantos certificados extra como clientes vayan a conectarse. En este caso, se entiende por cliente el dispositivo, no la persona. Ya entraremos más adelante en el terreno de la autentificación con usuario y contraseña. Nuestra autoridad de certificación se aloja dentro de una carpeta, por ejemplo /etc/openvpn/certs. La generaremos con el siguiente comando: make-cadir /etc/openvpn/certs Los scripts de easy-rsa se copiarán dentro de la carpeta recién creada. Por defecto, generarán certificados y claves RSA. Si bien es cierto que a día de hoy son suficientemente seguros, nos interesa cambiarlos por ecdsa por diversas razones: en el futuro escalarán mejor, y requieren menos potencia de procesamiento para ofrecer un cifrado igual de fuerte. Por lo tanto, vamos a editar el archivo /etc/openvpn/certs/vars y añadir lo siguiente al final (o seguir los consejos del propio archivo y quitar los comentarios en las líneas apropiadas):

set_var EASYRSA_ALGO ec set_var EASYRSA_CURVE secp384r1 set_var EASYRSA_DIGEST "sha512"

De paso, hemos aprovechado para indicar que se use sha512 en vez de sha256 al calcular la suma de verificación de los certificados. Ahora, navegamos al directorio en cuestión, si no lo habíamos hecho ya: cd /etc/openvpn/certs El siguiente paso consiste en inicializar la infraestructura de clave pública, utilizando nuestro fichero de variables previamente editado: ./easyrsa --vars=/etc/openvpn/certs/vars init-pki Generamos nuestra autoridad de certificados raíz: ./easyrsa --vars=/etc/openvpn/certs/vars build-ca nopass La opción nopass hará que la clave privada no se cifre con una contraseña, lo que aporta cierta comodidad al generar certificados más adelante. Si queremos cifrarla e introducir la contraseña cada vez que usemos la autoridad, basta con quitar la opción. Para completar la generación de la autoridad, rellenamos los datos solicitados por el asistente interactivo. Generamos el fichero de parámetros de cifrado, siempre indicando qué variables usar: ./easyrsa --vars=/etc/openvpn/certs/vars gen-dh Ya tenemos nuestra autoridad lista para generar certificados de servidor y clientes. El certificado de la autoridad, necesario más adelante, está en el archivo ca.crt dentro de la carpeta pki.

3.2. Generación de un certificado de servidor

El certificado de la autoridad de certificación sólo se usará para firmar otros certificados, pero no cifrará las conexiones entre los clientes y el servidor. Aprovechando nuestra autoridad, vamos a generar uno específico. En esta ocasión, no es recomendable cifrar la clave privada con contraseña: ./easyrsa --vars=/etc/openvpn/certs/vars build-server-full midominio.com nopass Si aparece un asistente interactivo, lo rellenamos con la información solicitada. Todos los certificados se almacenan en la subcarpeta issued dentro de la carpeta pki, y todas las claves privadas en la subcarpeta private.

3.3. Listas de revocación y clave extra de cifrado

A veces, el certificado de un cliente puede verse comprometido, por lo que puede hacerse necesario revocar su validez. Nuestra infraestructura de clave pública debe mantener una lista actualizada con aquellos certificados que se han revocado. Debemos ejecutar el siguiente comando después de generar, renovar y revocar cualquier certificado, ya sea de servidor o de cliente. Incluso si no hay revocaciones, deberemos ejecutarlo cada 6 meses: ./easyrsa --vars=/etc/openvpn/certs/vars gen-crl Ahora, vamos a hacer algo que le va a dar más cifrado al cifrado. Si bien es cierto que un atacante que interceptara nuestras comunicaciones lo tendría ya muy complicado para saber lo que hacemos, puede deducir que nuestro tráfico va cifrado mediante TLS. Con la clave que generaremos a continuación, ofuscaremos el tráfico TLS para que no parezca tráfico TLS: openvpn --genkey tls-crypt-v2-server tls-server-key.key Con todo esto, estamos preparados para elaborar un fichero de configuración de OpenVPN.

3.4. El fichero de configuración de OpenVPN

Como hemos mencionado anteriormente, OpenVPN puede ejecutar tantas instancias de cliente y servidor como sea necesario. Cada instancia usa su propio fichero de configuración. Para facilitar la diferenciación entre clientes y servidores, los ficheros de cliente se almacenan en /etc/openvpn/client, y los ficheros de servidor en /etc/openvpn/server. Los ficheros que se usan para configurar OpenVPN en modo conexión punto a punto pueden ir fuera de estas carpetas. Sin embargo, todos deben tener la extensión .conf. A continuación, vamos a crear un fichero en /etc/openvpn/server. Lo llamaremos servidor.conf. Encima de cada línea, hay comentarios explicando su propósito.

# Indicamos cuál es la ip del servidor, ya sea pública o dentro de una red de área local, # seguida del puerto en el que escucha el servidor. Debe estar abierto en el router o firewall de la NAT, si lo hay, así como en el firewall del sistema, # y finalmente el protocolo de conexión. Se pueden usar TCP o UDP. Parecería que TCP es más estable, pero UDP ya tiene mecanismos equivalentes para evitar errores. Por tanto, TCP es más lento y sólo debería emplearse cuando no se pueda recurrir a UDP. local 192.168.1.2 1194 udp # Podemos escuchar en todas las direcciones comentando la línea anterior y usando esta otra #local * 1194 udp # Además, se puede acompañar de otra para tcp #local * 1194 tcp-server # Dispositivo que se utilizará. El más sencillo es tun. Por su parte, tap proporciona una integración con la lan a más bajo nivel, pero su configuración es mucho más compleja dev tun # Parámetros del servidor: formato de la subred y máscara de subred. Los clientes que se conecten recibirán una ip en este rango. Cuidado, la subred de la VPN no debe coincidir con la subred del servidor. De lo contrario, podemos perder el contacto con la máquina. server 10.0.0.0 255.255.255.0 # Parámetros del servidor, pero con una subred IPV6 server-ipv6 fe80::/64 # El túnel permanece abierto aunque se reciban ciertas señales del sistema persist-tun # cantidad de información que se almacena en el registro verb 3 # Ruta al archivo de registro de esta instancia log /var/log/openvpn/openvpn.log # Reforzamos el algoritmo de autentificación auth SHA512 # Si la instancia se desconecta, notifica a las partes conectadas para que actúen en consecuencia. Muy eficiente en UDP explicit-exit-notify 1 # Cuando se complete la autentificación, se guardará un token en memoria para no tener que repetirla tras una caída auth-gen-token # Los clientes conectados podrán verse unos a otros. Útil, por ejemplo, para jugar a juegos en línea client-to-client # Las direcciones ip de los clientes se almacenarán en este fichero para no recibir una nueva dirección en cada conexión ifconfig-pool-persist /var/log/openvpn/ip.txt # Cantidad máxima de clientes que se conectarán a la red. No debería haber más de 250 max-clients 100 # Ruta al certificado de la autoridad que generamos al principio ca /etc/openvpn/certs/pki/ca.crt # Ruta al certificado del servidor cert /etc/openvpn/certs/pki/issued/midominio.com.crt # Ruta a la clave privada del servidor key /etc/openvpn/certs/pki/private/midominio.com.key # Ruta al fichero de lista de revocación de la autoridad crl-verify /etc/openvpn/certs/pki/crl.pem # Ruta a los parámetros dh generados dh /etc/openvpn/certs/pki/dh.pem # Los certificados remotos enviados por los clientes que se conecten deben ser de tipo cliente remote-cert-tls client # Reforzamos los algoritmos de cifrado de la conexión. Sólo se admitirán los más recomendados, descartando los que se consideran más débiles tls-cert-profile preferred # Ruta a la clave de ofuscación del tráfico tls-crypt-v2 /etc/openvpn/certs/tls-server-key.key # Indicamos explícitamente que actuaremos como servidor TLS tls-server # La versión mínima del protocolo TLS será la 1.2 tls-version-min 1.2 # Tiempo que permanecerán abiertas las conexiones keepalive 10 120 # Forzamos explícitamente que esta instancia actúe como servidor mode server # Indicamos que su topología es de subred topology subnet # Transmitimos a los clientes directivas de configuración. Todo el tráfico irá dirigido por la VPN push "redirect-gateway" # Nuestro router, que incluye un servidor DNS, actuará como DNS push "dns server 0 address 192.168.1.1" # Algoritmos de cifrado de transmisión de datos data-ciphers AES-256-GCM:AES-128-GCM:CHACHA20-POLY1305 # Además de la autentificación de cliente con certificado, también se debe introducir un usuario y una contraseña plugin /usr/lib/openvpn/openvpn-plugin-auth-pam.so "login login USERNAME password PASSWORD"

3.5. Cambios de configuración en el kernel y retoques finales

Ahora que ya tenemos un fichero de configuración completo, estamos listos para iniciar el servidor VPN. Podemos hacerlo con este comando: systemctl start openvpn-server@servidor Lo que va después del símbolo arroba es, como se puede deducir, el nombre del fichero de configuración, sin la extensión .conf. Con este otro comando, configuraremos el servidor para que arranque al iniciar el sistema: systemctl enable openvpn-server@servidor Pero ahora nos enfrentamos a un problema: esta red va a dejar a los clientes sin acceso a Internet. Podrán verse unos a otros e interactuar entre sí, pero no podrán usar el servidor para comunicarse con el exterior. Para resolverlo, crearemos un fichero .conf nuevo en /etc/sysctl.d con el nombre que queramos, por ejemplo openvpn.conf:

echo net.ipv4.ip_forward=1 >> /etc/sysctl.d/openvpn.conf

Podemos reiniciar el servidor para que los cambios surtan efecto. Esto, sin embargo, no es suficiente. Hay que indicar a iptables que el tráfico recibido de la red interna se dirija a la red externa. Si prefieres usar UFW, puedes hacerlo. El comando con iptables sería el siguiente:

# Recuerda ajustar tu subred y tu adaptador con los valores que correspondan iptables -t nat -A POSTROUTING -s 10.0.0.0/8 -o enp5s0f0 -j MASQUERADE

Perfecto, nuestros clientes ya podrán acceder a Internet usando la VPN, pero sólo hasta que el servidor se reinicie! Después, habrá que ejecutar el comando iptables otra vez. UFW se encarga de guardar la configuración para evitar esta situación. Sin UFW, se puede usar un comando como este para guardar las reglas actuales en disco y configurarlas para que carguen al arrancar: netfilter-persistent save

4. Configuración de los clientes

¿De qué serviría un servidor si los clientes no pueden conectarse a él? Es exactamente lo que sucede con la instancia de OpenVPN que acabamos de poner en marcha. En esta sección, vamos a preparar dos clientes para una misma persona. Uno de ellos será un ordenador con Windows, y otro un iPhone.

4.1. Generación de los certificados de cliente

Supongamos que el propietario de los dos dispositivos se llama Pedro. Vamos a generar dos certificados, dos claves privadas, y dos claves de ofuscación de tipo cliente para él. En la consola, debemos navegar al directorio /etc/openvpn/certs, si es que nos habíamos salido de él. Una vez allí, ejecutamos los siguientes comandos: ./easyrsa --vars=/etc/openvpn/certs/vars build-client-full pedro-windows nopass ./easyrsa --vars=/etc/openvpn/certs/vars build-client-full pedro-iphone nopass Si aparecen asistentes interactivos solicitando información, debemos rellenarla. La opción nopass indica que las claves privadas no deben ir cifradas con contraseña. Importante refrescar la lista de revocación en cuanto hayamos terminado esta parte. Para generar las claves de ofuscación de los clientes, necesitaremos hacer referencia a la clave de ofuscación del servidor. Los comandos quedarían de una forma similar a esta: openvpn --tls-crypt-v2 /etc/openvpn/certs/tls-server-key.key --genkey tls-crypt-v2-client tls-client-pedro-windows.key openvpn --tls-crypt-v2 /etc/openvpn/certs/tls-server-key.key --genkey tls-crypt-v2-client tls-client-pedro-iphone.key

4.2. Generación de una cuenta para el cliente

Además de un certificado único, una clave privada única y una clave de ofuscación única, podemos reforzar la seguridad obligando a los clientes a que introduzcan un nombre de usuario y una contraseña. Esto, normalmente, se consigue mediante plugins. OpenVPN viene con un plugin que nos permite usar las cuentas del sistema, y que ya agregamos mientras preparábamos el servidor. Existen algunos plugins más, pero suelen ser de pago y quedan fuera de este tutorial. Agreguemos una cuenta de usuario para Pedro: useradd pedro Y ahora, démosle una contraseña: passwd pedro Ya está todo preparado para que Pedro se conecte, salvo una cosa: Pedro necesita dos archivos de configuración que no tiene.

4.3. Generación de los archivos de configuración

A pesar de que OpenVPN se puede configurar con un archivo conf y certificados en diferentes rutas, como hemos hecho en el servidor, es más cómodo para los clientes tener un único fichero con toda la información necesaria para conectarse. Como dijimos antes, los ficheros de credenciales son un buen punto de partida. En este apartado veremos un archivo de configuración de ejemplo con todo lo necesario. Deberemos crear un archivo por cada dispositivo, y deben tener la extensión .ovpn.

# Utilizaremos el protocolo UDP proto udp # o, si lo preferimos, el protocolo TCP #proto tcp-client persist-tun # Servidor y puerto al que nos conectaremos remote midominio.com 1194 # Asumimos el rol de cliente en la VPN client # Y lo mismo al cifrar las comunicaciones con TLS tls-client # Reforzamos el algoritmo de autentificación auth SHA512 # Antes de desconectarnos, notificaremos al servidor para que libere recursos de forma eficiente explicit-exit-notify 1 # Sólo se acepta el certificado TLS si este es de tipo servidor remote-cert-tls server # La versión mínima soportada de TLS será la 1.2 tls-version-min 1.2 # El servidor necesita autentificación con usuario y contraseña auth-user-pass # El usuario y la contraseña, por seguridad, no se almacenan en memoria una vez se han usado auth-nocache # Tipo de dispositivo de red dev tun # Autoridad certificadora <ca> Contenidos del fichero /etc/openvpn/certs/pki/ca.crt. Viene en el fichero de credenciales. </ca> # Certificado del cliente <cert> Contenidos del archivo /etc/openvpn/certs/pki/issued/pedro-windows.crt o pedro-iphone.crt, según corresponda. Viene en el fichero de credenciales. </cert> # Clave privada del cliente <key> Contenidos del fichero /etc/openvpn/certs/pki/private/pedro-windows.key o pedro-iphone.key, según corresponda. Viene en el fichero de credenciales. </key> # Clave de ofuscación <tls-crypt-v2> Contenidos del archivo de clave de ofuscación del cliente, según corresponda. No viene en el fichero de credenciales. </tls-crypt-v2>

Ahora ya tenemos todo lo necesario para que el cliente se conecte: un archivo de configuración, un usuario y una contraseña. Podrá entrar en la VPN, interactuar con los demás clientes a través de ella, y visitar sitios web dificultando que los atacantes espíen su tráfico. Sin embargo, no podríamos finalizar este tutorial sin mencionar los principales clientes.

5. OpenVPN y OpenVPN Connect

OpenVPN, aunque es software libre y acepta colaboraciones de la comunidad, dispone de una versión de pago con opciones avanzadas para empresas. Una de sus soluciones, OpenVPN Access Server, facilita la gestión de certificados, cuentas de usuario y distribución de configuraciones de cliente, y admite dos usuarios totalmente gratis. Por otro lado, si no disponemos de servidor propio, se puede usar la nube de OpenVPN, y establecer una conexión a través de sus propias redes. Ofrece tres conexiones gratuitas. En cuanto a clientes, en la web se hace una diferenciación: por un lado están los de la comunidad, y por otro OpenVPN Connect, más orientado al mundo empresarial. En realidad, tienen características muy parecidas y funcionan de manera similar. En Windows, OpenVPN Connect está creado con una interfaz Electron que, por algún motivo desconocido, resulta casi imposible de manejar con lectores de pantalla. Por tanto, es mejor el cliente libre: https://openvpn.net/community-downloads/ La interfaz de este segundo cliente está en español y utiliza controles clásicos. Desde su icono en la bandeja del sistema y su ventana podremos hacer las principales operaciones: importar archivos de configuración, conectarnos e introducir el nombre de usuario y la contraseña. Por si fuera poco, también facilita la gestión de archivos .ovpn en el explorador de Windows. Dispone de opciones más avanzadas, y se puede usar para levantar un servidor en Windows, pero eso queda fuera de este tutorial. En las plataformas móviles, OpenVPN Connect se vuelve más manejable, y es la única alternativa que tenemos. Se puede descargar para iPhone y Android. Puede importar archivos de configuración desde una URL, y puede aceptar archivos compartidos desde otras aplicaciones. Por el momento, no es capaz de importar archivos almacenados en el teléfono desde la propia app, al menos en iPhone.

6. Anexo: creación de una red de puente

Este apartado está pensado sólo para servidores Linux caseros (tipo Raspberry Pi) y clientes Windows. Al profundizar como vamos a hacer, las diferencias entre plataformas ya comienzan a notarse y hacen que todo se vuelva más complejo. A lo largo de este tutorial hemos creado una VPN que nos permite redirigir nuestro tráfico de Internet, conectarnos con otros dispositivos e intercambiar información de manera segura como si todos estuvieran en la misma red. Sin embargo, hay paquetes de red a bajo nivel que no pasan por la VPN, y nos pueden servir para tareas tales como buscar y conectarnos a dispositivos que se encuentran en la red de casa, o simplemente desviar esos paquetes también por nuestra red. Con las mejoras que aplicaremos a continuación, los dispositivos que tenemos en casa podrán vernos y conectarse como si nuestro equipo estuviera ahí, y será el router el encargado de asignarnos una dirección IP. Para conservar la implementación hecha hasta aquí, trabajaremos sobre un nuevo archivo de configuración creado a partir del que ya tenemos. Lo llamaremos servidor-tap: cp /etc/openvpn/server/servidor.conf /etc/openvpn/server/servidor-tap.conf Ahora, editamos el fichero servidor-tap.conf y realizamos los siguientes cambios:

  • Cambiamos el puerto 1194 por otro, por ejemplo el 1195: port 1195
  • Eliminamos la línea dev tun, ya que usaremos otro dispositivo. En su lugar, escribiremos dev tap0
  • Eliminamos la línea que comienza por server, ya que no definiremos una subred propia. En su lugar, escribimos esto: server-bridge
  • Podemos tener un registro independiente para esta nueva instancia: log /var/log/openvpn/openvpn-tap.log
  • Eliminamos la línea que comienza por ifconfig-pool-persist. Ahora el encargado de asignarnos dirección IP no es OpenVPN.
  • Eliminamos la línea que comienza por push “dhcp-option DNS…, ya que será el router quien nos indique los servidores DNS.

Podemos reutilizar un fichero de cliente en Windows. Los cambios son bastante más simples en este caso. Basta con sustituir la línea dev tun por dev tap.

Para acabar, generaremos y ejecutaremos un script en el servidor. Dicho script permitirá iniciar y detener el puente de red que usará el servidor VPN en modo tap. Se debe configurar con mucho cuidado, especialmente si trabajamos por ssh. Cualquier descuido nos puede dejar sin red hasta el reinicio del dispositivo. El script que se proporciona a continuación construye el puente, modifica iptables para que la VPN de apartados anteriores siga funcionando, y pone en marcha la nueva si se llama con el argumento start. Si se llama con el argumento stop, deshace todos los cambios que ha hecho. Podemos alojarlo en el archivo /usr/local/bin/openvpn-bridge. Antes de probarlo, se deben modificar las primeras líneas y adaptarlas a nuestras necesidades:

#!/bin/sh # Interfaz de puente. Se puede dejar la que viene por defecto br="br0" # Lista de interfaces tap que participan en el puente, # por ejemplo tap="tap0 tap1 tap2". # Se puede dejar la que viene tap="tap0" # Interfaz de red real del sistema # Mismo nombre de adaptador que en el tutorial eth="enp5s0f0" # Ip local del servidor y máscara de subred en formato abreviado eth_ip_netmask="192.168.1.2/24" # Ip de broadcast. Suele ser la 255 de la subred eth_broadcast="192.168.1.255" # Puerta de enlace. Suele coincidir con la IP del router eth_gateway="192.168.1.1" # MAC del adaptador de red del servidor. Se la asignaremos al adaptador de puente para que el router no note la diferencia eth_mac="1a:2b:3c:4d:5e:6f" case "$1" in start) for t in $tap; do openvpn --mktun --dev $t done brctl addbr $br brctl addif $br $eth for t in $tap; do brctl addif $br $t done for t in $tap; do ip addr flush dev $t ip link set $t promisc on up done ip addr flush dev $eth ip link set $eth promisc on up ip addr add $eth_ip_netmask broadcast $eth_broadcast dev $br ip link set $br address $eth_mac ip link set $br up ip route add default via $eth_gateway systemctl start openvpn-server@servidor-tap # Adaptar subred si es necesario iptables -t nat -D POSTROUTING -s 10.0.0.0/8 -o $eth -j MASQUERADE iptables -t nat -A POSTROUTING -s 10.0.0.0/8 -o $br -j MASQUERADE ;; stop) systemctl stop openvpn-server@servidor-tap # Adaptar subred si es necesario iptables -t nat -D POSTROUTING -s 10.0.0.0/8 -o $br -j MASQUERADE iptables -t nat -A POSTROUTING -s 10.0.0.0/8 -o $eth -j MASQUERADE ip link set $br down brctl delbr $br for t in $tap; do openvpn --rmtun --dev $t done ip link set $eth promisc off up ip addr add $eth_ip_netmask broadcast $eth_broadcast dev $eth ip route add default via $eth_gateway ;; *) echo "Usage: openvpn-bridge {start|stop}" exit 1 ;; esac exit 0

Ahora que toda la información está en el script, lo convertimos en ejecutable: chmod +x /usr/local/bin/openvpn-bridge Y para terminar, ponemos en marcha nuestra nueva VPN basada en puente de red: openvpn-bridge start Para detener el puente y devolver la red a su estado anterior: openvpn-bridge stop De momento, no se dan instrucciones para que el puente se ponga en marcha al iniciar el sistema. Tal vez lo hagamos en una próxima revisión de este tutorial. Tras completar este apartado, tenemos no uno, sino dos servidores VPN. El primero podemos compartirlo con invitados de confianza que dispongan de una amplia variedad de dispositivos. El segundo creará una relación más profunda y cercana con nuestra red y sus dispositivos, y funcionará sólo con clientes que tengan Windows.

7. Referencias

He tenido que leer diversos tutoriales en la red para hacerme una idea de la configuración que más se ajustaba a lo que quería. Y como siempre, me olvido de quién los ha escrito y de su dirección. Sin embargo, no me baso en ellos para escribir los míos propios, sino en las fuentes de información que acompañan al producto:

  • Página de manual de OpenVPN, disponible en /usr/share/doc/openvpn/openvpn.8.html. Existen versiones equivalentes en línea, pero ninguna tan actualizada como la que acompaña al paquete.
  • Por qué deberías usar certificados ECC en vez de RSA: https://www.thesslstore.com/blog/you-should-be-using-ecc-for-your-ssl-tls-certificates/
  • La ayuda de easy-rsa, que se puede obtener con el comando ./easyrsa help.
  • Las páginas de documentación de OpenVPN, en las que se explica, entre otras cosas, cómo agregar el repositorio para Debian y ciertos conceptos de red que pueden no quedar claros al principio.
  • Y mucha, mucha paciencia y pruebas, en las que ha habido no pocos errores.

¡Muchas gracias por leer hasta aquí! Si tienes un servidor VPS, ahora te toca a ti.

Tutorial: Instalación de Arch Linux de forma accesible (Página de inicio on Un sitio solicitado por la comunidad, para la comunidad)

Hola a todos. En esta entrada vengo con un tutorial muy especial, un tutorial que lleva años en un archivo en mi disco duro y que ha evolucionado muchísimo a lo largo del tiempo. Empecé haciéndolo para publicarlo en una web de cuyo nombre no quiero acordarme, después lo conservé y lo actualicé para mí, para no olvidar lo que en él se cuenta, y ahora he vuelto a adaptarlo para publicar una vez más. Esta vez no hablaremos de un programa, servicio o protocolo, sino de un sistema operativo completo. Un sistema que tal vez no esté preparado para sustituir a Windows todavía, o tal vez sí. Eso dejaremos que lo decida cada uno después de leer y probar por sí mismo. Antes de entrar en faena, pido perdón a los que saben más de Linux que yo y lo usan diariamente, pues estoy seguro de que este documento no está exento de errores y suposiciones que a lo mejor en realidad resultan de otra manera. Lo he hecho lo mejor que he podido, esforzándome para que los usuarios con menos conocimientos entiendan cuál es el propósito de cada comando, paquete o ajuste realizado. Dicho todo esto, ¡empezamos!

Introducción

En este tutorial vamos a instalar Arch Linux, una distribución ligera, simple y flexible de Linux, y lo vamos a hacer de forma accesible en una máquina virtual, con instrucciones para hacerlo también en un equipo físico o preparar un pen drive que se pueda conectar a cualquier ordenador. Al acabar, y si se siguen bien todos los pasos del tutorial, Arch Linux debería estar ejecutándose en español, con varios escritorios y lector de pantalla .

¿Qué caracteriza a esta distribución?

Arch Linux se caracteriza por ser una distribución pequeña, potente, simple y flexible. No se suele usar en entornos de producción, ya que actualiza los paquetes en cuanto son publicados por sus respectivos desarrolladores, y esto puede generar cierta inestabilidad aunque hayan sido calificados como estables. Viene muy bien para desarrollar y hacer pruebas de todo tipo, y para conocer Linux en toda su extensión. Arch no tiene herramientas que automaticen cosas tales como la instalación del sistema o la configuración de ciertos paquetes, y por tanto hay que operar a bajo nivel. Otra característica por la que Arch destaca es el Arch User Repository (aur), que contiene software en forma de código fuente, así como archivos de configuración para poder compilarlo sin errores, de forma automatizada y con las dependencias necesarias. Visitar el sitio web de Arch Linux

Requisitos de software

Para poder hacer todos los pasos descritos en este tutorial, se ha utilizado el siguiente software. Hay programas alternativos que hacen las mismas funciones, pero no se han probado a la hora de hacer este proceso y podrían dar malos resultados:

Conocimientos necesarios

Para no tener problemas durante la instalación de Arch, hay que disponer de los siguientes conocimientos:

  • Manejo del OCR, la navegación por objetos y los comandos de revisión de NVDA (sólo en máquina virtual y con acceso SSH).
  • Experiencia a la hora de crear y configurar máquinas virtuales, ya que en este tutorial no se explicará nada sobre ello.
  • Tener experiencia manejando algún intérprete de línea de comandos, ya sea cmd o bash, y comprender los resultados devueltos por la ejecución de un comando.

Preparación del equipo y el medio de instalación

Bien, teniendo todas las herramientas citadas en el apartado anterior, podemos comenzar.

Creación de la máquina virtual

Para este tutorial se ha utilizado una máquina virtual con las siguientes características:

  • Memoria ram: 4 GB, aunque se puede reducir bastante, incluso hasta 512 MB
  • Procesador: Se han utilizado 6 procesadores con 2 cores y virtualización de IOMU, pero la máquina puede ejecutarse sin problema con mucha menos potencia.
  • Disco duro: 32 GB NVMe, dividido en varios archivos y con expansión dinámica
  • red: Para poder trabajar con la máquina independientemente del lugar en el que nos encontremos, se ha usado nat. Se puede poner en bridged para situar la máquina en la misma subred que el resto de equipos físicos, o añadir un adaptador bridged más adelante.
  • Tipo de bus: paravirtualized SCSI. Se puede elegir sin problema cualquiera de los otros.
  • Compatibilidad del hardware: Workstation 17.5.x, aunque las anteriores tampoco deberían dar problemas.
  • Teclado mejorado.
  • Controlador USB 3.1.
  • Aceleración de gráficos.
  • Resto de parámetros: Se pueden dejar por defecto. En el asistente de creación diremos que instalaremos el sistema más tarde, y que es un Linux de tipo Other Linux kernel 6.x 64-bit. No olvidemos apuntar la unidad de cd al archivo iso del sistema operativo.

A continuación, en las opciones avanzadas de la máquina virtual, pestaña Options, categoría Advanced, podremos elegir el tipo de firmware. Elige BIOS si quieres emular un pc tradicional, o Uefi si deseas un firmware más moderno. La forma de particionar e instalar el gestor de arranque varían.

Preparación del medio de instalación

Al arrancar la máquina virtual por primera vez, se escucharán dos tonos ascendentes. Dichos tonos indican que el menú de arranque de Isolinux está en pantalla, listo para elegir una opción. Entraremos en la máquina, pulsaremos flecha abajo y a continuación enter. Si tomamos instantáneas con el OCR, veremos que el sistema se va cargando, se montan los sistemas de archivos, se inicia la red, etc. Por último, escucharemos a Speakup hablando, veremos que root ha iniciado sesión automáticamente, y que la consola está lista para escribir comandos. Es en este momento cuando entraremos dentro de la máquina. Lo primero que se debe hacer es poner el teclado en español. Esto se hace llamando a loadkeys, que recibe como parámetro un archivo de mapa de teclado. En nuestro caso: loadkeys es Y ya estamos listos para escribir comandos.

Personalización de la voz de Speakup

Speakup comenzará hablando en inglés, algo que puede ser muy incómodo si no somos angloparlantes. Para cambiar el idioma de la voz, deberemos editar el archivo que carga el servicio del lector de pantalla. Usaremos un comando como este para hacerlo: nano /lib/systemd/system/espeakup.service La consola cambiará radicalmente al ejecutar este comando, mostrando el editor de textos nano. Podemos usar las flechas para movernos por el texto, NVDA y Speakup anunciarán correctamente nuestra posición. Usando las flechas, buscaremos una línea con el siguiente contenido: environment="default_voice=" Y la completaremos del siguiente modo: environment="default_voice=es" Para guardar los cambios, pulsamos control+x, la y para confirmar, y enter. Después, ejecutamos estos dos comandos para recargar la unidad de servicio modificada y reiniciarlo: systemctl daemon-reload systemctl restart espeakup Speakup ya debería hablar con una voz española. Si queremos subir el volumen, este comando puede servir: amixer set Master 100%

Conexión a Internet

Arch Linux necesita descargar sus paquetes desde la red. Se puede preparar un medio de instalación con paquetes ya descargados, pero el método para hacerlo se sale del propósito de esta guía. Al trabajar con una máquina virtual, esta ya estará conectada, por lo que puedes saltar a la siguiente sección. Antes de hacerlo, no obstante, sincroniza el reloj con el comando que aparece al final. Si instalas Arch en un equipo real, lo mejor que puedes hacer es conectarlo por cable a la red. Si dispones de un router con dhcp, todo lo demás sucederá automáticamente. Para conectarte a una red wi-fi, desbloquea los adaptadores disponibles, que podrían estar bloqueados por software: rfkill unblock all Después, abre la consola de iwd: iwctl En ella, se pueden enumerar los dispositivos disponibles: device list A continuación, buscar redes: station dispositivo scan. Sustituye dispositivo por el identificador de tu dispositivo. Y verlas: station dispositivo get-networks Finalmente, para conectar: station dispositivo connect nombre_red Si el nombre de la red contiene espacios, debe ir entre comillas. El programa preguntará la contraseña, si la red está cifrada. Para salir de la utilidad iwctl, se debe pulsar ctrl+d. Ahora que está conectada, podemos acceder mediante SSH a la máquina. Pero antes, sincronicemos el reloj con este comando: timedatectl set-ntp true

Acceso mediante SSH

El acceso mediante SSH nos permitirá instalar Arch desde una consola tradicional de Windows, con un lector de pantalla conocido y sin necesidad de acceder a la máquina virtual. Para habilitarlo, haremos lo siguiente:

  • Cambiamos la contraseña de root: passwd. Se debe escribir la contraseña dos veces. No aparecerá ningún carácter en la ventana al teclear.
  • Nos conectamos desde el menú VM > SSH > Connect to SSH. En un equipo real, deberemos conocer su dirección ip. El comando ip a proporcionará la información necesaria.

La primera vez, el cliente SSH nos preguntará si confiamos en la huella identificativa de la máquina. Escribimos yes y pulsamos enter. Después, nos preguntará la contraseña asignada a root. Al escribirla y pulsar enter, estaremos dentro. Nota: con cada arranque del medio de instalación, la huella del sistema cambia. Para evitar errores, edita el archivo .ssh/known_hosts que se encuentra en tu carpeta de usuario y elimina la línea correspondiente a la máquina virtual.

Creación y formateo de particiones

Como ya se ha dicho antes, Arch Linux no tiene un instalador como tal, y todo debe hacerse a mano. El primer paso consiste en particionar el disco duro y formatear las particiones creadas. Existen multitud de esquemas de particionado, como por ejemplo:

  • Una partición ext4 para el sistema operativo y, opcionalmente, una partición swap (ideal en entornos BIOS).
  • Una partición de arranque, que se montaría en /boot, otra partición para el sistema y, opcionalmente, una partición swap (ideal en entornos UEFI).
  • Una partición de arranque, otra partición para el sistema base, otra partición para los usuarios montada en /home y otra partición montada en /usr.

Hay muchas más combinaciones, así como métodos para hacer que Linux coexista con otros sistemas operativos. Por defecto, en la máquina virtual anterior el firmware es de tipo BIOS, pero el modo UEFI es más moderno y se encuentra en todos los equipos físicos nuevos. Elige una de las dos siguientes secciones para particionar tu disco, según corresponda. Para saber si tu sistema utiliza UEFI, usa este comando: ls /sys/firmware/efi/efivars Si el comando falla, entonces estamos en un sistema que usa BIOS, o arranca en modo de compatibilidad con BIOS (CSM). De lo contrario, se trata de un sistema UEFI. En las siguientes secciones, se asume que el disco está en /dev/nvme0n1. Sin embargo, en otras configuraciones de controlador y disco, podría estar en /dev/sda, /dev/vda, /dev/mmcblk0, etc. Utiliza el comando lsblk para descubrir cuál es tu disco de destino.

En sistemas BIOS

Para particionar el disco usaremos la herramienta fdisk, y trabajaremos con el disco duro que creamos cuando hicimos la máquina virtual, y que se encuentra en /dev/nvme0n1: fdisk /dev/nvme0n1 Al ejecutar este comando se cargará la consola de fdisk, y se creará automáticamente una tabla de particiones mbr, ya que el disco no tiene ninguna. Si el disco tuviera alguna, pulsa la o para reemplazarla. Ten en cuenta que los cambios no se escribirán hasta completar todos los pasos, así que no hay nada que temer. A continuación pulsamos la tecla n y enter para crear una nueva partición. Fdisk nos preguntará de qué tipo debe ser la partición. Como el tipo está puesto por defecto en primaria, no tenemos que pulsar la letra p, tan sólo pulsar enter de nuevo. A continuación nos preguntará el número de partición primaria que utilizaremos de las 4 disponibles. Una vez más pulsamos enter, ya que el 1 está seleccionado por defecto. Lo siguiente que nos pide es el tamaño de la partición, especificando el desplazamiento inicial. El valor por defecto que se nos ofrece para el sector inicial es el 2048, situado más o menos al principio del disco, así que podemos pulsar enter de nuevo sin modificar nada. La primera partición se usará para extender la memoria RAM y será de tipo Swap. Vamos a hacer que ocupe 2 GB. Escribimos +2G y pulsamos enter. Ahora, pulsamos la t para cambiar su tipo. Fdisk preguntará el código hexadecimal correspondiente. Escribimos 82 y pulsamos enter. Repetimos los pasos anteriores para crear una partición para el sistema. Como queremos que la partición ocupe el resto del disco, pulsamos enter sin introducir nada cuando fdisk nos pregunta por el sector final. Finalmente, veremos un mensaje como este: Created a new partition 2 of type 'Linux' and of size 30 GiB. El tipo es Linux, así que no hay que modificarlo. Lo que sí se debe hacer es marcar la partición creada como autoarrancable, o de lo contrario el sistema no podrá iniciarse. Para ello pulsamos la a, y enter nuevamente. Tras pulsar el 2 para indicar la segunda partición, veremos el siguiente mensaje: The bootable flag on partition 2 is enabled now. Pulsando la p podemos ver un esquema general de lo que hemos creado. Si todo es correcto, se puede pulsar la w para escribir los cambios en el disco. De lo contrario, se puede pulsar la q para salir sin guardar nada. Ya tenemos las particiones creadas y asociadas a los dispositivos /dev/nvme0n1p1 y /dev/nvme0n1p2. Lo siguiente que hay que hacer es formatearlas. El siguiente comando preparará la partición swap: mkswap /dev/nvme0n1p1 Y con la utilidad mkfs.ext4, formatearemos la principal: mkfs.ext4 /dev/nvme0n1p2

En sistemas UEFI

Para particionar el disco usaremos la herramienta gdisk, y trabajaremos con el disco duro que creamos cuando hicimos la máquina virtual, y que se encuentra en /dev/nvme0n1: gdisk /dev/nvme0n1 Al ejecutar este comando se cargará la consola de gdisk, y se creará automáticamente una tabla de particiones gpt, ya que el disco no tiene ninguna. Si el disco tuviera alguna, pulsa la o para reemplazarla. Ten en cuenta que los cambios no se escribirán hasta completar todos los pasos, así que no hay nada que temer. Lo primero que haremos será crear la partición de arranque, a la que asignaremos 512 MB, o hasta 4 veces más si pretendemos instalar varios núcleos. Para ello, pulsamos la n, seguida de enter. En todos los casos, se puede dejar el número de partición como está y pulsar enter. El primer sector comienza en 2048. Por defecto, gdisk siempre nos ofrecerá un primer sector recomendado en función del final de la partición anterior, o en este caso, el más adecuado al principio del disco. Después, nos preguntará por el sector final. Escribimos +512M y pulsamos enter. Para completar la partición, gdisk necesita conocer su tipo. El tipo de las particiones EFI es ef00. Ahora, repetiremos los pasos y crearemos una partición swap de 2 GB, y una partición Linux con el espacio restante. El tipo correspondiente a la partición swap es 8200, mientras que para una partición Linux estándar es 8300. En este último caso, no hace falta escribirlo. Ya tenemos la tabla de particiones lista. Pulsando la w seguida de enter, y tras responder afirmativamente a la pregunta de seguridad, se grabará en disco. Las particiones están creadas y asociadas a los dispositivos /dev/nvme0n1p1, /dev/nvme0n1p2 y /dev/nvme0n1p3. Lo siguiente que hay que hacer es formatearlas. Formateamos la partición EFI en FAT32: mkfs.fat -F 32 /dev/nvme0n1p1 El siguiente comando preparará la partición swap: mkswap /dev/nvme0n1p2 Y con la utilidad mkfs.ext4, formatearemos la principal: mkfs.ext4 /dev/nvme0n1p3

Si todo sale bien, el disco está correctamente formateado y listo para que podamos instalar el sistema operativo.

Instalación de Arch Linux

El primer paso para poder instalar Arch Linux es montar las particiones creadas con anterioridad. Deberemos montar tanto la partición swap como la ext4, y la partición EFI en sistemas UEFI. Se puede hacer con los siguientes comandos.

BIOS

Montamos la partición swap: swapon /dev/nvme0n1p1 Montamos la partición ext4 en la carpeta /mnt: mount -t ext4 /dev/nvme0n1p2 /mnt

UEFI

Montamos la partición swap: swapon /dev/nvme0n1p2 Montamos la partición ext4 en la carpeta /mnt: mount -t ext4 /dev/nvme0n1p3 /mnt Y montamos la partición EFI, creando una subcarpeta para ella: mount --mkdir -t vfat /dev/nvme0n1p1 /mnt/boot

Teniendo montadas las particiones, le llega el turno a pacstrap. Pacstrap es un script que se encarga de instalar paquetes. Recibe como primer parámetro la ruta donde se instalarán. El resto de argumentos son nombres de paquetes o grupos de paquetes, como base, base-devel, gnome, gnome-extra, etc. En este tutorial vamos a instalar los grupos base y base-devel, no queremos todavía entornos de escritorio. También instalaremos un kernel, el firmware, controladores para tarjetas de sonido, el lector de pantalla speakup, las utilidades para controlar la tarjeta de sonido y un editor de texto: pacstrap /mnt base base-devel linux linux-firmware sof-firmware espeakup alsa-utils nano Al ejecutar este comando se iniciará la descarga e instalación de paquetes. Obtendremos los paquetes básicos, el kernel, y el compilador gcc. Más adelante este último será indispensable para instalar paquetes desde el Arch User Repository. Terminada la instalación, generamos un archivo fstab para que el sistema instalado pueda montar los sistemas de archivos adecuadamente al arrancar: genfstab -U -p /mnt >> /mnt/etc/fstab Lo siguiente que debemos hacer es simular que estamos trabajando desde la copia que acabamos de instalar. Para ello tenemos el comando arch-chroot. Recibe como argumento la ruta a la que queremos cambiarnos. Podemos escribir algo como esto: arch-chroot /mnt Se cargará la consola bash de la copia instalada, y la raíz del sistema de archivos estará en /mnt. No podremos manipular el sistema de archivos que se cargó inicialmente en el live cd hasta que salgamos de aquí. Vamos a seguir modificando aspectos de la instalación. Lo primero que haremos será establecer un nombre de equipo. Este nombre hay que grabarlo en el archivo /etc/hostname, y en nuestro tutorial será arch-vmware: echo arch-vmware > /etc/hostname Importante: en este tutorial se emplea mucho el comando echo para escribir información en archivos de texto. Ten en cuenta que este comando escribe líneas en esos archivos, por lo que sólo debe usarse una vez. Si quieres deshacer algún cambio, utiliza un editor para cambiar el archivo, como por ejemplo nano. Ahora vamos a establecer el idioma y la zona horaria, ya que nuestra copia instalada no está aún en español. Para ello debemos editar el archivo /etc/locale.gen: nano /etc/locale.gen Se deben eliminar los comentarios de los idiomas que queramos habilitar, borrando el signo de número que hay delante de cada uno. En nuestro caso, vamos a habilitar el inglés de Estados Unidos y el español de España, ambos en UTF-8. Corresponden a las líneas que empiezan por en_US.UTF-8 y es_ES.UTF-8. Siempre se recomienda habilitar el inglés de Estados Unidos, ya que muchos programas lo buscarán cuando alguna cadena de texto no esté traducida. Para guardar los cambios, pulsamos ctrl+x, respondemos que sí pulsando la y, y finalmente pulsamos enter. Volveremos nuevamente a la consola bash. Ahora, generamos los idiomas: locale-gen Y finalmente, establecemos el español como idioma del sistema: echo LANG=es_ES.UTF-8 > /etc/locale.conf El método para establecer la zona horaria es distinto al de cambiar el idioma. En este caso tenemos que crear un vínculo simbólico. La sintaxis sería: ln -sf /usr/share/zoneinfo/zone/subzone /etc/localtime En este ejemplo vamos a establecer la hora de Madrid: ln -sf /usr/share/zoneinfo/Europe/Madrid /etc/localtime A continuación, configuramos el ajuste horario con este comando: hwclock --systohc Y habilitamos un servicio para que sincronice el reloj con Internet: systemctl enable systemd-timesyncd Para terminar, debemos hacer que el teclado virtual también esté en español: echo KEYMAP=es > /etc/vconsole.conf Ya hemos terminado de establecer las preferencias de idioma, zona horaria y teclado. Es hora de ocuparnos de otras cosas, como la red. Por defecto, la iso de Arch Linux está configurada para usar una red cableada, buscar un servidor dhcp, y obtener la dirección ip dinámicamente. En la copia instalada necesitamos instalar un gestor de red y habilitarlo: pacman -S --noconfirm networkmanager systemctl enable NetworkManager systemctl enable systemd-resolved Otro pequeño problema que nos vamos a encontrar es que el nombre del host no se anuncia en la red local. Para resolverlo, vamos a instalar samba: pacman -S --noconfirm samba El servicio que nos interesa habilitar es el nmb, encargado de anunciar el nombre de la máquina. Para ello hacemos: systemctl enable nmb Pero cuidado, aquí debemos hacer algo más, ya que los servicios de Samba necesitan leer de un archivo de configuración, y no tienen ninguno: touch /etc/samba/smb.conf Ya tenemos todo listo para que el servicio nmb funcione. Vamos a instalar el preciado servidor ssh, para poder conectarnos desde fuera de la máquina si fuera necesario: pacman -S --noconfirm openssh systemctl enable sshd Permitimos que root inicie sesión con contraseña: echo permitRootLogin yes >> /etc/ssh/sshd_config Con la ayuda del editor nano, podemos cambiar la voz de Speakup, tal y como hicimos en el medio de instalación. Consulta las primeras secciones de este tutorial para encontrar las instrucciones. Recuerda habilitar el servicio: systemctl enable espeakup Para acabar de instalar nuestra copia de Arch, nos falta cambiar la contraseña de root e instalar un cargador de arranque. Lo primero se puede hacer ejecutando simplemente el comando passwd, tal y como hicimos anteriormente: passwd Para lo segundo debemos instalar otro paquete y ejecutar un par de comandos. Instalamos el gestor de arranque grub: pacman -S --noconfirm grub

En sistemas BIOS

Instalamos el gestor de arranque en el sector mbr, y en el sector de arranque de la partición: grub-install --recheck /dev/nvme0n1

En sistemas UEFI

Instalamos el paquete efibootmgr: pacman -S --noconfirm efibootmgr Instalamos el gestor de arranque en la partición EFI: grub-install --target=x86_64-efi --efi-directory=boot --bootloader-id=GRUB Si se añade al comando anterior el argumento --removable, Grub no modificará las variables EFI alojadas en la NVRAM y quedará preparado para arrancar desde un disco extraíble. Útil si, por ejemplo, estamos creando un pen drive con un sistema operativo para llevar y usar en cualquier ordenador con Uefi. Se puede añadir al disco extraíble soporte para sistemas BIOS con capacidad de arrancar discos GPT. Para ello, usa gdisk y crea una cuarta partición entre los sectores 34 y 2067. Deberás indicar que su tipo es ef02. No importa su orden en la tabla, puedes crearla incluso con el sistema ya instalado. Después, instala GRUB una segunda vez. Por ejemplo: grub-install --target=i386-pc /dev/nvme0n1 Importante: tal y como se ha configurado, Arch no iniciará si el arranque seguro está activado. Deberás desactivarlo en la configuración de tu firmware.

Opcionalmente, se pueden instalar las imágenes que actualizan el microcódigo del procesador: pacman -S --noconfirm intel-ucode amd-ucode También se puede (y se recomienda) configurar Grub para que emita un pitido al arrancar. Así sabremos en qué momento podemos manipular el gestor de arranque, llegado el caso. Se puede configurar un pitido simple: echo GRUB_INIT_TUNE=\"480 440 1\" >> /etc/default/grub O uno más complejo y entretenido: echo GRUB_INIT_TUNE=\"1750 523 1 392 1 523 1 659 1 784 1 1047 1 784 1 415 1 523 1 622 1 831 1 622 1 831 1 1046 1 1244 1 1661 1 1244 1 466 1 587 1 698 1 932 1 1195 1 1397 1 1865 1 1397 1\" >> /etc/default/grub A continuación, generamos el archivo de configuración: grub-mkconfig -o /boot/grub/grub.cfg Todo listo, es hora de salir del entorno simulado, desmontar las particiones y reiniciar el sistema. Para salir del entorno simulado, podemos escribir exit o simplemente pulsar ctrl+d. Para desmontar las particiones, usaremos los siguientes comandos.

En sistemas BIOS

umount /mnt swapoff /dev/nvme0n1p1

En sistemas UEFI

umount /mnt/boot umount /mnt swapoff /dev/nvme0n1p2

Y, finalmente, para reiniciar: reboot Si todo ha ido bien, nuestro sistema Arch está instalado, y accesible por ssh si se encuentra conectado por cable a la red. Podemos entrar con el siguiente comando: ssh root@arch-vmware Sigamos, ¡falta mucho por hacer!

Cómo subir el volumen para Speakup

La primera vez que iniciemos la copia instalada de Arch, el lector de pantalla se escuchará con un volumen muy bajo o directamente no se escuchará. Esto depende del equipo. La solución pasa por subir el volumen de los canales Master y PCM (si existe) al 100%, quitar sus silencios y guardar los ajustes. Ejecuta estos comandos: amixer set Master unmute amixer set Master 100% amixer set PCM unmute amixer set PCM 100% alsactl store ¡Importante! Este comando no se debe usar si estamos preparando una instalación en un disco extraíble. En su lugar, se debe copiar desde una instalación local el archivo /var/lib/alsa/asound.state ¡Todo listo! Hemos instalado Arch Linux, le hemos dado sonido y un lector de pantalla. Ahora ya no necesitamos un servidor ssh para trabajar desde el exterior, podemos manipular la propia máquina desde sus interfaces locales.

Siguientes pasos.

Actualizar el sistema

Lo primero que se debe hacer antes de instalar paquetes adicionales es tener completamente actualizado nuestro sistema. Vamos a actualizarlo, y a reiniciarlo: pacman -Syu reboot

Instalación de Reflector

Por defecto, Pacman descarga los paquetes desde una lista de sitios que lleva incorporada. Estos sitios, o réplicas, cambian con el tiempo y conviene actualizarlos. De esa forma, obtendremos los paquetes más deprisa, y probablemente desde una ubicación más cercana geográficamente. Para conseguirlo, instalaremos Reflector: pacman -S --noconfirm reflector Ahora, lo configuramos para que arranque con el sistema y lo iniciamos. systemctl enable reflector systemctl start reflector

Instalación de páginas de manual

El comando man puede ser muy útil a la hora de buscar la ayuda de un programa concreto y leer sus páginas de manual. Usa este comando para instalarlo: pacman -S --noconfirm man-pages man-db

Instalación de VMWare Tools (sólo en máquinas virtuales)

Las herramientas de VMWare, o VMWare Tools, permiten a la máquina virtual integrarse mucho mejor con el equipo físico. Podemos utilizar desde carpetas compartidas, hasta arrastrar y soltar para transferir archivos. Instalar las herramientas que VMWare Workstation trae por defecto ya no se recomienda. Todas las distribuciones de Linux incorporan sus propias herramientas. En este caso: pacman -S --noconfirm open-vm-tools Con este paquete se instala un servicio que notifica a VMWare que ya tenemos las herramientas instaladas. Vamos a activarlo y a establecerlo al arranque del sistema: systemctl start vmtoolsd systemctl enable vmtoolsd Tras hacer esto, podemos ir al menú vm en VMWare, ¡y ver que indica que las herramientas están instaladas! Pero... ¿Funciona todo? Todavía no, ya que no tenemos funciones de arrastrar y soltar o copiar y pegar, por ejemplo. Para resolver el problema de arrastrar y soltar, habilitamos e iniciamos un servicio: systemctl enable vmware-vmblock-fuse systemctl start vmware-vmblock-fuse Todo listo. Cuando tengamos un entorno de escritorio, podremos arrastrar y soltar o copiar y pegar archivos desde el equipo físico hacia la máquina, y viceversa.

Instalación de Yay

Como ya se dijo más arriba, una de las características de Arch es la capacidad de compilar e instalar paquetes directamente desde el código fuente. Aunque los paquetes se pueden descargar y compilar manualmente desde el Arch User Repository, el proceso es largo y complicado, así que conviene automatizarlo. Yay es una herramienta muy similar a Pacman y admite sus mismos comandos, pero también trabaja sobre el Arch User Repository además de los repositorios oficiales. Además, no se debería ejecutar con el usuario root, necesita una cuenta estándar con privilegios de superusuario. Con yay podemos descargar, compilar e instalar paquetes, todo en un solo comando. Desgraciadamente, esta herramienta no se puede instalar desde pacman, y por eso le dedicamos un apartado entero en este tutorial. Como a Arch no le gusta compilar paquetes siendo root, lo primero que haremos será crear un usuario administrador, pero sin tantos privilegios: useradd -m usuario En el comando hemos indicado que el usuario se llamará usuario y tendrá un directorio personal para él. Ahora vamos a darle una contraseña: passwd usuario Escribimos la contraseña 2 veces, y la cuenta de usuario ya está lista para su uso. Ahora, escribiremos el siguiente comando para que se puedan obtener más privilegios al ejecutar comandos con sudo: echo "usuario ALL=(ALL:ALL) ALL" >> /etc/sudoers Ahora vamos a instalar el paquete wget para poder descargar los archivos de yay: pacman -S --noconfirm wget Hecho esto, iniciamos sesión con la cuenta usuario. Esto se puede hacer de muchas maneras, por ejemplo con este comando: su -l usuario Si trabajamos con la consola de la máquina virtual, también podemos salir e iniciar sesión desde allí. Lo mismo si trabajamos con ssh: ssh usuario@arch-vmware Teniendo la sesión iniciada y estando en nuestro directorio personal, comenzamos a descargar y compilar paquetes. Descargamos Yay: wget https://aur.archlinux.org/cgit/aur.git/snapshot/yay.tar.gz Tras descargarlo, el primer paso es extraerlo: tar -zxf yay.tar.gz A continuación, navegamos al directorio que se ha extraído: cd yay Construimos el paquete y lo instalamos una vez compilado: makepkg -si Yay ya está listo para la acción. Podemos instalar cualquier paquete desde el Arch User Repository con facilidad, siempre desde la cuenta estándar y sin llamar a sudo. Por ejemplo, el paquete needrestart, que ayuda a reiniciar sólo los servicios necesarios tras una actualización, en vez del equipo entero: yay -S --noconfirm needrestart En procesadores Intel, Needrestart se puede complementar con la herramienta iucode-tool: yay -S --asdeps --noconfirm iucode-tool Observa que el primer paquete se descarga desde el Arch User Repository, mientras que el segundo procede de los repositorios oficiales. El segundo se ha instalado como una dependencia opcional. Más adelante veremos qué significa eso.

Activación del repositorio multilib

El repositorio multilib, desactivado por defecto, contiene bibliotecas y aplicaciones de 32 bits, así como software que funciona sobre varias arquitecturas, como Wine o Steam. Para activarlo, hay que editar el archivo /etc/pacman.conf con cualquier editor, como nano. En él, las líneas de los repositorios multilib y multilib-testing vienen comentadas. Es decir, llevan un signo de número delante. Bastará con eliminarlo y guardar los cambios para activar el repositorio. Ten en cuenta que sólo se deben quitar los comentarios de dos líneas, y que no se recomienda habilitar los repositorios testing. Si ya de por sí el software suele ser inestable en Arch, los paquetes que proceden de los repositorios testing lo son aún más.

Búsqueda de paquetes con Pacman

Para buscar paquetes con Pacman, ejecuta un comando similar a este: pacman -Ss palabra

Limpieza de la caché de paquetes

Después de instalar nuevos paquetes o actualizar el sistema, los paquetes comprimidos que se han descargado permanecen en el disco ocupando espacio. Para limpiar la caché y borrarlos, usa este comando: pacman -Scc O, incluso mejor, hazlo con Yay: yay -Scc

Eliminación de paquetes huérfanos

A veces, un paquete se actualiza y deja de necesitar otro del que antes dependía. Esa dependencia permanece en el sistema y no se desinstala por sí sola. Con el tiempo, esto puede llegar a ser un problema. Ejecuta el comando pacman -Qtdq | pacman -Rns - para buscar y eliminar paquetes huérfanos.

Instalación del escritorio gnome

Gnome es uno de los entornos de escritorio más populares para Linux, y uno de los que mejor integra la accesibilidad. En el caso de Arch, en los repositorios hay 2 grupos de paquetes que podemos instalar: gnome y gnome-extra. Instalamos ambos grupos con este comando: pacman -S --noconfirm --needed gnome gnome-extra Para completar Gnome con todas las aplicaciones que no se encuentran en dichos grupos, podemos ejecutar un comando como este, que instalará todos los paquetes con la palabra gnome en su nombre: pacman -S --needed $(pacman -Ssq gnome) Se instalarán todos los paquetes necesarios, incluyendo orca, el lector de pantalla de escritorio de Linux, y aplicaciones gráficas con diversas funciones (gestión de discos, correo electrónico, chat, e incluso algún juego). El proceso es largo, así que hay que tener paciencia. Si tienes una línea Braille, añade tu usuario al grupo brlapi: usermod -a -G brlapi usuario E instala el paquete que permite el inicio automático al detectar líneas conectadas por USB: pacman -S --asdeps --noconfirm brltty-udev-generic Ponemos el teclado en español para las aplicaciones gráficas: localectl set-x11-keymap es,es ¡Importante! Este comando no funcionará en imágenes fuera de línea, por ejemplo al crear una unidad extraíble. En su lugar, copia desde una instalación local de Arch el archivo /etc/X11/xorg.conf.d/00-keyboard.conf Por último, ponemos al arranque el servicio gdm, que se encarga de gestionar el escritorio, mostrar la pantalla de inicio de sesión y otras tareas de vital importancia: systemctl set-default graphical systemctl enable gdm También activamos un servicio que montará automáticamente dispositivos extraíbles: systemctl enable udisks2 Y reiniciamos el equipo a modo de precaución: reboot Al arrancar el servicio gdm, desaparece la consola de la máquina virtual. Espeakup deja de hablar, y se muestra ante nosotros la pantalla de inicio de sesión. Ahora, si queremos un lector de pantalla, se debe activar orca pulsando windows+alt+s. Pulsando ctrl+alt+tab, podemos navegar entre los distintos paneles que componen el escritorio. En este caso tenemos el de bloqueo, la barra superior y el de iniciar sesión. Iremos a este último, y entraremos con la cuenta de usuario estándar que creamos al principio. Los paneles cambiarán, pero la forma de navegar es la misma. Al escribir la contraseña y pulsar enter, Orca dejará de hablar. Lo activamos nuevamente pulsando windows+alt+s. El entorno de escritorio gnome estará listo para su uso. ¡Disfruta!

Instalación del escritorio Mate

Mate es un escritorio basado en el antiguo Gnome 2.x. Destaca por su ligereza y poco consumo de recursos, su accesibilidad con Orca y la familiaridad del entorno, que puede recordar más a Windows. Al contrario que Gnome, Mate sí tiene un escritorio donde se pueden depositar accesos directos y archivos. El acceso a las aplicaciones se realiza mediante la barra de menú superior, a la que se llega con alt+f1. Mate comparte muchos paquetes con Gnome, y algunas de sus funciones sólo se activan cuando se usa GDM como el administrador gráfico. Podemos instalarlo con estos comandos. Si Gnome ya está instalado, el espacio en disco no aumentará mucho: pacman --noconfirm --needed -S mate mate-extra pacman --needed --noconfirm -S $(pacman -Ssq mate-) En la ventana de inicio de sesión, si navegamos con el tabulador justo después de escribir la contraseña, encontraremos un menú para elegir el escritorio predeterminado. Aparecerán todos los escritorios que se encuentren instalados, incluyendo diversas variantes de Gnome y Mate.

Dependencias opcionales

En Arch, muchos paquetes tienen dependencias opcionales. Esto significa que funcionan sin ellas, pero al instalarlas se obtiene una funcionalidad extra. Aquí hay algunas que puedes usar con Gnome para extenderlo aún más. Para instalar una dependencia opcional, se recomienda indicar a Pacman que se trata de una dependencia, y no de una instalación explícita. De esa forma, al desinstalar el paquete que la necesita, también se borrará. Usa un comando como este para conseguirlo: pacman -S --asdeps --noconfirm paquete1 paquete2 paquete3 El paquete Harfbuzz ofrece esta dependencia con utilidades: harfbuzz-utils Para la app Juegos, se pueden instalar todos estos emuladores de consolas antiguas: libretro-beetle-pce-fast libretro-beetle-psx libretro-blastem libretro-citra libretro-flycast libretro-gambatte libretro-mgba libretro-nestopia libretro-parallel-n64 libretro-picodrive gamemode Estos paquetes extenderán la app Herramientas de red: nmap bind net-tools Con este otro, se puede jugar al ajedrez contra el ordenador: gnuchess Este paquete aparece como opcional al instalar Code assistance: jedi-language-server Si usas el programa de correo Evolution, estos son sus paquetes opcionales, empleados para filtrar spam: highlight evolution-spamassassin evolution-bogofilter Este paquete permite al escritorio gestionar perfiles de energía: power-profiles-daemon. Habilita el servicio power-profiles-daemon para que funcione. Y este otro, configurar las impresoras: system-config-printer La aplicación Cajas usa el emulador Qemu para ejecutar máquinas virtuales. Estos paquetes contienen todas sus arquitecturas: qemu-user-static qemu-user qemu-tests qemu-system-xtensa qemu-system-tricore qemu-system-sparc qemu-system-sh4 qemu-system-s390x qemu-system-rx qemu-system-riscv qemu-system-ppc qemu-system-or1k qemu-system-nios2 qemu-system-mips qemu-system-microblaze qemu-system-m68k qemu-system-hppa qemu-system-cris qemu-system-avr qemu-system-arm qemu-system-alpha qemu-system-aarch64 qemu-docs qemu-chardev-baum qemu-block-iscsi qemu-block-gluster qemu-emulators-full qemu-user-static-binfmt qemu-full Si usas el gestor de archivadores, estos paquetes le darán compatibilidad con todos los formatos soportados: squashfs-tools lrzip unace unrar p7zip Brasero permite grabar contenido en cd y dvd. Con estos paquetes opcionales, además, puede personalizar más aspectos de la grabación y procesar contenido multimedia: dvdauthor vcdimager libisofs libburn Esta extensión añade el menú “Enviar a” al explorador de archivos Nautilus: nautilus-sendto Gedit es más que un bloc de notas, pero con sus plugins ofrece todavía más funcionalidades: gedit-plugins Este applet mostrará información de la red: network-manager-applet El soporte NTFS viene integrado en el kernel de Linux desde la versión 5.15, pero algunas aplicaciones siguen necesitando el paquete antiguo para usar sus utilidades: ntfs-3g Con este paquete, el applet de sensores mostrará la temperatura del disco duro: hddtemp Dejando de lado el escritorio, la consola bash puede beneficiarse mucho del autocompletado en ciertas situaciones, incluida la búsqueda e instalación de paquetes. Instala bash-completion para conseguirlo. El motor de sonido Pipewire puede extenderse con este paquete: pipewire-audio Y la herramienta Reflector dispondrá de más mecanismos para descargar la lista de réplicas si se instala el paquete rsync. Con el paquete python-pyudev, la librería libwacom soportará más tipos de hardware. Los paquetes udftools, exfatprogs, dosfstools y xfsprogs extienden la capacidad del servicio udisks2 para montar automáticamente sistemas de archivos.

Ejecución de aplicaciones de Windows

Los archivos .exe y .dll que usamos en Windows no tienen nada que hacer en Linux, a menos que instalemos algo que permita ejecutarlos. Wine, del que ya hablamos al explicar cómo habilitar multilib, es un emulador que permite que los programas de Windows funcionen, siempre que no sean demasiado avanzados. Ten en cuenta que las aplicaciones que se ejecutan dentro de Wine no son accesibles, incluso si logras instalar NVDA: pacman -S --noconfirm wine Por defecto, las aplicaciones para Windows no tendrán sonido, y más si son de 32 bits. Es importante habilitarlo si vamos a trabajar a ciegas. Para ello, instala todas las dependencias opcionales: pacman -S --noconfirm --needed --asdeps lib32-giflib lib32-mpg123 lib32-openal lib32-v4l-utils lib32-libpulse lib32-alsa-plugins lib32-alsa-lib lib32-libxcomposite lib32-libxinerama lib32-opencl-icd-loader lib32-libxslt lib32-gst-plugins-base-libs vkd3d lib32-vkd3d dosbox lib32-gst-plugins-base lib32-gst-plugins-good lib32-libcups lib32-pcsclite pcsclite unixodbc wine-gecko wine-mono

Otras aplicaciones conocidas

A continuación se enumeran algunas aplicaciones de ofimática e Internet que pueden resultar conocidas en Windows y que, de hecho, llevan toda la vida en Linux.

  • LibreOffice: se puede obtener mediante el paquete libreoffice-fresh, o libreoffice-still para la versión de soporte extendido, más antigua. Para que su interfaz esté en español, instala libreoffice-fresh-es o libreoffice-still-es, según corresponda.
  • Firefox y Thunderbird: se pueden instalar escribiendo sus nombres en Pacman, directamente. Para traducir su interfaz, no obstante, también se deben instalar firefox-i18n-es-es y thunderbird-i18n-es-es. El grupo firefox-addons contiene algunas extensiones populares.
  • Chrome: Google Chrome se encuentra disponible en el Arch User Repository con el nombre google-chrome. Para instalar un paquete más libre y procedente de los repositorios oficiales, se puede descargar chromium desde Pacman. Por defecto, el motor Chromium no se comunica con las tecnologías de asistencia. Para cambiar ese comportamiento, se debe agregar la variable de entorno ACCESSIBILITY_ENABLED y darle el valor 1. Ejecuta este comando en la cuenta de usuario estándar (no root) y reinicia el equipo: echo export ACCESSIBILITY_ENABLED=1 >> ~/.xprofile. Ten en cuenta que Chromium utiliza su propia clave API para acceder a los servicios de Google y podría sufrir restricciones puntuales. Ante la duda, usa Chrome.
  • VLC: este reproductor multimedia también se encuentra disponible en los repositorios oficiales de Arch. El paquete opcional lua-socket se puede instalar para activar su servidor http.

Controladores

Arch incluye controladores para una amplia gama de dispositivos. El paquete linux-firmware contiene los más comunes y de código abierto. Ya lo instalamos al principio, junto con sof-firmware, que contiene controladores para tarjetas de sonido. Si te aventuras a instalarlo en un equipo real y algún dispositivo no funciona como debería, prueba estos paquetes:

  • linux-firmware-marvell
  • linux-firmware-qcom
  • linux-firmware-bnx2x
  • linux-firmware-mellanox
  • linux-firmware-qlogic
  • linux-firmware-liquidio
  • linux-firmware-nfp
  • b43-fwcutter
  • alsa-firmware
  • mkinitcpio-firmware (se instala con yay, no forma parte de los repositorios oficiales). Instala todos los módulos firmware, lo que evita errores y advertencias al reconstruir el kernel.

Una vez instalados estos paquetes, conviene recompilar los kernels disponibles con un comando como este, y reiniciar el equipo: mkinitcpio -P Por su parte, el servidor xorg puede funcionar mejor si se instalan controladores para tarjetas gráficas específicas. El grupo xorg-drivers contiene casi todos, con algunas excepciones. Las tarjetas gráficas NVidia necesitan instalar módulos en el kernel. Se puede descargar el controlador propietario más reciente instalando el paquete nvidia para el kernel nativo de Arch, el paquete nvidia-lts para el kernel lts, o el paquete nvidia-dkms para todos en general. En este último caso, deben estar instaladas las cabeceras del kernel o kernels para el que se compilará el módulo. Por ejemplo, linux-zen-headers. El paquete nvidia-settings ofrece una aplicación de configuración para la tarjeta. Se deben habilitar con systemd los servicios nvidia-persistenced, nvidia-powerd, nvidia-hibernate, nvidia-resume y nvidia-suspend para gestionarla de forma óptima. Las tarjetas gráficas AMD pueden funcionar mejor con el paquete amdvlk. Tiene una versión para aplicaciones de 32 bits, llamada lib32-amdvlk. Las tarjetas gráficas Intel ya están soportadas al instalar xorg-drivers, pero otras aplicaciones pueden beneficiarse si se instalan estos paquetes: libva-intel-driver intel-media-driver vulkan-intel lib32-libva-mesa-driver libva-mesa-driver libvdpau-va-gl mesa-vdpau lib32-libva-intel-driver lib32-vulkan-intel Los escáneres pueden verse complementados con el paquete sane-gt68xx-firmware, que incluye controladores para más modelos, y el paquete sane-airscan, que permite usar un escáner inalámbrico que no necesita controladores.

Otros núcleos

Hasta ahora, hemos trabajado con un único kernel, disponible en el paquete linux. Este kernel es genérico, adecuado para cualquier tarea que queramos hacer con el sistema operativo. Sin embargo, en los repositorios oficiales hay otros con distintas características. Puedes instalar varios a la vez, pero es posible que necesites otro esquema de particiones distinto al propuesto en este tutorial para que te quepan todos:

  • linux-lts: el paquete linux-lts ofrece un núcleo con soporte extendido. Va un poco retrasado respecto al kernel normal, pero da más garantías de estabilidad.
  • linux-zen: el kernel zen viene optimizado para equipos de escritorio. Mejora el desempeño de los gráficos y reduce la latencia del audio.
  • linux-hardened: instala este núcleo si lo que quieres es seguridad. Viene optimizado para mitigar vulnerabilidades. En consecuencia, puede hacer que el sistema vaya algo más despacio, y algunas aplicaciones no funcionan con él.
  • linux-rt: núcleo optimizado para trabajar con eventos en tiempo real.
  • linux-rt-lts: versión de soporte extendido del núcleo anterior.

Tras instalar cualquiera de estos núcleos, regenera el archivo de configuración de Grub: grub-mkconfig -o /boot/grub/grub.cfg Por defecto, el kernel zen se situará arriba del todo, convirtiéndose en el primero en arrancar.

Gestión de impresoras

En Linux, el paquete cups es el responsable de comunicarse con las impresoras conectadas. Con la ayuda de cups-browsed, podrá buscar impresoras de red. Instalará unos servicios, que deberemos activar: systemctl enable cups cups-browsed systemctl start cups cups-browsed Cups acepta conexiones desde el navegador en http://localhost:631. Desde allí se pueden gestionar las impresoras existentes, pero Gnome y Mate también ofrecen sus propias aplicaciones para ello. Con el paquete cups-pdf, se instala una impresora virtual capaz de imprimir en archivos PDF. Tan pronto como lo instales, usa tu interfaz preferida de configuración de impresoras para agregarla, ya que no aparecerá por sí sola. En ordenadores reales, se pueden instalar controladores que actuarán de intermediarios entre Cups y diversos modelos de impresoras. Vienen en estos paquetes: foomatic-db foomatic-db-engine foomatic-db-ppds foomatic-db-nonfree-ppds foomatic-db-gutenprint-ppds gutenprint Aunque se cubre una amplia gama de fabricantes y modelos, no funcionarán todos. Pueden hacer falta paquetes adicionales, tanto de los repositorios oficiales como del AUR. Visita esta página en la wiki de Arch Linux para encontrar el tuyo.

Bluetooth

Teniendo instalados todos los paquetes que se han visto a lo largo de este tutorial, el bluetooth se puede usar activando e iniciando este servicio: systemctl enable bluetooth systemctl start bluetooth Para agregar impresoras Bluetooth, además, se debe instalar el paquete bluez-cups.

Redes wi-fi

¿Has instalado Arch en un equipo físico conectado por cable, pero lo tuyo son las redes inalámbricas? Habilita e inicia este servicio: systemctl enable wpa_supplicant systemctl start wpa_supplicant Deberías poder configurar tu red wi-fi desde la barra superior de Gnome. Instala el paquete wireless-regdb para cumplir con la legislación vigente de tu país relativa a canales y potencia de transmisión. Se reconstruirán todos los núcleos instalados, por lo que tendrás que reiniciar el equipo.

Otros administradores gráficos

Existen varios escritorios más que no hemos mencionado en este tutorial porque carecen de accesibilidad con lector de pantalla, o la que tienen es tan pobre que degrada demasiado la experiencia. Con los administradores gráficos sucede lo mismo. Hemos hablado de gdm, el que usan Gnome y Mate, pero no es el único. Lightdm puede ser una buena alternativa en sistemas con bajos recursos. Para instalarlo: pacman -S --noconfirm lightdm lightdm-gtk-greeter Antes de habilitarlo, se debe deshabilitar gdm, ya que sólo puede haber un administrador gráfico en ejecución: systemctl disable gdm systemctl enable lightdm Para indicar a LightDM que use Orca, añadiremos una línea al archivo de configuración de la interfaz: echo reader=orca >> /etc/lightdm/lightdm-gtk-greeter.conf Al reiniciar el sistema, LightDM aparecerá en pantalla. Se puede activar el lector de pantalla Orca pulsando la tecla f4. Pulsando f10 se accede a la barra de menú, desde donde se puede seleccionar qué escritorio arrancará. La tecla f10 accederá a la barra de menú en todas las aplicaciones que la tengan.

Descubrimiento de dispositivos en la red local

Algunos dispositivos y programas, como impresoras, televisores o servidores de archivos, facilitan información a la red local sobre cómo conectarse e interactuar con ellos. Para ello, se apoyan en protocolos como zeroconf y mdns. A pesar de que ya se han instalado utilidades que permiten explorar la red en busca de estos dispositivos, se debe habilitar e iniciar un servicio: systemctl enable avahi-daemon systemctl start avahi-daemon A continuación, para resolver direcciones que acaben en .local, se puede instalar este paquete: pacman -S --noconfirm nss-mdns Y finalmente, usamos nano para editar el archivo /etc/nsswitch.conf. La línea que empieza por “hosts” debe quedar así: hosts: mymachines mdns_minimal [NOTFOUND=return] resolve [!UNAVAIL=return] files myhostname dns Otro servicio que mejora la compatibilidad y el descubrimiento con equipos con Windows es wsdd. Se puede instalar con el siguiente paquete: yay -S wsdd2 Después, es suficiente con habilitar este servicio. Seguirá los mismos ajustes de configuración de Samba, si los hay: systemctl enable wsdd2

Conclusiones

En este tutorial hemos instalado Arch Linux, una distribución pequeña, simple y ligera, donde cada usuario elige lo que quiere y obtiene únicamente lo necesario para conseguir su objetivo. Hemos conocido Linux mejor por dentro, evitando la presencia de automatizaciones y herramientas que nos abstraen del proceso en otras distribuciones. Conociendo el funcionamiento de los programas en Arch Linux, se puede saber cómo funcionan por debajo ciertos aspectos en distribuciones como Ubuntu, Debian y Fedora, y también echar un vistazo a lo que está por llegar, ya que siempre se reciben las últimas versiones estables de los programas poco después de publicarse. Hemos aprendido a construir un sistema con una base de consola que no tiene uno, sino tantos escritorios como queramos instalarle, unos más accesibles que otros, y varios lectores de pantalla que coexisten en un mismo sistema. A pesar de todos los temas abarcados, este tutorial sólo araña la superficie. Los paquetes que se han instalado, así como sus dependencias, tienen montones de funciones extra que se pueden explorar, y existen muchos más paquetes y programas que no se han documentado aquí. Arch evoluciona rápidamente, por lo que no sería de extrañar que este texto se quede obsoleto pronto. Lo que acabas de leer no se parece nada a la primera versión de este tutorial, escrita en el año 2015. En aquella época, la instalación era más compleja que ahora, y el resultado menos accesible. Deshabilitar el servicio espeakup era obligatorio para usar Orca, ya que entraban en conflicto compitiendo por el dispositivo de audio, por ejemplo. Ahora ya sabes cómo instalar Arch en una máquina virtual, pero a lo largo de las distintas secciones se han dado trucos para crear un pen drive con un sistema para llevar, o realizar la instalación en un ordenador real. ¿Te animas a hacerlo? ¿Ya lo has hecho? No dudes en compartir tu experiencia, y contarnos qué ventajas y desventajas observas respecto a otros sistemas. ¡Gracias por leer!

Fuentes de información

Este tutorial no habría sido posible sin consultar las siguientes fuentes:

  1. La guía de instalación de Arch Linux.
  2. La wiki de Arch, en la que he leído tantas páginas distintas que no sabría enlazar todas.
  3. Tono de Grub de Mario Bross.
  4. Diferencias entre Chromium y Google Chrome.
  5. Uso de Orca con Chromium.
  6. Páginas de manual, la información que devuelven muchos comandos al pasar –help como argumento, y los comentarios que se encuentran en los archivos de configuración.
  7. Varios años experimentando de forma ininterrumpida.

Anexo: creación de una imagen lista para grabar y arrancar

A lo largo de este tutorial se han dado consejos útiles para preparar una unidad extraíble. El procedimiento es muy similar al de instalación en local, pero teniendo en cuenta que systemd y algunos comandos no funcionan, y que no se debe iniciar ningún servicio. En este capítulo explicaremos todo aquello que no se ha contado antes relacionado con la creación de imágenes listas para grabar, llevar a cualquier parte y arrancar.

Creación del archivo de imagen

Para crear un archivo de imagen totalmente vacío, se puede hacer uso de la utilidad dd. Con ella, creamos un archivo del tamaño que queramos y lo llenamos de ceros. Por ejemplo, este comando preparará un archivo cuyo tamaño es muy similar al de un pen drive de 32 GB: dd if=/dev/zero of=archlinux.img bs=4M count=7629 status=progress Tan pronto como dd termine, podremos particionarlo como se vio más arriba. Podemos omitir la partición swap. Si el sistema llegara a necesitarla, el rendimiento se reduciría drásticamente: gdisk archlinux.img Una vez escribimos la tabla de particiones, podemos montar la imagen como si fuera un disco real: losetup -P /dev/loop0 archlinux.img En este caso, loop0 es el dispositivo donde irá montada la imagen. Si loop0 no está disponible, podemos recurrir a loop1, y así sucesivamente. Las particiones se montarán como loop0p1, loop0p2, etc. Para desmontar la imagen, se debe ejecutar un comando como este después de desmontar todos los sistemas de archivos: losetup -d /dev/loop0

Preparación para la nube

Nunca sabemos dónde puede acabar la imagen que hemos creado. Prepararla para que se ejecute en cualquier parte puede ser buena idea, incluso si se configura para su uso en un proveedor de nube. Para ello, instalaremos el paquete cloud-init con alguna de sus dependencias extra: pacman -S --noconfirm --needed cloud-init python-passlib Y habilitaremos los dos servicios que ofrece, sin iniciarlos: systemctl enable cloud-init cloud-init-local El paquete cloud-init tiene una dependencia opcional, cloud-guest-utils: pacman -S --noconfirm --asdeps --needed cloud-guest-utils Esta dependencia es de especial relevancia, ya que una de sus utilidades permite aumentar el tamaño de la partición indicada hasta llenar todo el espacio que pueda en el disco. Si grabamos la imagen en una unidad cuyo tamaño es superior al disco grabado, podremos disponer del espacio sobrante con un par de comandos. El primero es growpart, que aplicaremos a la partición formateada en ext4. Imaginemos que es la segunda del disco: growpart /dev/nvme0n1 2 Y luego, resize2fs adapta el sistema de archivos al nuevo tamaño: resize2fs /dev/nvme0n1p2 Ten en cuenta que cloud-init generará una nueva clave para OpenSSH en el servidor la primera vez que se inicie, por lo que será necesario borrar la anterior del archivo known_hosts en los clientes. Si vas a distribuir tu imagen personalizada, instala y activa cloud-init.

Instalación de Arch Linux desde una copia en ejecución

En este tutorial hemos usado pacstrap, arch-chroot y mkfstab, entre otras utilidades. Todas ellas se pueden obtener instalando el paquete arch-install-scripts. De hecho, es indispensable para realizar la instalación en la imagen: pacman -S --noconfirm --needed arch-install-scripts Si usas una copia instalada de Arch para preparar otro disco y no arrancas desde la imagen iso, recuerda desmontar tu propia partición swap antes de ejecutar el comando genfstab.

Actualización de la caché de PackageKit

Al instalar paquetes, podemos ver que uno de los hooks falla porque systemd no se encuentra en ejecución en el entorno al que hemos entrado con chroot. Se puede ejecutar el siguiente comando para mantener la caché al día: /usr/lib/pk-offline-update

Preparación de la imagen para su distribución

A pesar de las velocidades actuales de conexión, 32 GB son muchos GB, y la mitad, también. Debemos preparar nuestra imagen para que ocupe el mínimo espacio posible al comprimirla, y por supuesto, comprimirla al acabar. Para ello, podemos hacer uso de las utilidades e4defrag y sfill. Los sistemas de archivos deben estar montados. En modo chroot, limpia las cachés de pacman y yay de todas las cuentas de usuario. El comando yay -scc desde la cuenta “usuario” debería ser suficiente si has seguido los pasos de este tutorial. La utilidad e4defrag ya viene instalada en el sistema. Podemos aplicarla sobre la partición ext4 de la imagen y, regularmente, sobre nuestro propio disco duro: e4defrag /dev/loop0p2 En cuanto a sfill, se instala con el paquete thc-secure-delete, disponible únicamente en el AUR. Este paquete contiene utilidades para borrar archivos sin dejar rastro, grabando encima información aleatoria. Lo que nos interesa no es grabar datos aleatorios, sino ceros. De esa forma, se eliminarán los restos de ficheros ya borrados y quedará algo que ocupará mucho menos espacio al comprimirse. Para instalar secure-delete, desde una cuenta que no sea root, hacemos: yay -S --noconfirm secure-delete Ahora, le diremos a sfill que grabe ceros, haciendo una única pasada: sfill -f -z -l -l /mnt Y también en la partición de arranque: sfill -f -z -l -l /mnt/boot Teniendo la imagen completamente desmontada, ya podemos comprimirla: xz -9 --extreme -T 0 archlinux.img El archivo resultante, aunque es grande, resulta mucho más manejable. Y el ratio de compresión no dejará indiferente a nadie.
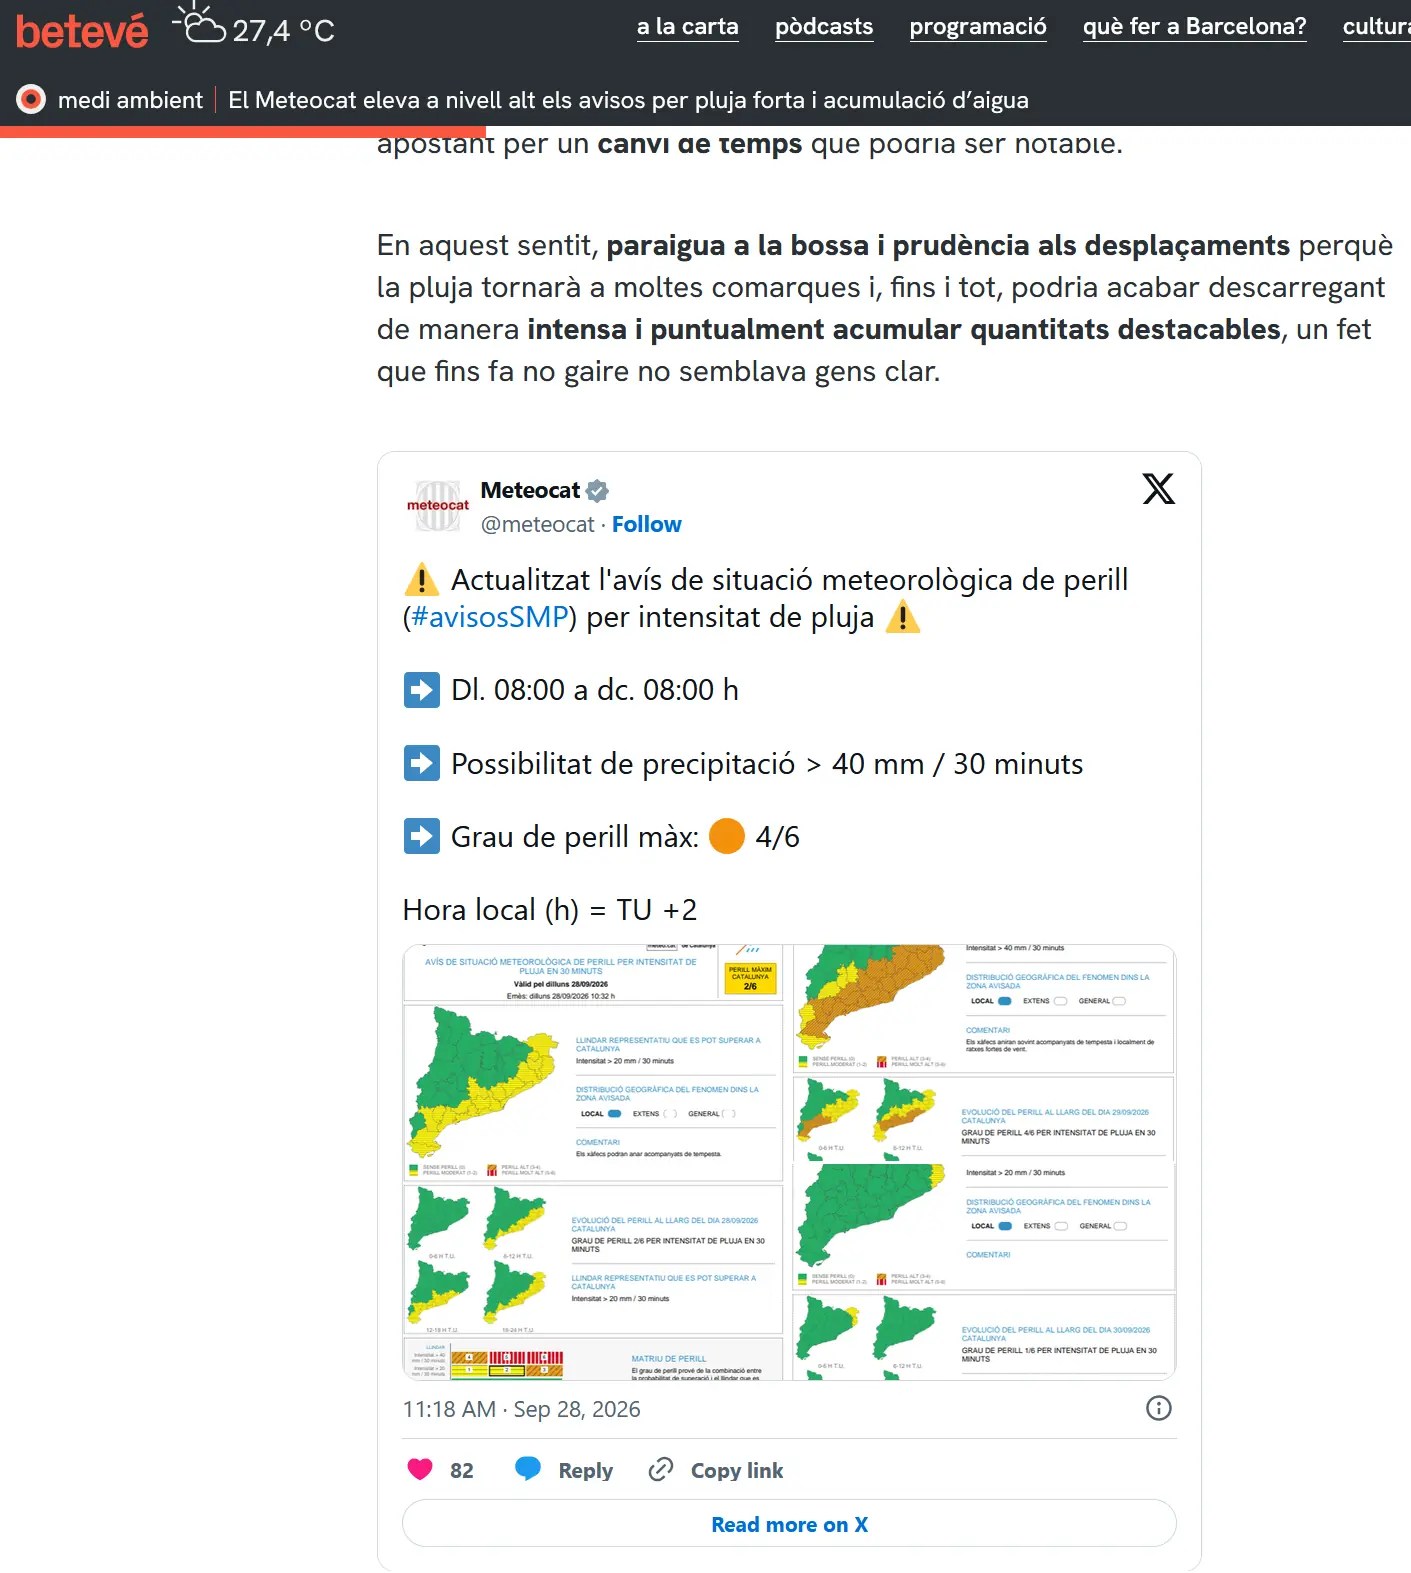
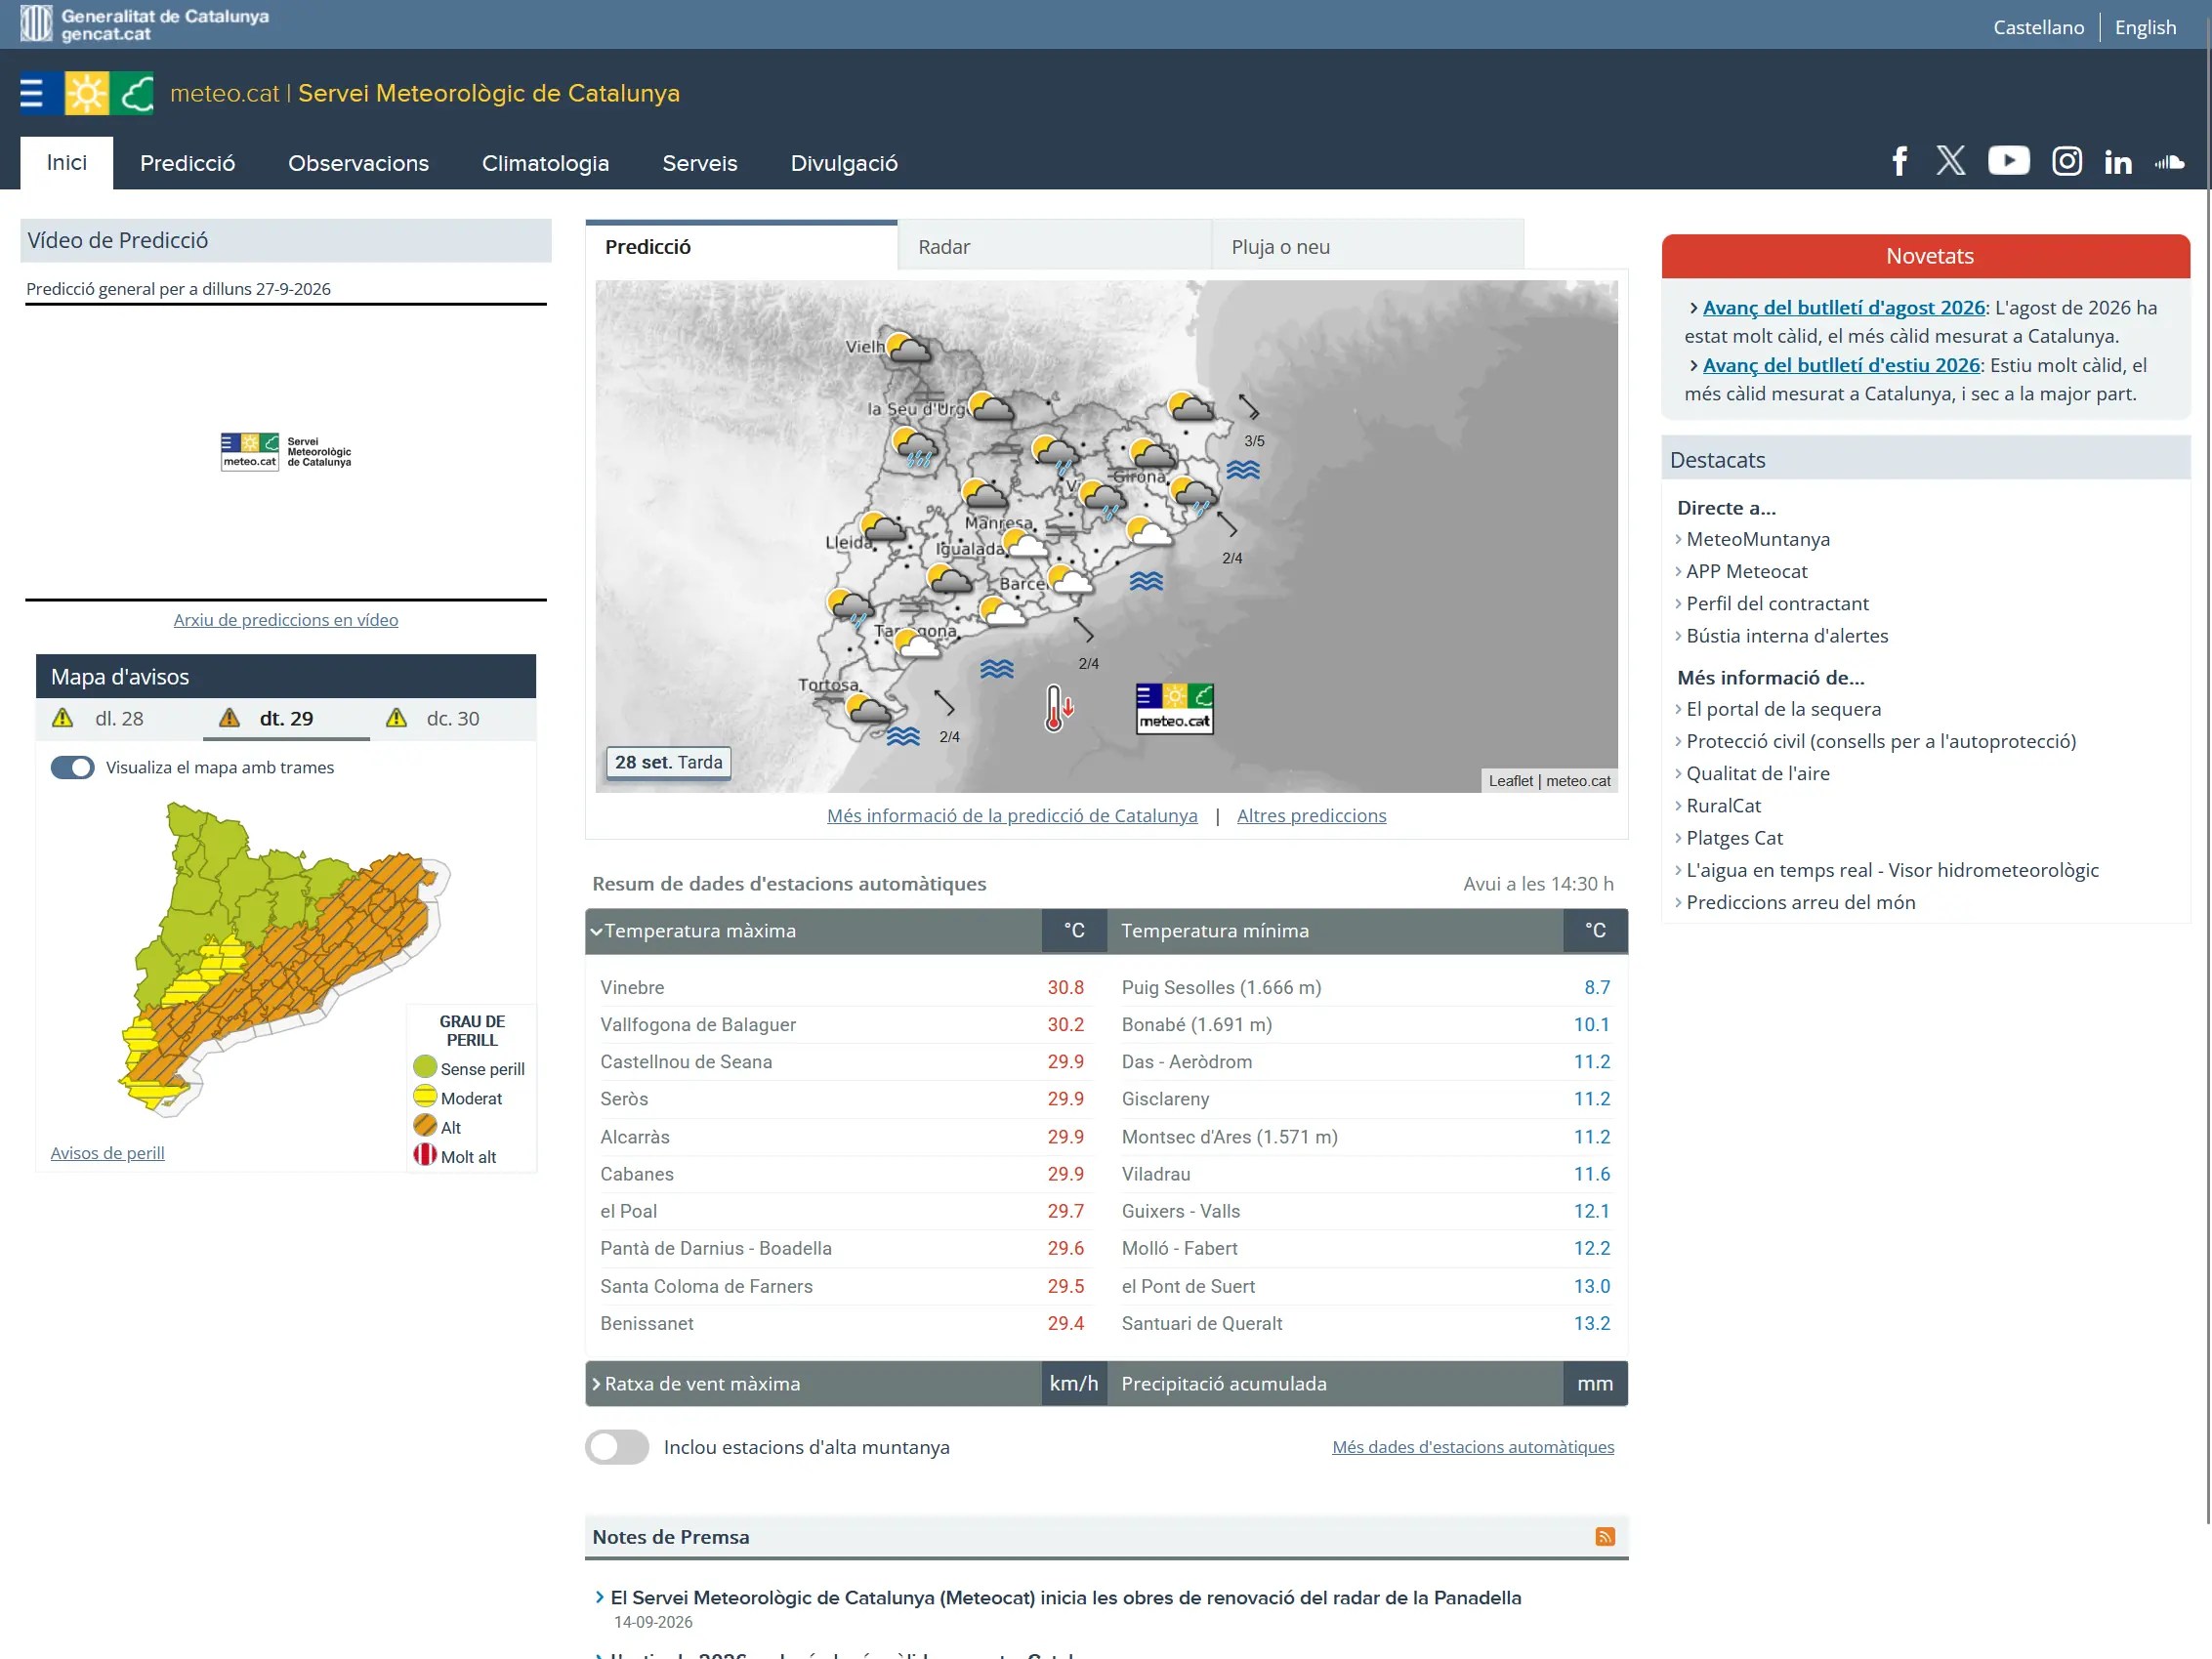
Tutorial: firma digital de correos electrónicos (Página de inicio on Un sitio solicitado por la comunidad, para la comunidad)

¡Hola a todos! Como todo el mundo sabe, existen muchos mecanismos para proteger nuestra cuenta de correo frente a invitados no deseados: una contraseña fuerte, métodos de autenticación de doble factor, preguntas de seguridad, etc. También existen mecanismos a nivel de servidor que previenen la suplantación de identidad: registros SPF, DKIM y DMARC. Estos últimos sólo nos interesan a los que tenemos dominios y servidores, y logran que un atacante malintencionado que desee suplantar la identidad de un usuario legítimo acabe en el buzón de correo no deseado de la víctima. Y todo ello de forma transparente, sin que el usuario tenga que hacer nada. Pero ¿cómo podemos proteger nuestros correos de la manipulación? ¿Podemos hacer algo para que un intermediario no vea lo que contienen? Ya nos conectamos usando conexiones https, indicando que los servidores imap y smtp van con conexión segura, pero a veces el intermediario malintencionado puede ser el propio servicio de correo. Como anécdota, hace unos 15 años una vecina de Cuba vino a casa porque quería enviarle a su hermana unas fotos de sus niños. La cuenta de correo de la hermana era de un dominio cubano. Las fotos salieron bien de aquí en PDF, pero llegaron distorsionadas. No fue ninguna sorpresa, ya que nos avisaron de que el régimen tenía por costumbre intervenir y manipular correos a conveniencia. La solución del momento fue cifrar el PDF con contraseña, y transmitir la contraseña por una vía alternativa. Misteriosamente, al hacerlo así, llegaron bien. Si eso sucediera hoy, podríamos aplicar una solución mucho mejor: una firma digital. Las firmas digitales en los correos no tienen nada que ver con las firmas que a veces vemos al pie de los mismos. Las primeras garantizan la autenticidad del origen y la integridad del contenido, y las segundas contienen lo que el remitente quiere que veamos. Existen dos métodos para firmar digitalmente un correo:

  • S/MIME: es compatible con casi todos los programas de correo existentes. Consiste en una clave privada generada en local, y un certificado expedido por una autoridad de certificación. Los certificados más comunes, que incluyen la identidad del remitente, cuestan dinero. Sin embargo, los que veremos aquí son gratis y cambian el método de generación un poco.
  • OpenPGP: se trata de un sistema descentralizado donde tú generas tus propias claves privada y pública. En vez de disponer de una autoridad de certificación que nos avale, son los propios destinatarios los que deciden cuánto confían en nuestra clave. La mayoría de programas de correo suelen necesitar algún tipo de complemento para trabajar con esta tecnología. Thunderbird, desde su versión 78, lleva ya el soporte integrado. Hablaremos de ello otro día si os interesa.

Hecha esta breve introducción, vamos a ver cómo obtener un certificado de firma de correo con Actalis y cómo instalarlo en Thunderbird. Actalis es una de las pocas entidades certificadoras que nos ofrece certificados gratuitos durante un año para todas las cuentas que queramos. Está reconocida por todos los navegadores y sistemas operativos. Yo llevo varios años con ellos, y gracias a la ayuda de un buen amigo y un poco de ruido, conseguimos que cambiasen su captcha inaccesible por Recaptcha.

Obtención del certificado

  1. Accede al formulario de solicitud. Está en inglés, pero eso no será un problema.
  2. Introduce tu correo electrónico en el único cuadro de edición que hay en la página, resuelve el captcha y envía el formulario.
  3. Recibirás un correo electrónico en italiano y en inglés con un código de verificación. Copia el código y pégalo en el cuadro de edición destinado a tal efecto.
  4. Marca las casillas indicando que aceptas los términos del servicio y pulsa el botón que envía este nuevo formulario.
  5. En la página de confirmación hay una contraseña. Cópiala y consérvala en un lugar seguro, la necesitarás más adelante.
  6. Recibirás otro correo, en italiano y en inglés, con un archivo adjunto. En ese archivo van tanto la clave privada como el certificado, cifrados en formato pfx. La contraseña que lo descifra es la que copiaste en el paso anterior.
  7. Descomprime el archivo zip en una carpeta de tu disco duro. Quedará el archivo con extensión .pfx.

Instalación del certificado en Mozilla Thunderbird

El certificado que acabamos de recibir se puede abrir directamente e instalar en Windows con un asistente muy sencillo. Al hacerlo, quedará disponible en aplicaciones tales como Outlook, el correo de Windows y también Thunderbird. Sin embargo, en este dará algunos problemas. Por lo tanto, lo importaremos en el almacén de Mozilla, donde todo funciona bien. Así, además, al copiar el perfil a otros equipos o usarlo en modo portable, el certificado se vendrá con nosotros estemos donde estemos.

  1. En Thunderbird, ve al menú Herramientas, y pulsa enter sobre Ajustes.
  2. En el cuadro de búsqueda, escribe Certificados y pulsa enter de nuevo.
  3. Tabula hasta el botón “Administrar certificados” y actívalo.
  4. Asegúrate de que está seleccionada la pestaña “Sus certificados”. Si no lo está, puedes activar el modo exploración de NVDA y seleccionarla con flechas y enter.
  5. Pulsa el botón Importar. En el diálogo que se carga, busca el archivo .pfx extraído en la sección anterior.
  6. Introduce la contraseña que descifra el archivo pfx. El certificado aparecerá en el árbol, listo para usar durante un año. Si es necesario, Thunderbird permite salvarlo junto con la clave privada, y cifrarlo con otra contraseña distinta.
  7. Pulsa Aceptar para cerrar el diálogo de certificados, y control+w para cerrar las preferencias y regresar a la bandeja de entrada.

Vinculación de la cuenta con el certificado

Ahora, debemos indicar a Thunderbird que nuestra cuenta de correo tiene asociado ese certificado. De lo contrario, no sabrá que puede usarlo.

  1. Ve al menú Herramientas, y pulsa Intro sobre Configuración de la cuenta.
  2. Selecciona tu cuenta en el árbol, si no lo estaba ya. Después, tabula hasta el botón Administrar identidades y actívalo.
  3. En la lista, selecciona la identidad cuyo correo va asociado al certificado. Normalmente debería haber una sola identidad. Después, pulsa el botón Editar.
  4. En el nuevo diálogo que se muestra, selecciona la pestaña “Cifrado de extremo a extremo”. Puedes activar el modo exploración, navegar con las flechas y pulsar enter.
  5. Al tabular hasta el grupo “S/MIME”, verás un botón Seleccionar. Púlsalo para elegir tu certificado de firma.
  6. En el cuadro combinado se mostrarán sólo los certificados que puedes usar para firmar correos con tu dirección. Es raro que haya más de uno, pero puede suceder. Elige el que más te convenga y acepta.
  7. Thunderbird preguntará si quieres usar el mismo certificado para cifrar correos. Si es así, responde que sí.
  8. El resto de casillas del diálogo se pueden configurar según tus gustos. A mí me gusta mantener los correos sin cifrar, pero que vayan firmados por defecto. Para ello, se puede marcar la casilla “Firmar mensajes sin cifrar” y marcar el botón de opción “Desactivar cifrado para mensajes nuevos”. Si tenemos tanto S/MIME como OpenPGP disponibles, puede ser buena idea elegir la opción “Preferir S/MIME”.
  9. Pulsa los botones Cerrar o Aceptar en todos los diálogos, y control+w para cerrar la configuración de la cuenta.

Creación de un correo firmado

Me encantaría extenderme en esta sección y llenarla de complicados pasos que justifiquen por qué casi nadie firma sus correos, pero es que no se puede. Marcando la casilla del paso 8 de la sección anterior termina todo. Todos los correos que enviemos irán firmados de serie. Cuando pase un año y el certificado caduque, Thunderbird fallará y dirá que el certificado ya no es válido. En ese momento, habrá que eliminarlo y repetir este tutorial paso a paso. Ahora bien, ¿qué pasa si la firma no está activada por defecto, o queremos desactivarla para que un correo se envíe sin firmar? En ocasiones, sabemos que un correo va a ser manipulado sí o sí. Por ejemplo, cuando lo enviamos a una lista de correo. Los destinatarios recibirán una alerta indicando que el mensaje ha sido manipulado y pueden asustarse, por lo que nos interesa quitar la firma. En la ventana de redacción del mensaje, aparecerá un nuevo menú en la barra de menú llamado “Seguridad”. En él, la opción que nos interesa se llama “Firmar digitalmente”, y puede estar marcada o desmarcada. Si está desmarcada, el mensaje no se firmará.

Verificación de la firma de un correo recibido

Al recibir un correo firmado, Thunderbird almacenará el certificado del remitente en su propio almacén, dentro de la sección “Otras personas”. Esto nos vendrá bien más adelante para cifrar. Si recorremos la ventana del mensaje con el tabulador, llegaremos a sus cabeceras. En ellas, un botón llamado S/MIME nos informará del estado de la firma y el cifrado, si lo hay. Si el mensaje ha sufrido alguna manipulación mientras viajaba por la red, lo sabremos al instante.

Creación de un mensaje cifrado

Hasta ahora hemos visto cómo garantizar la integridad de un mensaje. Sin embargo, ¿qué pasa si también queremos que nadie, salvo el destinatario, pueda verlo? En ese caso, debemos cifrarlo. En la ventana de creación de mensajes, en el menú Seguridad, también hay una opción para cifrar, pero tiene truco: aunque esté marcada, sólo funcionará si el certificado del destinatario está en la sección “Otras personas” del almacén y sigue siendo válido. De lo contrario, Thunderbird avisará con un error. El cifrado de mensajes es asimétrico: ciframos el contenido con la clave pública del destinatario (su certificado). El destinatario, por su parte, descifrará el mensaje con la clave privada correspondiente, que sólo tiene él. Nadie más podrá saber qué contiene. Del mismo modo, si quiere respondernos cifrando el mensaje, deberá tener nuestro certificado.

Conclusiones

En este tutorial hemos visto una de las tecnologías más usadas a nivel empresarial para firmar y cifrar mensajes de correo electrónico: S/MIME. Hemos visto cómo obtener un certificado que durará un año, y que después puede seguir renovándose por otro año totalmente gratis. Sin embargo, la cosa no acaba aquí: no hemos hablado de OpenPGP, y sólo se ha explicado la configuración en Thunderbird. ¿Qué tal si lo ampliamos para hablar de OpenPGP y otros clientes de correo? Tal vez, próximamente, haya una segunda parte.